OpenAI publie Privacy Filter, un modèle ouvert pour supprimer les données personnelles des textes
OpenAI a publié Privacy Filter, un modèle ouvert qui supprime automatiquement les données personnelles (PII) des textes. Malgré ses 1,5 milliard de paramètres, seuls 50 millions sont réellement mobilisés : le modèle s'exécute directement dans le navigateur via WebAssembly, sans infrastructure serveur. Il repère noms, adresses, numéros de téléphone et pièces d'identité, puis les remplace par des balises standard comme [NOM] ou [ADRESSE]. Il convient aux déploiements auto-hébergés et aux pipelines CI/CD.
Traité par IA depuis MarkTechPost ; édité par Hamidun News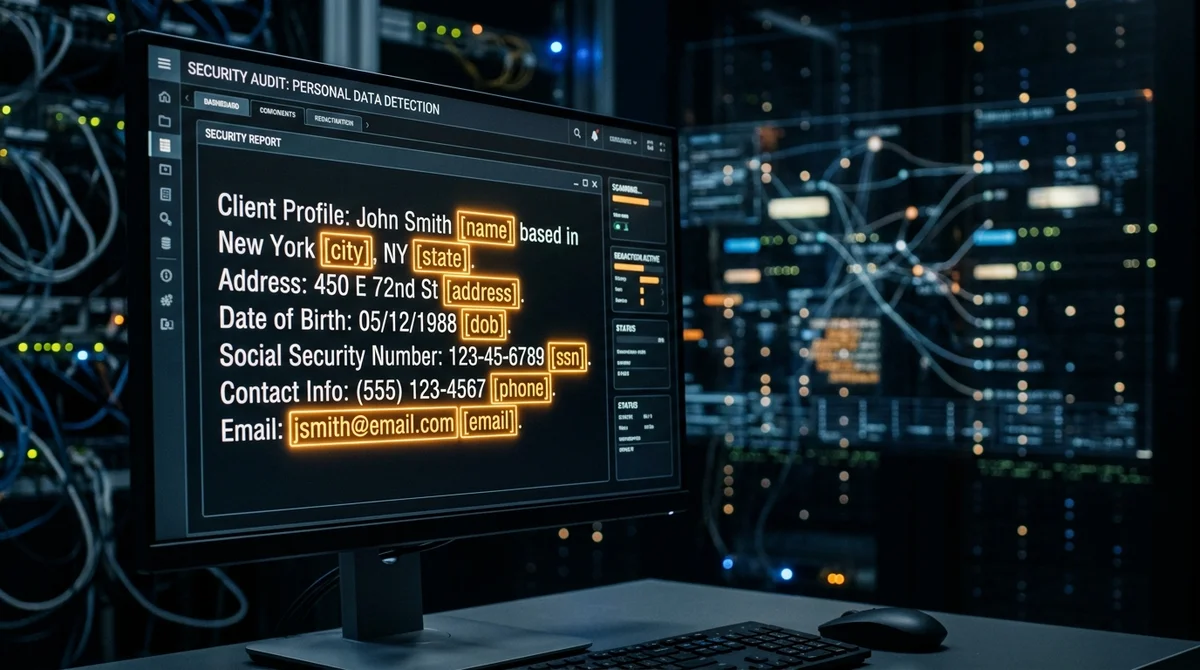
OpenAI a publié Privacy Filter, un modèle ouvert fondé sur un décodeur distillé, qui repère et supprime les données personnelles (PII) dans les textes. Bien que ses poids totalisent 1,5 milliard de paramètres, seuls 50 millions sont actifs lors de l'inférence, ce qui permet de l'exécuter directement dans le navigateur, sans infrastructure serveur.
Qu'est-ce que Privacy Filter
Privacy Filter est un modèle de langage spécialisé dans une seule tâche : détecter et caviarder automatiquement les données personnelles (Personally Identifiable Information, PII) dans un texte. Ce n'est pas un assistant conversationnel généraliste, mais un outil utilitaire, centré exclusivement sur la recherche d'informations sensibles et leur remplacement par des balises standardisées.
Cette spécialisation est un atout : un modèle étroitement ajusté s'acquitte mieux de la tâche que les LLM généralistes, qui laissent souvent passer des données personnelles formulées de façon inhabituelle ou se trompent dans les contextes complexes.
Le modèle repose sur un décodeur distillé : un grand modèle enseignant transmet ses connaissances à un modèle élève compact par distillation. Résultat : une grande précision de détection pour des besoins de calcul nettement moindres. Le modèle est disponible en accès libre : toute entreprise peut l'intégrer à ses propres pipelines sans envoyer de données aux serveurs d'OpenAI.
Architecture : 50 millions sur 1,5 milliard
Le détail technique clé est l'écart entre le nombre total de paramètres (1,5 milliard) et ceux qui sont réellement activés pour traiter chaque token (50 millions). Cette approche est typique des architectures à activation parcimonieuse : différents blocs neuronaux se spécialisent dans différents aspects de la tâche et s'activent de façon sélective, selon les données d'entrée.
Privacy Filter devient ainsi un outil pratique dans les scénarios où les ressources sont limitées :
- Navigateur : compatible avec WebAssembly et ONNX, les données ne quittent pas l'appareil de l'utilisateur
- Appareils edge : 50M de paramètres actifs permettent de fonctionner sans GPU sur des ordinateurs portables et des smartphones
- Auto-hébergé : le modèle tient entièrement dans l'infrastructure de l'entreprise
- Pipelines CI/CD : inférence rapide, sans dépendance au cloud ni coûts supplémentaires
Ce qu'il sait détecter
Privacy Filter reconnaît un large éventail de catégories de données personnelles, couvrant les exigences clés du RGPD, de la LGPD et du CCPA :
- Noms, prénoms, initiales (y compris la reconnaissance contextuelle sans marqueurs explicites)
- Adresses, codes postaux, coordonnées géographiques
- Numéros de téléphone et adresses e-mail
- Pièces d'identité : passeports, SSN, INN (numéro d'identification fiscale russe), permis de conduire
- Données financières : numéros de cartes et de comptes bancaires
- Identifiants médicaux
Le modèle ne se contente pas de signaler les fragments de PII : il les remplace aussi par des balises standard : [NOM], [ADRESSE], [TÉLÉPHONE]. Le texte en sortie est immédiatement prêt pour la suite du traitement, sans post-traitement manuel.
Contexte réglementaire
La pression réglementaire sur les données personnelles augmente partout dans le monde. Le RGPD en Europe, la LGPD au Brésil et le CCPA en Californie exigent tous des entreprises un traitement rigoureux des informations sensibles. La plupart des solutions commerciales d'anonymisation automatique étaient soit de qualité insuffisante, soit imposaient d'envoyer les données dans le cloud, ce qui allait en soi à l'encontre de la logique de confidentialité.
Privacy Filter comble ce vide : un modèle ouvert, compatible avec le navigateur, qu'une petite équipe peut intégrer à un produit en une journée sans sacrifier la confidentialité des utilisateurs.
Ce que cela signifie
OpenAI investit de façon constante dans l'infrastructure ouverte, parallèlement à ses produits commerciaux phares. Privacy Filter montre que l'entreprise voit un marché non seulement dans l'accès API à GPT, mais aussi dans des outils utilitaires répondant à des besoins opérationnels précis. C'est un signal pour le secteur : les outils open source de niveau entreprise pour la sécurité des données en IA deviennent la norme.
Pour les entreprises, c'est une solution prête à l'emploi pour l'anonymisation, sans développement from scratch et sans dépendance au cloud.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Qu'est-ce que Privacy Filter?
Privacy Filter est un modèle de langage spécialisé dans une seule tâche : détecter et caviarder automatiquement les données personnelles (Personally Identifiable Information, PII) dans un texte. Ce n'est pas un assistant conversationnel généraliste, mais un outil utilitaire, centré exclusivement sur la recherche d'informations sensibles et leur remplacement par des balises standardisées. Cette spécialisation est un atout : un modèle étroitement ajusté s'acquitte mieux de la tâche que les LLM généralistes, qui laissent souvent passer des données personnelles formulées de faç
Que sait-on sur Architecture : 50 millions sur 1,5 milliard ?
Le détail technique clé est l'écart entre le nombre total de paramètres (1,5 milliard) et ceux qui sont réellement activés pour traiter chaque token (50 millions). Cette approche est typique des architectures à activation parcimonieuse : différents blocs neuronaux se spécialisent dans différents aspects de la tâche et s'activent de façon sélective, selon les données d'entrée. Privacy Filter devient ainsi un outil pratique dans les scénarios où les ressources sont limitées : Navigateur : compatible avec WebAssembly et ONNX, les données ne quittent pas l'appareil de l'utilisa
Que sait-on sur Ce qu'il sait détecter ?
Privacy Filter reconnaît un large éventail de catégories de données personnelles, couvrant les exigences clés du RGPD, de la LGPD et du CCPA : Noms, prénoms, initiales (y compris la reconnaissance contextuelle sans marqueurs explicites) Adresses, codes postaux, coordonnées géographiques Numéros de téléphone et adresses e-mail Pièces d'identité : passeports, SSN, INN (numéro d'identification fiscale russe), permis de conduire Données financières : numéros de cartes et de comptes bancaires Identifiants médicaux Le modèle ne se contente pas de signaler les fragments de PII : i
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.