AWS SageMaker ajoute une surveillance complète des LLM en production
AWS a intégré une surveillance complète des LLM dans SageMaker AI. Les nouveaux tableaux de bord Grafana suivent l'utilisation des GPU, la vitesse de traitement des tokens et la qualité des réponses. La fonctionnalité vise la production avec des modèles populaires comme Llama, Mistral et Claude.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News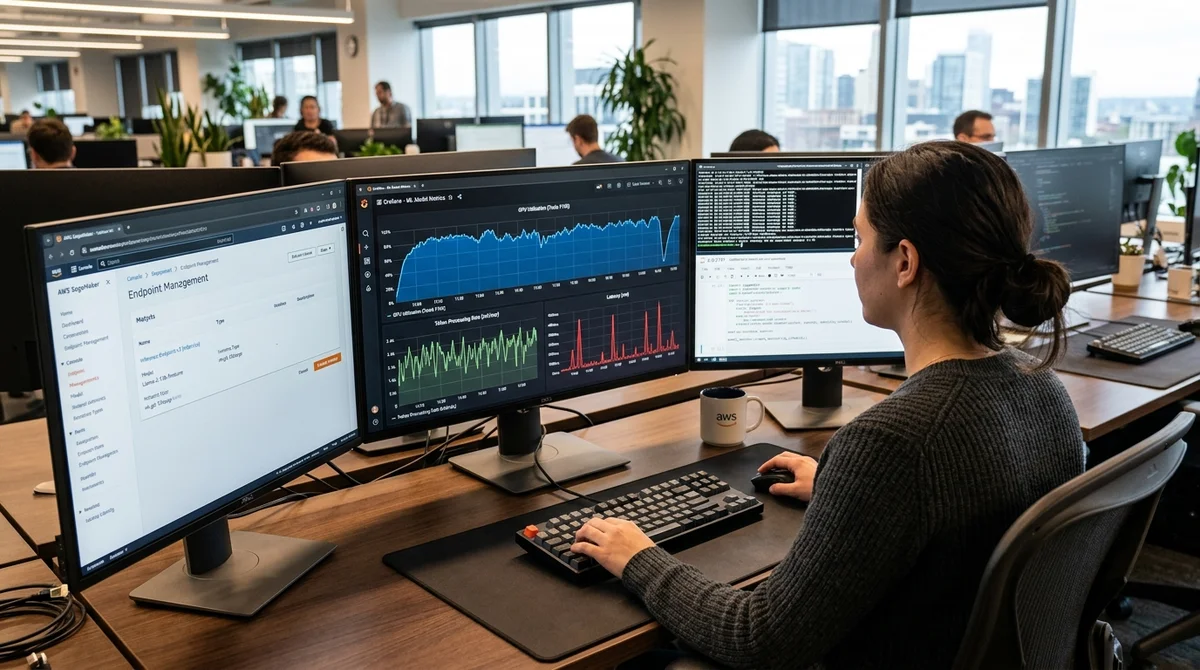
AWS a ajouté une surveillance globale pour les LLM exécutés sur la plateforme SageMaker AI. Avec Amazon Managed Grafana, il est désormais possible de suivre à la fois des métriques techniques (utilisation des GPU, latence) et des indicateurs de qualité (précision des réponses, hallucinations).
Ce qui est surveillé
AWS distingue deux catégories de métriques. La première concerne les ressources : utilisation des cartes graphiques, consommation de mémoire et nombre de tokens traités par seconde. La seconde porte sur la qualité du modèle : latence de réponse, précision de la génération, présence d'hallucinations et respect des instructions d'origine.
Les nouveaux tableaux de bord collectent automatiquement les données des endpoints SageMaker et les affichent en temps réel. C'est important : en production, il ne suffit pas de voir que « le serveur fonctionne » ; il faut aussi savoir que « le modèle répond correctement ».
Les métriques intégrées comprennent :
- Utilisation des GPU et de la mémoire
- Vitesse de traitement des tokens entrants et sortants
- Latence (le délai entre la requête et la réponse du modèle)
- Toxicité et hallucinations dans la sortie
- Respect des instructions et métriques de conformité (compliance)
Pourquoi c'est important
Un LLM en production, ce n'est pas simplement du matériel allumé qui tourne. Le modèle peut se charger et le processeur peut être actif, mais la qualité des réponses peut rester faible. Le modèle peut donner de mauvaises réponses, être lent ou apprendre un comportement indésirable.
Jusqu'ici, les ingénieurs devaient intégrer à la main la journalisation dans Prometheus, ELK ou d'autres systèmes de surveillance. Cela demandait du temps et une connaissance approfondie des métriques. Désormais, l'outil est intégré directement à SageMaker.
AWS propose des modèles de tableaux de bord prêts à l'emploi pour les modèles populaires : Llama, Mistral, Claude et d'autres. Un ingénieur peut déployer la surveillance en quelques clics, sans écrire de code personnalisé.
Quand c'est utile
Une surveillance complète est critique lorsqu'un LLM sert de vrais utilisateurs ou soutient des processus métier importants. Exemples : un chatbot d'assistance client, un assistant IA d'analyse de documents, un générateur automatique de contenu, un assistant de recherche dans une base de connaissances.
Si le modèle se met à produire des réponses plus longues, étranges ou moins utiles, les métriques le montrent avant l'arrivée des plaintes des utilisateurs. Une chute inattendue de l'utilisation des GPU peut signaler des problèmes dans la file de requêtes ou un épuisement de la mémoire.
AWS souligne que l'observabilité n'est pas une solution provisoire,
mais le socle d'un déploiement fiable des LLM en production.
Ce que cela signifie
La surveillance des LLM devient peu à peu un standard, comme celle des applications web classiques. AWS la rend plus accessible en intégrant des outils d'observabilité prêts à l'emploi directement dans la plateforme SageMaker.
Pour les équipes d'ingénierie, cela veut dire moins de temps passé à écrire des scripts d'intégration sur mesure et davantage d'attention portée à la qualité des LLM eux-mêmes. Cela devrait accélérer le déploiement des solutions d'IA en production.
- 31 oct. 2026Worldwide Express confie ses factures litigieuses à des agents IA et réduit sa dette de 75%
- 30 oct. 2026AWS offre aux agents de codage un aperçu en direct du site, depuis leur session isolée
- 30 oct. 2026MoEngage ouvre 400 API privées à ses agents IA via AgentCore Gateway, sans serveurs MCP maison
- 29 oct. 2026NVIDIA Nemotron 3.5 Super VL : 120 milliards de paramètres, 12 milliards actifs, déploiement sur AWS
Questions clés sur cet article
Que sait-on sur Ce qui est surveillé ?
AWS distingue deux catégories de métriques. La première concerne les ressources : utilisation des cartes graphiques, consommation de mémoire et nombre de tokens traités par seconde. La seconde porte sur la qualité du modèle : latence de réponse, précision de la génération, présence d'hallucinations et respect des instructions d'origine. Les nouveaux tableaux de bord collectent automatiquement les données des endpoints SageMaker et les affichent en temps réel. C'est important : en production, il ne suffit pas de voir que « le serveur fonctionne » ; il faut aussi savoir que «
Pourquoi c'est important?
Un LLM en production, ce n'est pas simplement du matériel allumé qui tourne. Le modèle peut se charger et le processeur peut être actif, mais la qualité des réponses peut rester faible. Le modèle peut donner de mauvaises réponses, être lent ou apprendre un comportement indésirable. Jusqu'ici, les ingénieurs devaient intégrer à la main la journalisation dans Prometheus, ELK ou d'autres systèmes de surveillance. Cela demandait du temps et une connaissance approfondie des métriques. Désormais, l'outil est intégré directement à SageMaker. AWS propose des modèles de tableaux de
Quand c'est utile?
Une surveillance complète est critique lorsqu'un LLM sert de vrais utilisateurs ou soutient des processus métier importants. Exemples : un chatbot d'assistance client, un assistant IA d'analyse de documents, un générateur automatique de contenu, un assistant de recherche dans une base de connaissances. Si le modèle se met à produire des réponses plus longues, étranges ou moins utiles, les métriques le montrent avant l'arrivée des plaintes des utilisateurs. Une chute inattendue de l'utilisation des GPU peut signaler des problèmes dans la file de requêtes ou un épuisement de
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.