AWS montre comment affiner Amazon Nova avec le Nova Forge SDK et SageMaker Jobs
AWS détaille comment personnaliser Amazon Nova avec le Nova Forge SDK et SageMaker AI. Dans l'exemple, l'équipe entraîne un modèle à classer des questions Stack Overflow : le baseline n'atteint que 13 % d'exact match, le SFT le porte à 77,2 % et le RFT à 78,8 %, avec un quasi-EM de 80,6 %. Le guide couvre aussi le déploiement du modèle final sur un endpoint d'inférence.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News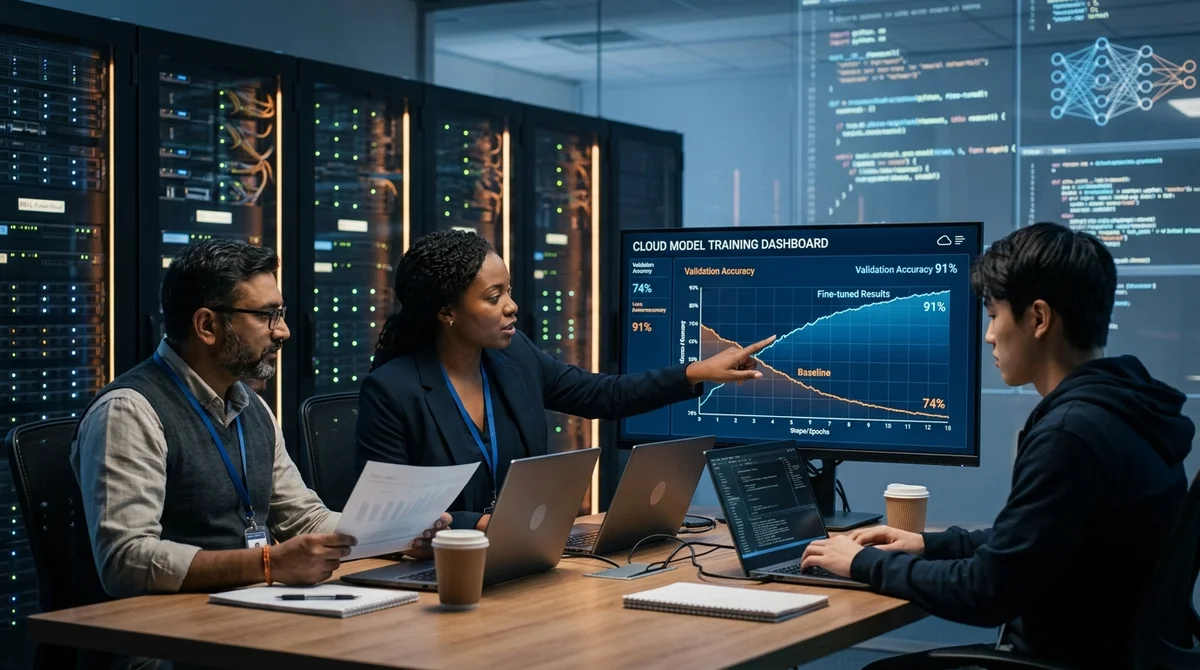
AWS a présenté un scénario pratique de personnalisation des modèles Amazon Nova avec le Nova Forge SDK et Amazon SageMaker AI. Dans le guide, l'équipe parcourt tout le cycle : de l'évaluation de base du modèle au SFT, au RFT, puis à la mise en production d'un endpoint d'inférence dédié.
Scénario et données
AWS présente le Nova Forge SDK comme une couche qui supprime la partie la plus fastidieuse de la personnalisation des LLM : préparer l'infrastructure, choisir les images, valider les configurations et lancer les recettes d'entraînement. Au lieu d'assembler le pipeline à la main, le développeur dispose de composants prêts à l'emploi pour charger le dataset, convertir son format, démarrer un job dans SageMaker, puis évaluer le résultat.
L'article le montre non pas sur un exemple jouet, mais sur une tâche appliquée concrète : classer automatiquement la qualité des questions Stack Overflow.
Pour l'expérience, AWS a pris le dataset Stack Overflow Question Quality, qui compte 60 000 questions de 2016–2020, et en a tiré au hasard 4700 enregistrements. Le modèle devait classer chaque question dans l'une de trois catégories : HQ, LQ_EDIT ou LQ_CLOSE. 3500 exemples ont été réservés au SFT et 500 à l'évaluation. Pour le RFT, AWS a utilisé 700 exemples spécialisés supplémentaires, complétés par les 3500 enregistrements du SFT afin que le modèle ne perde pas le format de réponse déjà appris.
Le déroulé de l'entraînement
L'expérience comporte quatre étapes : évaluation de base du Nova 2.0 préentraîné, puis supervised fine-tuning, ensuite reinforcement fine-tuning et, enfin, déploiement sur Amazon SageMaker AI Inference.
AWS utilise la classe `CSVDatasetLoader` pour charger les CSV, vérifier le schéma et transformer les données, et `SMTJRuntimeManager` pour lancer le calcul. Le SFT de l'exemple tourne sur quatre instances ml.p5.48xlarge, et le SDK peut valider à l'avance la compatibilité de l'environnement et des paramètres, pour que les erreurs n'apparaissent pas seulement après le démarrage du job.
- Le baseline montre le comportement du modèle sans affinage
- Le SFT enseigne le bon format et le schéma de réponse propre au domaine
- Le RFT affine la solution grâce à une fonction de récompense
- Le déploiement peut se faire soit sur Bedrock, soit sur SageMaker
Pour le RFT, AWS a ajouté une fonction de récompense simple via Lambda : +1 pour la bonne classe et -1 pour la mauvaise. L'affinage a été lancé sur le checkpoint du SFT, sur deux instances ml.p5.48xlarge, et l'exécution est restée courte : seulement 40 étapes. L'équipe a aussi limité la longueur de sortie et ajouté une pénalité KL pour que le modèle ne s'éloigne pas trop du comportement fixé pendant le SFT.
Autrement dit, le SDK n'est pas ici un simple habillage de lancement, mais un point unique pour préparer les données, entraîner, consulter les logs et déployer.
Ce que montrent les métriques
La partie la plus utile de l'article, ce sont les chiffres. Nova 2.0 de base n'a atteint que 13 % d'exact match sur la tâche à trois classes, où un tirage aléatoire donnerait environ 33,3 %. Même en ignorant la verbosité des réponses et en extrayant seulement l'étiquette de classe du texte, la précision était de 52,2 %. AWS l'explique par deux problèmes : le modèle écrivait trop volontiers de longues explications au lieu d'une seule étiquette, et il penchait vers la réponse HQ quelle que soit la qualité réelle de la question.
Après un SFT court, l'exact match est monté à 77,2 % et la précision de classification sur les étiquettes extraites à 79,0 %. La couche suivante, le RFT, a ajouté un peu : l'exact match a atteint 78,8 %, le quasi-EM 80,6 % et le F1 78,8 %. Le gain de l'étape de renforcement n'est pas gigantesque, mais il est régulier sur presque toutes les métriques clés.
AWS note également que le BLEU est presque inutile pour cette tâche : quand le modèle répond avec un seul token comme HQ ou LQ_CLOSE, l'exact match et le F1 comptent davantage que le recouvrement de n-grammes.
Ce que cela signifie
AWS ne cherche pas à vendre seulement un modèle de plus, mais un chemin plus court vers son adaptation à des usages concrets. Si le Nova Forge SDK couvre réellement la validation, le lancement, la supervision et le déploiement dans une seule interface, les équipes pourront tester plus facilement des hypothèses sur des datasets de niche sans parcours du combattant MLOps à chaque itération.
- 31 oct. 2026Worldwide Express confie ses factures litigieuses à des agents IA et réduit sa dette de 75%
- 30 oct. 2026AWS offre aux agents de codage un aperçu en direct du site, depuis leur session isolée
- 30 oct. 2026MoEngage ouvre 400 API privées à ses agents IA via AgentCore Gateway, sans serveurs MCP maison
- 29 oct. 2026NVIDIA Nemotron 3.5 Super VL : 120 milliards de paramètres, 12 milliards actifs, déploiement sur AWS
Questions clés sur cet article
Que sait-on sur Scénario et données ?
AWS présente le Nova Forge SDK comme une couche qui supprime la partie la plus fastidieuse de la personnalisation des LLM : préparer l'infrastructure, choisir les images, valider les configurations et lancer les recettes d'entraînement. Au lieu d'assembler le pipeline à la main, le développeur dispose de composants prêts à l'emploi pour charger le dataset, convertir son format, démarrer un job dans SageMaker, puis évaluer le résultat. L'article le montre non pas sur un exemple jouet, mais sur une tâche appliquée concrète : classer automatiquement la qualité des questions St
Que sait-on sur Le déroulé de l'entraînement ?
L'expérience comporte quatre étapes : évaluation de base du Nova 2.0 préentraîné, puis supervised fine-tuning, ensuite reinforcement fine-tuning et, enfin, déploiement sur Amazon SageMaker AI Inference. AWS utilise la classe `CSVDatasetLoader` pour charger les CSV, vérifier le schéma et transformer les données, et `SMTJRuntimeManager` pour lancer le calcul. Le SFT de l'exemple tourne sur quatre instances ml.p5.48xlarge, et le SDK peut valider à l'avance la compatibilité de l'environnement et des paramètres, pour que les erreurs n'apparaissent pas seulement après le démarrag
Que sait-on sur Ce que montrent les métriques ?
La partie la plus utile de l'article, ce sont les chiffres. Nova 2.0 de base n'a atteint que 13 % d'exact match sur la tâche à trois classes, où un tirage aléatoire donnerait environ 33,3 %. Même en ignorant la verbosité des réponses et en extrayant seulement l'étiquette de classe du texte, la précision était de 52,2 %. AWS l'explique par deux problèmes : le modèle écrivait trop volontiers de longues explications au lieu d'une seule étiquette, et il penchait vers la réponse HQ quelle que soit la qualité réelle de la question. Après un SFT court, l'exact match est monté à 77
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.