AWS explique comment affiner Amazon Nova avec un LLM juge pour des tâches d'entreprise complexes
AWS a montré comment utiliser le LLM-as-a-judge pour le reinforcement fine-tuning des modèles Amazon Nova. Au lieu d'un étiquetage manuel, un modèle distinct attribue des récompenses selon des critères de précision, de pertinence et de sécurité, et la fonction de récompense s'assemble avec Lambda et Bedrock. Dans un cas de démonstration sur la revue de contrats, Nova 2 Lite a obtenu 4,33 points après RFT, devancé Claude Sonnet 4.5 et conservé une validation parfaite du schéma JSON.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News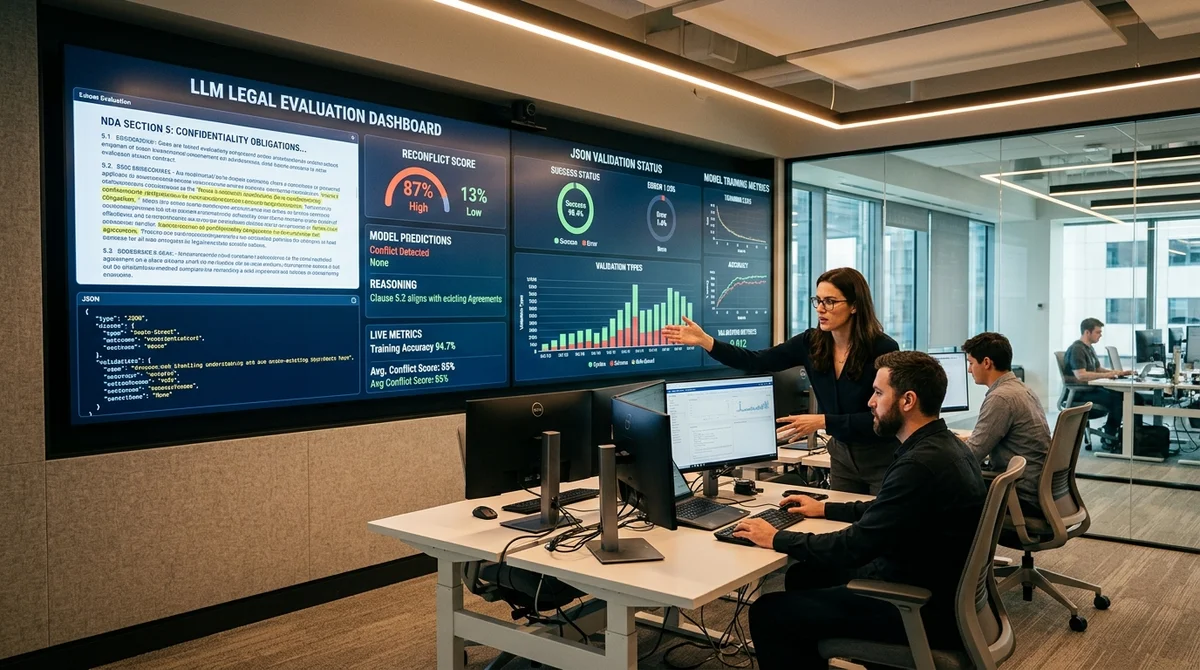
AWS a détaillé la manière d'appliquer le reinforcement fine-tuning avec l'approche LLM-as-a-judge aux modèles Amazon Nova. Au lieu d'un étiquetage manuel ou d'un ensemble de règles rigides, un modèle de langage distinct évalue la qualité de la réponse, et son verdict devient le signal de récompense pour l'entraînement.
Pourquoi un juge
Selon AWS, le RFT classique peut reposer soit sur des règles vérifiables, comme la correspondance exacte d'une chaîne, soit sur un schéma où un autre LLM évalue la réponse selon plusieurs critères à la fois. La seconde option sert lorsque la qualité ne se ramène pas à une formule unique.
Pour les tâches d'entreprise, la précision factuelle n'est pas seule en jeu : le ton, la sécurité, l'exhaustivité, la pertinence et la conformité aux politiques internes comptent aussi. Dans cette approche, le modèle juge ne se contente pas de donner une note : il aide aussi à comprendre pourquoi une réponse est meilleure qu'une autre. AWS souligne que ce schéma accélère les itérations : l'équipe voit précisément où le modèle décroche et peut corriger plus vite la fonction de récompense. C'est particulièrement utile dans les domaines où l'erreur ne ressemble pas à un bug évident, mais se niche dans les nuances de formulation, un risque omis ou une argumentation faible.
Six étapes de mise en place
AWS découpe le déploiement du LLM-as-a-judge en plusieurs étapes pratiques. Il faut d'abord choisir le type d'évaluation : rubric-based, où le juge attribue une note absolue à une seule réponse, ou preference-based, où il compare deux variantes et retient la meilleure. Faute de préférences toutes prêtes, l'entreprise conseille de commencer par l'approche par rubrique, avec de simples critères pass/fail plutôt qu'une échelle de 1 à 10.
- Choisir le mode de jugement : évaluation absolue ou comparaison par paires
- Rédiger clairement les critères de qualité, avec des signes observables
- Sélectionner le modèle juge selon le domaine et le budget via Amazon Bedrock
- Exiger une réponse JSON structurée afin que la récompense puisse être analysée de façon fiable
- Relier la fonction de récompense aux métriques de production et ajouter une couche Lambda robuste
AWS insiste particulièrement sur l'infrastructure. Elle conseille de ne pas se reposer uniquement sur le juge et de le compléter par des vérifications déterministes rapides : validité du JSON, longueur de la réponse, concordance de langue et filtres de sécurité. La Reward Lambda elle-même doit encaisser des milliers d'évaluations par étape d'entraînement ; AWS recommande donc un exponential backoff pour les appels à Bedrock, une parallélisation via ThreadPoolExecutor ou des patterns async, un timeout allant jusqu'à 15 minutes et une provisioned concurrency d'environ 100 pour les configurations types.
Si le juge ou l'API tombent, mieux vaut renvoyer une récompense neutre que de faire échouer toute l'étape d'entraînement. AWS conseille aussi de conserver un jeu de tests de régression pour le pipeline du juge lui-même.
Le cas des contrats
En guise de démonstration, AWS décrit un projet mené avec un partenaire du secteur juridique. La tâche consiste à analyser automatiquement de nouveaux contrats, à les comparer aux règles internes, aux contrats passés et aux exigences législatives, puis à produire un JSON avec des commentaires, des types de remarques et des actions recommandées.
Le jeu de données initial était réduit et contenait des contrats annotés par des experts ; le supervised fine-tuning classique n'apportait donc qu'un effet limité. Pour le RFT, l'équipe a utilisé un modèle juge distinct, GPT OSS 120B, et un system prompt personnalisé. Le juge vérifiait si le commentaire s'appuie réellement sur un passage du contrat lui-même, s'il est cohérent avec le document de référence et s'il permet d'agir. Le tout a ensuite été encapsulé dans une fonction Lambda, et l'entraînement a été lancé via le Nova Forge SDK, avec plusieurs générations par exemple et une limite de 100 appels concurrents.
Résultat : après RFT, Amazon Nova 2 Lite a obtenu un score agrégé de 4,33 sur 5 et une validation parfaite du schéma JSON, devançant Claude Sonnet 4.5 et Claude Haiku 4.5. AWS précise à part que les versions SFT présentaient des artefacts, comme des commentaires répétés et d'étranges caractères Unicode, ce qui n'était pas le cas des checkpoints RFT. Plus important encore, le modèle a conservé de bons résultats même après modification du judge prompt : il a donc appris des schémas de qualité plus généraux, et non une formule d'évaluation précise. L'inconvénient est lui aussi énoncé sans détour : le RFT a exigé de 4 à 8 rollouts par exemple d'entraînement et coûté plus cher en calcul.
Ce que cela signifie
AWS promeut de fait le RFT avec LLM-as-a-judge comme une voie praticable pour adapter les modèles à des scénarios d'entreprise sensibles, où les règles simples ne suffisent pas et où l'étiquetage manuel coûte trop cher. Si l'approche avec Amazon Nova se transpose réellement en production, les entreprises du juridique, de la finance et de la santé disposent d'un moyen d'affiner les modèles selon leurs propres standards tout en contrôlant mieux le format, la qualité et l'explicabilité des réponses.
- 31 oct. 2026Worldwide Express confie ses factures litigieuses à des agents IA et réduit sa dette de 75%
- 30 oct. 2026AWS offre aux agents de codage un aperçu en direct du site, depuis leur session isolée
- 30 oct. 2026MoEngage ouvre 400 API privées à ses agents IA via AgentCore Gateway, sans serveurs MCP maison
- 29 oct. 2026NVIDIA Nemotron 3.5 Super VL : 120 milliards de paramètres, 12 milliards actifs, déploiement sur AWS
Questions clés sur cet article
Pourquoi un juge?
Selon AWS, le RFT classique peut reposer soit sur des règles vérifiables, comme la correspondance exacte d'une chaîne, soit sur un schéma où un autre LLM évalue la réponse selon plusieurs critères à la fois. La seconde option sert lorsque la qualité ne se ramène pas à une formule unique. Pour les tâches d'entreprise, la précision factuelle n'est pas seule en jeu : le ton, la sécurité, l'exhaustivité, la pertinence et la conformité aux politiques internes comptent aussi. Dans cette approche, le modèle juge ne se contente pas de donner une note : il aide aussi à comprendre po
Que sait-on sur Six étapes de mise en place ?
AWS découpe le déploiement du LLM-as-a-judge en plusieurs étapes pratiques. Il faut d'abord choisir le type d'évaluation : rubric-based, où le juge attribue une note absolue à une seule réponse, ou preference-based, où il compare deux variantes et retient la meilleure. Faute de préférences toutes prêtes, l'entreprise conseille de commencer par l'approche par rubrique, avec de simples critères pass/fail plutôt qu'une échelle de 1 à 10. Choisir le mode de jugement : évaluation absolue ou comparaison par paires Rédiger clairement les critères de qualité, avec des signes observ
Que sait-on sur Le cas des contrats ?
En guise de démonstration, AWS décrit un projet mené avec un partenaire du secteur juridique. La tâche consiste à analyser automatiquement de nouveaux contrats, à les comparer aux règles internes, aux contrats passés et aux exigences législatives, puis à produire un JSON avec des commentaires, des types de remarques et des actions recommandées. Le jeu de données initial était réduit et contenait des contrats annotés par des experts ; le supervised fine-tuning classique n'apportait donc qu'un effet limité. Pour le RFT, l'équipe a utilisé un modèle juge distinct, GPT OSS 120B
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.