Habr AI
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
WisprFlow, Whisper y GigaAM: quién reconoce mejor el habla ruso-inglesa
El autor comparó cinco aplicaciones y cinco modelos de entrada de voz para mezcla ruso-inglesa y demostró cómo las soluciones open source locales ya pueden reemplazar a WisprFlow.
GPTunneL y la Tendencia Forbes: Por Qué las AI-Superapps Se Están Convirtiendo en el Nuevo Motor de Crecimiento del Mercado
GPTunneL, que ha crecido a 2 millones de usuarios, describe cómo las AI-superapps están cambiando el comportamiento de la audiencia, la demanda corporativa y la economía del mercado—desde China y EE.UU. hasta Rusia.
Habr mostró cómo entrenar una mini-LLM en C# usando ILGPU y gráficos AMD integrados
Habr publicó un desglose de cómo construir y entrenar una LLM minúscula en C# con ILGPU y OpenCL, exportarla a GGUF y ejecutarla en LM Studio incluso en gráficos AMD integrados.
Anthropic presenta Claude Mythos Preview mediante system card de 244 páginas en lugar de lanzamiento estándar
Anthropic presentó Claude Mythos Preview no como un lanzamiento típico, sino a través de una system card de 244 páginas que detalla las capacidades del modelo, riesgos y razones del acceso limitado.
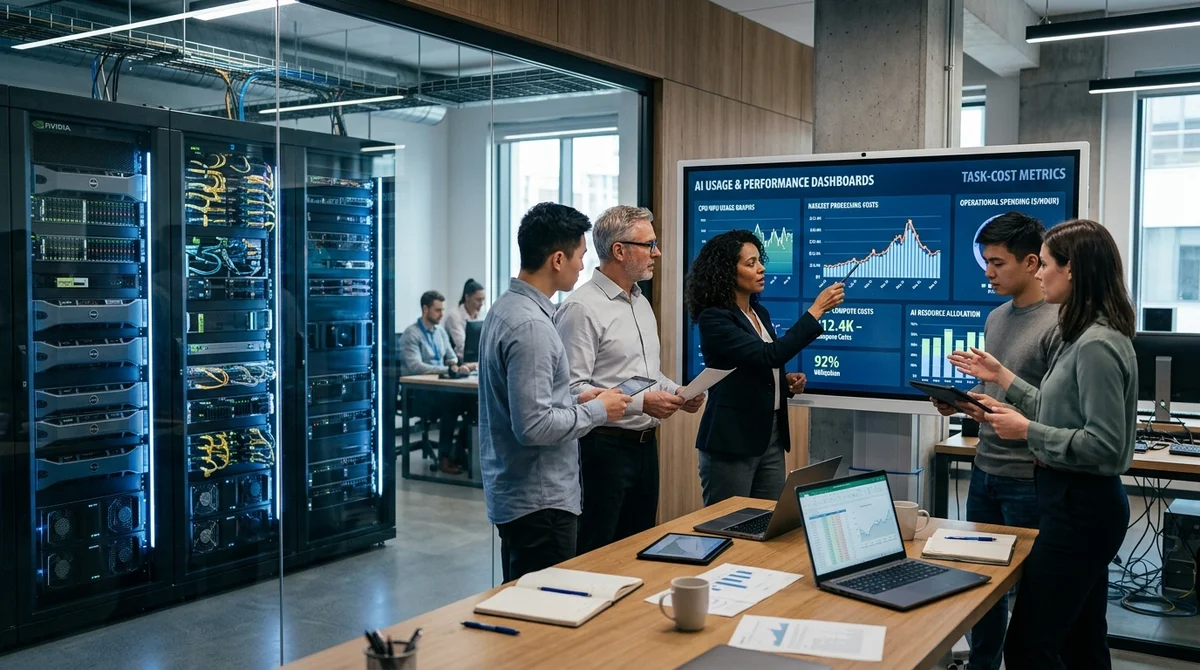
OpenAI y Anthropic modifican el cálculo de costos de modelos de lenguaje: en 2026, el precio de la tarea es clave
OpenAI y Anthropic están cambiando las reglas de facturación de LLM: en 2026, a las empresas ya no les basta monitorear solo el precio del token — deben calcular el costo total de resolver una tarea específica.
Claude Code Convertido en Analista de IA por BABOK: El Asistente Conduce Entrevistas y Recopila Requisitos
Basándose en Claude Code, desarrollaron un asistente de IA para análisis empresarial siguiendo BABOK v3: ayuda a conducir entrevistas, recopilar requisitos, evitar omitir pasos y documentar artefactos.
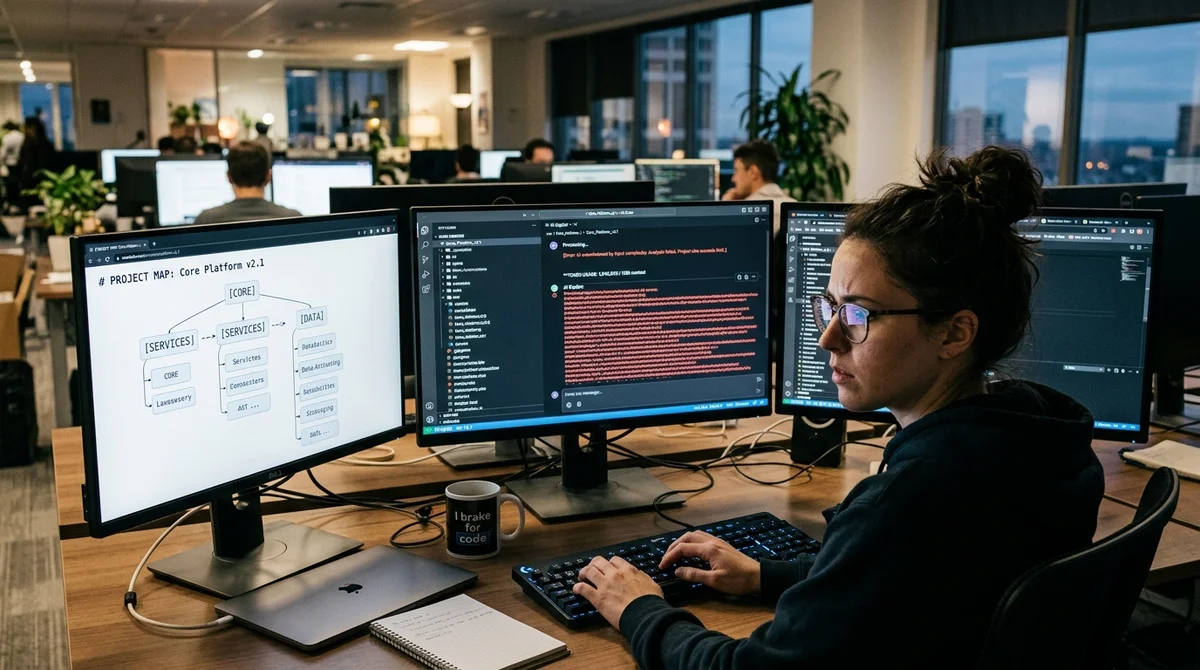
Claude Code y Codex: cómo reducir pérdidas de tokens con tres archivos markdown
Claude Code y Codex a menudo gastan la mayor parte de su contexto en navegación repetida de proyectos; esto se puede resolver con una jerarquía de mapa global, CLAUDE.md y memoria de sesiones anteriores.
LM Studio y Qwen: cómo los LLMs locales manejan la codificación en MacBook M4 Pro
El autor probó modelos locales Qwen, Gemma y otros para codificación a través de LM Studio en MacBook M4 Pro: ya son viables en modo chat, pero se quedan notablemente rezagados frente a las soluciones en la nube en modo
Qwen 3.5 en MacBook Pro: Comparación de ocho servidores locales para trabajo en equipo
El autor probó ocho servidores MLX en MacBook Pro M2 Max con Qwen 3.5 35B y demostró que prácticamente todas las soluciones pierden significativamente velocidad con solicitudes paralelas.
Selectel: la IA no quita empleos, pero hace que entrar en la profesión sea significativamente más difícil
Selectel describe un nuevo mercado laboral en torno a la IA: los puestos no desaparecen, pero es más difícil para los junior entrar en la profesión, y la demanda y salarios se desplazan hacia quienes saben trabajar con m
Habr AI lanza guía sobre ChatGPT, Claude y mcp para quienes comienzan
Habr AI explicó sin teoría innecesaria las diferencias entre modelos locales y en la nube, por qué pagar suscripciones, cómo funcionan los agentes y por qué mcp ya se convierte en estándar.
Joshua Bengio y LawZero: por qué el miedo a la IA futura distrae de las amenazas actuales
Un texto sobre 'apuesta de Pascal' en IA explica por qué el miedo a la superinteligencia hipotética desvía la atención de amenazas ya reales: vigilancia, poder corporativo y presión sobre trabajadores.
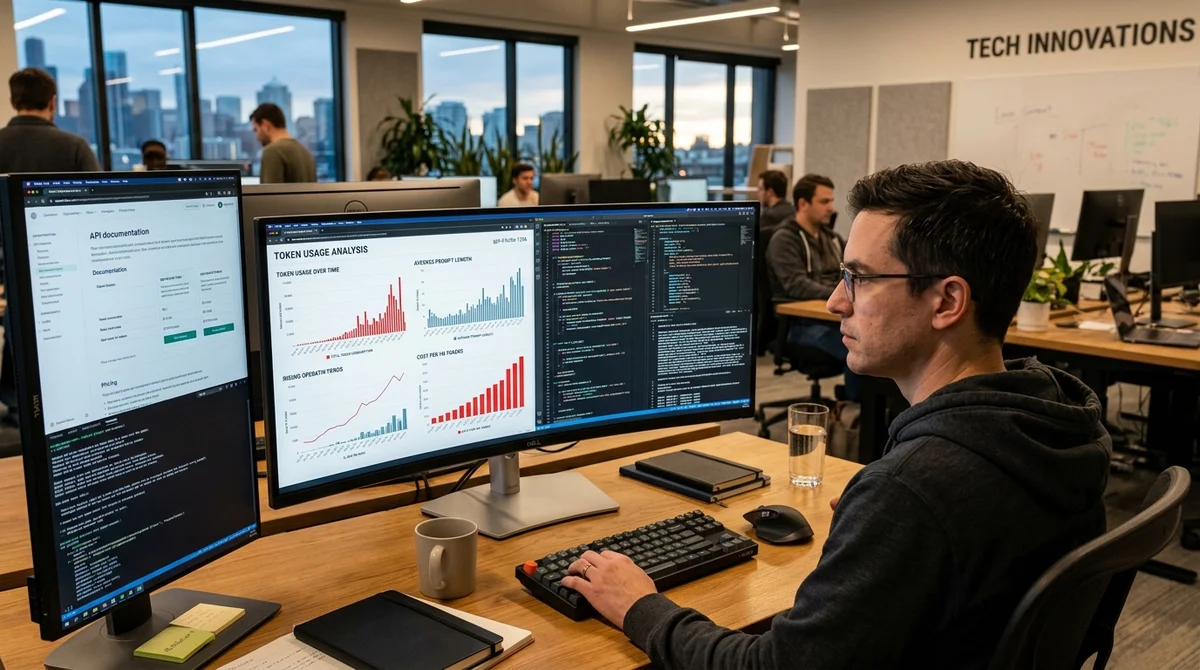
Anthropic y Claude Opus 4.7: el consumo real de tokens superó lo anunciado
Un autor midió el nuevo tokenizador de Claude Opus 4.7 y obtuvo un aumento de consumo de hasta 45–47%, en lugar del 0–35% prometido por Anthropic, impactando directamente las cuotas, caché y velocidad de agotamiento del
OpenAI lanza GPT-Rosalind para biología: capacidades y limitaciones del nuevo modelo
OpenAI lanzó GPT-Rosalind para tareas en ciencias de la vida e la integró con un módulo de investigación Codex, prometiendo acelerar hipótesis y experimentos sin ensamblaje manual de docenas de servicios.
Auditoría de Seguridad de Cursor Descubre Cuatro Vulnerabilidades en el Editor de Código, pero la Autorización Permanece Segura
Una auditoría técnica de Cursor reveló prototype pollution, un campo dev oculto y fugas de arquitectura interna, pero confirmó que la verificación de suscripción y el acceso a modelos premium permanecen en el servidor.
Anthropic lanzó Opus 4.7, y OpenAI convirtió Codex en un agente de trabajo en computadora
Esta semana en IA trajo varios cambios: Anthropic actualizó Opus 4.7, OpenAI le dio a Codex control de computadora, y Google y Baidu revelaron nuevos modelos de voz y visuales.
ChatGPT acertó el diagnóstico en cinco casos, pero falló en la planificación del tratamiento
En una comparación de cinco casos médicos, ChatGPT nunca se equivocó en el diagnóstico principal—pero quedó notablemente corto en recomendaciones prácticas, pruebas y gestión del paciente.
Por qué los servicios de LLM ignoran tus instrucciones y cómo recuperar realmente el control
Ni siquiera un prompt detallado garantiza una respuesta obediente: este artículo explica por qué los LLMs rompen el formato, sucumben a inyecciones y requieren no solo texto, sino restricciones de ingeniería.
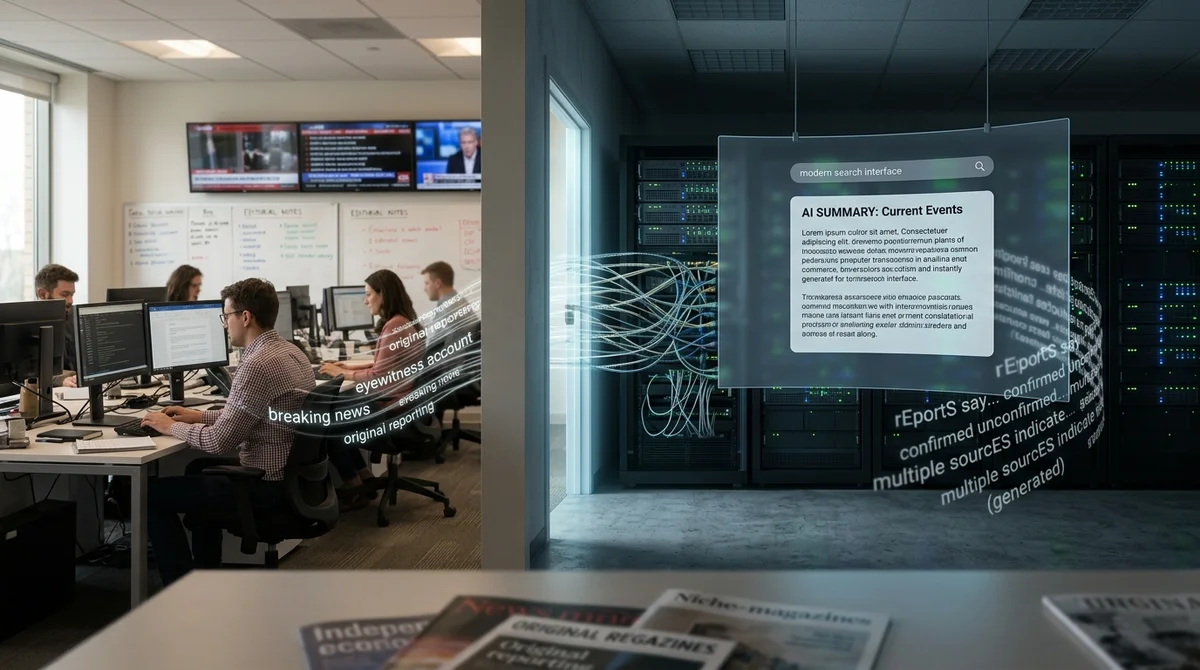
Google y OpenAI chocan contra el límite: ¿qué sucederá si escasea el texto humano en internet?
La IA generativa no solo agota el tráfego de los sitios web mediante resúmenes de IA, sino que también socava su propia base de datos de entrenamiento: cuanto menos incentivo tengan las personas para escribir, peor se vo
Cómo el Banco de Crédito de Moscú Muestra la Evolución de la Capacitación Bancaria — De Escribientes a IA
El Banco de Crédito de Moscú rastreó cómo los bancos capacitaban empleados, desde la verificación de monedas y correspondencia comercial hasta incorporación personalizada, cumplimiento normativo y asistentes de IA.
OpenAI integra tecnologías Sky en Codex para Mac y mejora la gestión de aplicaciones en segundo plano
OpenAI ha integrado capacidades Sky en Codex para Mac: el agente ahora gestiona múltiples aplicaciones en segundo plano, utiliza cursores independientes y maneja tareas rutinarias con mayor precisión.
Habr AI Explicó Cómo la Búsqueda de Soluciones Impulsada por Datos Cambia la Arquitectura Cliente-Servidor
El artículo de Habr AI examina cómo los sistemas expertos con búsqueda de soluciones impulsada por datos deben estructurar la interacción con el usuario localmente, en una red local y a través de Internet.
Seedance 2.0 atrae atención con generación hiper-realista de personas y escenas
El sistema multimodal Seedance 2.0 acepta texto, imágenes, audio y vídeo, generando vídeos casi cinematográficos que ya generan debate sobre riesgos de deepfakes.
Claude Code y Codex cambian las reglas: los prompts ceden lugar a la ingeniería de contexto
Un análisis de Context Engineering muestra por qué en Claude Code, Codex e IDEs agentivos, ya no es el prompt lo que decide, sino cómo se estructuran la memoria, las instrucciones del sistema, las tools y todo el montaje
Por qué los modelos de difusión dejan costuras en fotos de 40 megapíxeles y cómo dar memoria a los bloques
El artículo examina por qué el teselado rompe fotogramas de 40–150 megapíxeles en modelos de difusión y qué mecanismos de memoria de la difusión de vídeo se pueden transferir a fotos.
Lubomir Gorbatko Presenta Sessa — Una Alternativa a Transformers y Mamba
Habr publicó un análisis de la arquitectura Sessa, donde el autor intenta combinar las fortalezas de Transformer y Mamba para trabajar mejor con contextos largos sin perder memoria manejable.
Harvard Business Review: cómo el uso activo de IA lleva al "sobrecalentamiento cerebral"
Harvard Business Review describe el efecto AI brain fry: cuanto más activamente los empleados dependen de Claude, Gemini y agentes, mayor el riesgo de fatiga cognitiva, confusión y degradación de la calidad de las decisi
Flag Soft: benchmark "Dali Trial" ayudó a seleccionar LLMs por calidad, velocidad y costo
El benchmark "Dali Trial" comparó LLMs en tres criterios importantes para la implementación de productos: calidad de respuestas, velocidad de procesamiento y costo total.
Habr AI: en lugar de complejos agent pipelines, los desarrolladores deberían adoptar Markdown, Git y memoria de sesión
Habr publicó un manifiesto contra agent pipelines sobrecargados: el autor sostiene que para desarrollo complejo de IA, las sesiones, roles, reglas y git importan más que LangChain y vector DB.
Plugin opencode-policy Añade 309 Reglas para Proteger Agentes de IA contra Inyecciones y Fugas
Para el entorno opencode se propuso un filtro determinístico con 309 reglas regex: intercepta prompt injection y llamadas de herramientas peligrosas antes del acceso a shell, archivos y secretos.