Advanced Payment Solutions lleva a piloto un apuntador con IA para llamadas sin un equipo de ML
Advanced Payment Solutions ha presentado un caso poco habitual en el mercado: su asistente de IA por voz para llamadas no lo crearon ingenieros de ML, sino 12 desarrolladores backend. En seis meses, el equipo llevó el producto a piloto, descartó el fine-tuning y una base de datos vectorial pesada, pasó la generación a un Qwen 8B local y logró una latencia de trabajo de unos dos segundos, suficiente para dar pistas al gerente en plena conversación. El piloto ya ofrece señales cualitativas de utilidad, pero todavía no hay conclusiones estadísticamente significativas sobre conversión ni KPI. Según la empresa, para ello hace falta escalar el producto e integrarlo sin fricciones en el CRM.
Procesado por IA desde Habr AI; editado por Hamidun News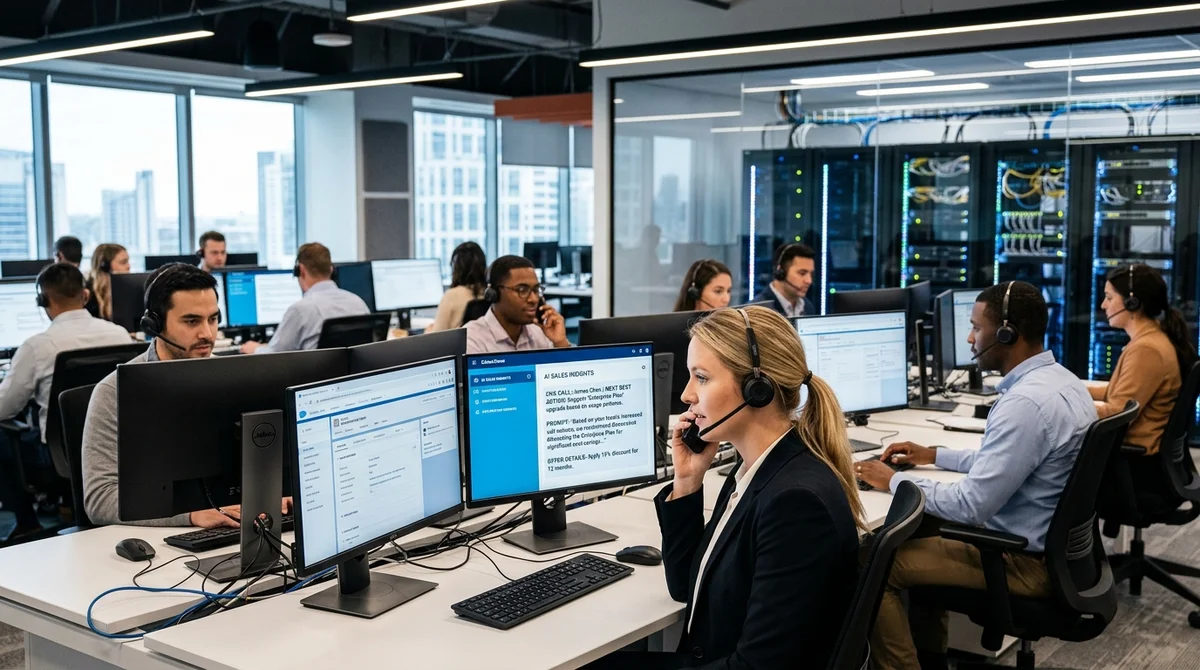
Advanced Payment Solutions ha contado cómo llevó a piloto un asistente de IA por voz para llamadas sin un equipo de ML propio. En seis meses, 12 desarrolladores backend montaron un sistema que sugiere al gerente en tiempo real cómo responder al cliente, con una latencia de unos dos segundos.
Cómo se montó el MVP
Dentro de la empresa, el proyecto se llamó «Suflyor» («Apuntador»). Su tarea es escuchar una conversación ya transcrita, entender de qué producto se habla, detectar la objeción del cliente y mostrar de inmediato al gerente una sugerencia en texto. El stack final se construyó con Python, FastAPI y PostgreSQL, y de la clasificación y la generación se encargaron clasificadores BERT y un Qwen 8B local. Para el negocio, es una forma de reducir la carga de los mentores y de llevar antes a los nuevos empleados a sus KPI, sobre todo cuando el ecosistema tiene más de 35 productos y el gerente debe tener en la cabeza demasiados escenarios.
La restricción clave era estricta: el sistema dispone solo de 1,5–2 segundos para responder; si no, la sugerencia pierde sentido en plena conversación en directo.
El equipo llegó rápido a un prototipo funcional. En las tres primeras semanas, los desarrolladores tomaron transcripciones de texto de llamadas, entrenaron dos clasificadores BERT con unos 1,5 mil diálogos, montaron bases de conocimiento sencillas con guiones y lo conectaron todo mediante prompts con un modelo GPT en la nube. La interfaz la hicieron en un día con Django. Esta prueba de concepto era lenta, con una latencia de 10–15 segundos, pero bastó para defender la idea ante el negocio y obtener luz verde para el MVP. Después empezó el trabajo de ingeniería para reducir la latencia, estabilizar el sistema y hacer las integraciones.
Por qué lo simplificaron todo
Al principio, el equipo, como suele ocurrir en los proyectos de IA, diseñó un sistema demasiado ambicioso: un canal de audio propio, varios clasificadores complejos, fine-tuning de un modelo de lenguaje grande, una base vectorial e incluso un circuito de autoaprendizaje. Pero pronto quedó claro que ese camino alargaría el lanzamiento entre 12 y 18 meses y aumentaría mucho el riesgo de fracaso. En lugar de intentar construir una arquitectura «perfecta», los desarrolladores empezaron a eliminar de forma sistemática todo lo prescindible en la primera versión.
«No luchamos contra los problemas, sino que rediseñamos el sistema
para que esos problemas no surgieran».
- Renunciaron al fine-tuning en favor de RAG, para no gastar meses en el etiquetado y reducir el riesgo de alucinaciones.
- No escribieron su propia transcripción y tomaron segmentos de texto ya listos de Voximplant.
- Simplificaron el clasificador de objeciones: en lugar de más de 15 clases, dejaron un esquema binario «hay objeción / no hay objeción».
- No incorporaron una base de datos vectorial pesada para unos pocos megabytes de datos y cargaron archivos JSON estructurados directamente en memoria.
- Dejaron las API en la nube por un Qwen 8B local en un servidor con GPU, para cumplir la latencia y no sacar datos sensibles del perímetro.
Este conjunto de concesiones resultó decisivo. Los modelos en la nube respondían en 7–20 segundos, y Qwen 32B, aunque respondía mejor, tampoco cumplía con el tiempo. El Qwen 8B, más compacto, resultó suficientemente bueno para las sugerencias al gerente y estabilizó la latencia en torno a los dos segundos. A la vez, el despliegue local resolvió las cuestiones de seguridad de la información: las transcripciones de las conversaciones no hay que enviarlas a servicios externos, por lo que no hizo falta construir una capa aparte de enmascaramiento de datos personales ni pagarla con latencia adicional.
Qué mostró el piloto
El problema más subestimado no fueron los modelos, sino los datos. El equipo tomó 200 llamadas, las repartió entre 12 participantes y chocó rápido con el etiquetado manual: para clasificar bien las objeciones no basta con señalar una frase, hay que entender el contexto de la conversación y la lógica de ventas. Como resultado, los desarrolladores replantearon el propio enunciado del problema. En lugar de intentar «enseñar a la IA a pensar como un experto», se centraron en un objetivo más acotado: detectar a tiempo el momento en que el gerente necesita ayuda y, a partir de ahí, recuperar el guion adecuado y generar la sugerencia.
Según los resultados del piloto, el sistema alcanzó una latencia media de unos dos segundos y solo en el 2–3% de los casos subió hasta tres. La clasificación de servicios logró una precisión superior al 70%, y el reconocimiento de voz, desde el 92% según la calidad de la conexión.
El equipo escribe que el piloto ya ha tenido un efecto cualitativo: han aparecido las primeras señales sobre comodidad, menor carga de los mentores y utilidad general para los operadores. Pero aún no hay conclusiones estadísticamente significativas sobre conversión y KPI: para ello, el producto necesita escalar y una integración fluida directamente en el CRM.
Qué significa
Este caso muestra que un producto interno de IA no siempre exige un equipo de ML ya formado desde cero. Si una empresa tiene buenos ingenieros backend, un problema de negocio claro y acceso a los procesos, el MVP puede montarse más rápido simplificando con dureza la arquitectura y renunciando a componentes «inteligentes» superfluos. La conclusión principal no está en la elección de un modelo concreto, sino en la disciplina: primero resolver el problema del negocio, luego comprobar las restricciones de velocidad y seguridad, y solo después complicar el stack.
- 2 nov 2026DeepSeek abre el código del prototipo Super-agent: p95 de ejecución de 15,7 min frente a 29,5
- 2 nov 2026TensorFold 1.2.0 aumenta un 44,2% el rendimiento de Qwen3.8-27B en el M3 Ultra con 16 flujos
- 1 nov 2026El juez de EditAgent, de Adobe, elige una edición válida en el 81,3% de los casos frente al 74,8% de EditScore
- 1 nov 2026Prueba de 16 modelos en 7 buscadores: Exa obtuvo una media de 10,5 puntos de 14; SearXNG, en torno a 3
Preguntas frecuentes sobre la noticia
Cómo se montó el MVP?
Dentro de la empresa, el proyecto se llamó «Suflyor» («Apuntador»). Su tarea es escuchar una conversación ya transcrita, entender de qué producto se habla, detectar la objeción del cliente y mostrar de inmediato al gerente una sugerencia en texto. El stack final se construyó con Python, FastAPI y PostgreSQL, y de la clasificación y la generación se encargaron clasificadores BERT y un Qwen 8B local. Para el negocio, es una forma de reducir la carga de los mentores y de llevar antes a los nuevos empleados a sus KPI, sobre todo cuando el ecosistema tiene más de 35 productos y
¿Qué se sabe sobre Por qué lo simplificaron todo?
Al principio, el equipo, como suele ocurrir en los proyectos de IA, diseñó un sistema demasiado ambicioso: un canal de audio propio, varios clasificadores complejos, fine-tuning de un modelo de lenguaje grande, una base vectorial e incluso un circuito de autoaprendizaje. Pero pronto quedó claro que ese camino alargaría el lanzamiento entre 12 y 18 meses y aumentaría mucho el riesgo de fracaso. En lugar de intentar construir una arquitectura «perfecta», los desarrolladores empezaron a eliminar de forma sistemática todo lo prescindible en la primera versión. «No luchamos cont
¿Qué se sabe sobre Qué mostró el piloto?
El problema más subestimado no fueron los modelos, sino los datos. El equipo tomó 200 llamadas, las repartió entre 12 participantes y chocó rápido con el etiquetado manual: para clasificar bien las objeciones no basta con señalar una frase, hay que entender el contexto de la conversación y la lógica de ventas. Como resultado, los desarrolladores replantearon el propio enunciado del problema. En lugar de intentar «enseñar a la IA a pensar como un experto», se centraron en un objetivo más acotado: detectar a tiempo el momento en que el gerente necesita ayuda y, a partir de ah
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.