Habr AI
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
Apple apuesta por la IA local en los chips de la serie M, no por modelos gigantes
Mientras el mercado compara centros de datos y clústeres de GPU, Apple impulsa otro escenario: ejecutar la IA junto al usuario, en dispositivos con memoria unificada y bajo consumo.
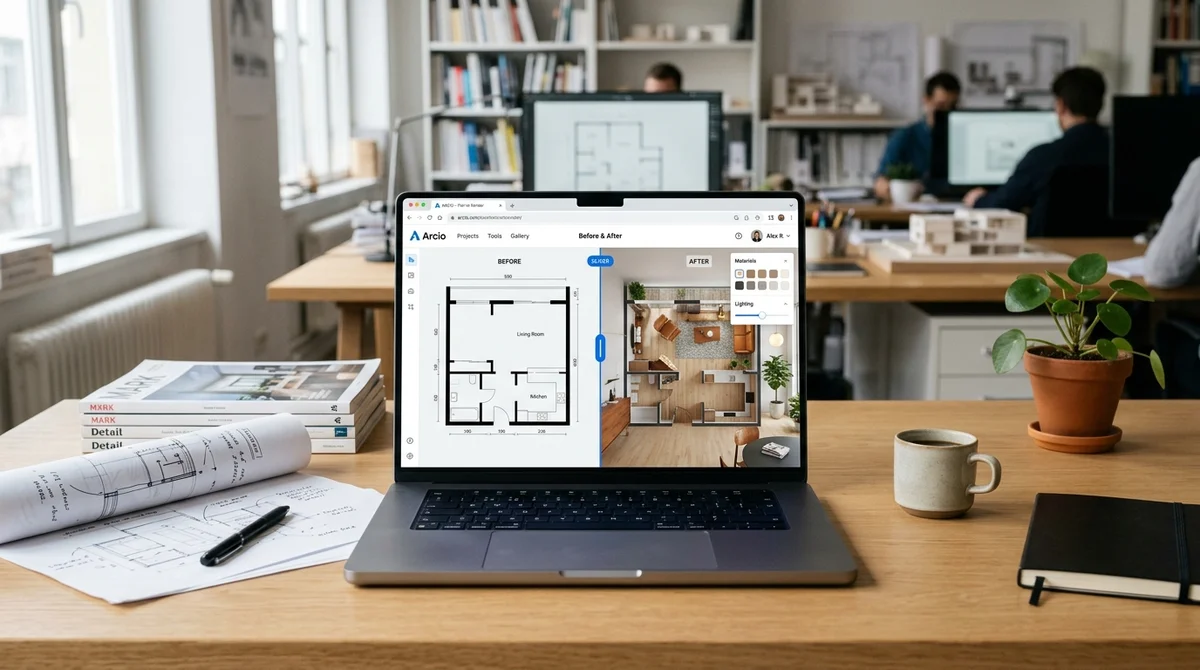
Un desarrollador muestra cómo creó Roomify, un visualizador de interiores con IA sobre React y Puter
Roomify convierte planos de espacios en renders 3D fotorrealistas en segundos, y todo el proyecto se apoya en React, Puter y llamadas a Claude/Gemini, sin backend aparte.
Un emprendedor cuenta en Habr cómo montó un CRM para su taller mecánico con ChatGPT y Cursor
El dueño de un taller sin formación informática explica cómo, desde 2022, creó con ChatGPT, Claude y Cursor un CRM, un bot de Telegram y una app Android para negocios offline.
Cómo afecta la limpieza de datos personales a los agentes LLM: el experimento de Hivetrace Dataclean
Los autores midieron cuánta calidad pierde un agente LLM bancario al anonimizar datos: compararon datos originales, máscaras y seudónimos en 102 pruebas sintéticas.
Cápsulas para agentes de IA: cómo la experiencia empaquetada de un desarrollador se convierte en conocimiento para la máquina
El autor del framework de cápsulas muestra cómo su estructura rígida, con contexto, restricciones e historial, es un formato ideal para agentes de IA y no solo para personas.
Cómo ejecutar DeepSeek en tu propio servidor: memoria, configuración y privacidad total
Guía para instalar DeepSeek en un servidor en la nube: cuánta memoria necesita cada variante, qué herramientas usar y cómo configurarlo bien a la primera.
Stable Diffusion XL en casa: una guía para quienes lo veían demasiado complicado
La editorial BHV publica una guía práctica de Stable Diffusion XL para quienes quieren generar imágenes de forma local y privada, sin suscripciones.
Expertos de BI.ZONE: la IA y los deepfakes hicieron el phishing de 2026 más preciso y peligroso
Expertos de BI.ZONE explican por qué el phishing en 2026 es personalizado y multietapa, qué esquemas funcionan mejor y por qué las medidas básicas aún protegen.
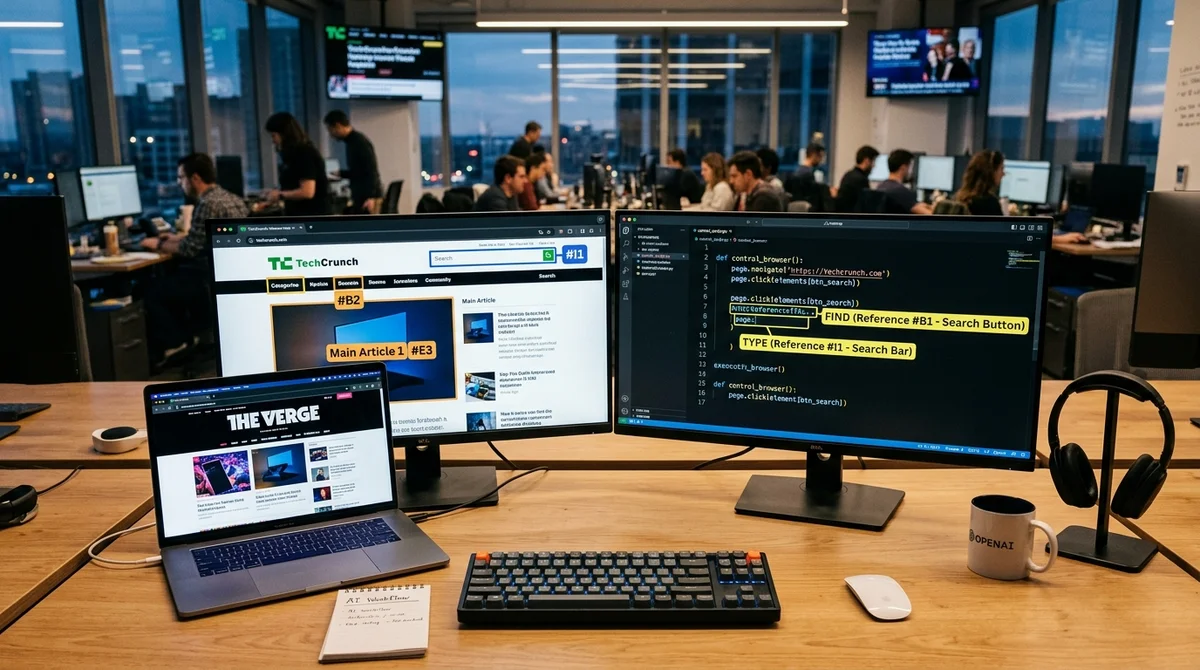
Vercel presenta agent-browser, un acceso ligero al navegador para agentes de IA sin MCP
Vercel lanza agent-browser, una CLI en Rust que muestra al agente de IA solo los elementos interactivos de la página y permite controlar el navegador con menos tokens que MCP.
Grok, Claude y Kling: cómo preparar rápido una animación web compleja para el frontend
Un repaso de cómo un diseñador puede usar Grok, Claude, Kling, CodePen y Spline para convertir la idea de una animación web compleja en un paquete claro de materiales para frontend.
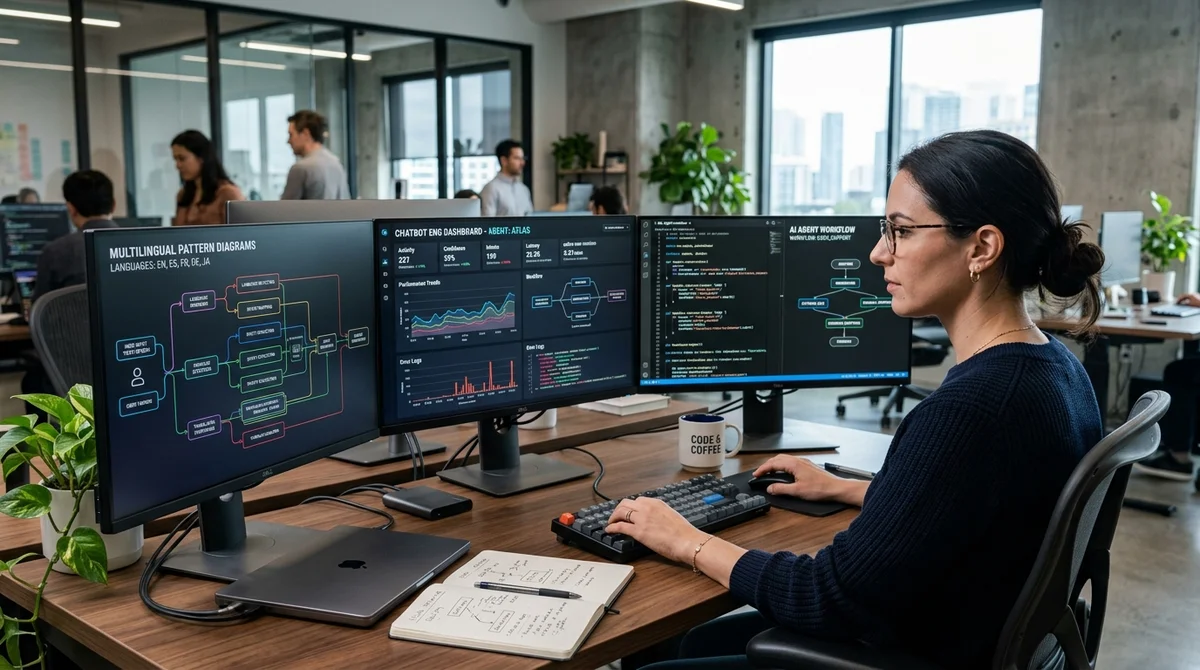
Just AI automatiza JAICP DSL: un agente de IA escribe patrones y pruebas en un minuto en lugar de seis horas
Just AI creó un agente para JAICP DSL que genera patrones, frases de ejemplo y pruebas automáticas en varios idiomas y reduce la rutina del desarrollador de seis horas a un minuto.
Surf explica por qué los equipos sabotean la adopción de la IA en el desarrollo de productos
Directivos de Surf describen cinco etapas de aceptación de la IA en desarrollo, de la negación y la ira al equilibrio, y explican por qué imponerla casi siempre provoca sabotaje.

Google NotebookLM, Canva y Gamma: 13 servicios de IA para presentaciones que son gratis solo en teoría en 2026
Una nueva selección compara 13 servicios de IA para presentaciones, de Google NotebookLM y Gamma a Canva y Decktopus. Casi todos ofrecen gratis solo créditos de prueba, límites de exportación o marcas de agua.
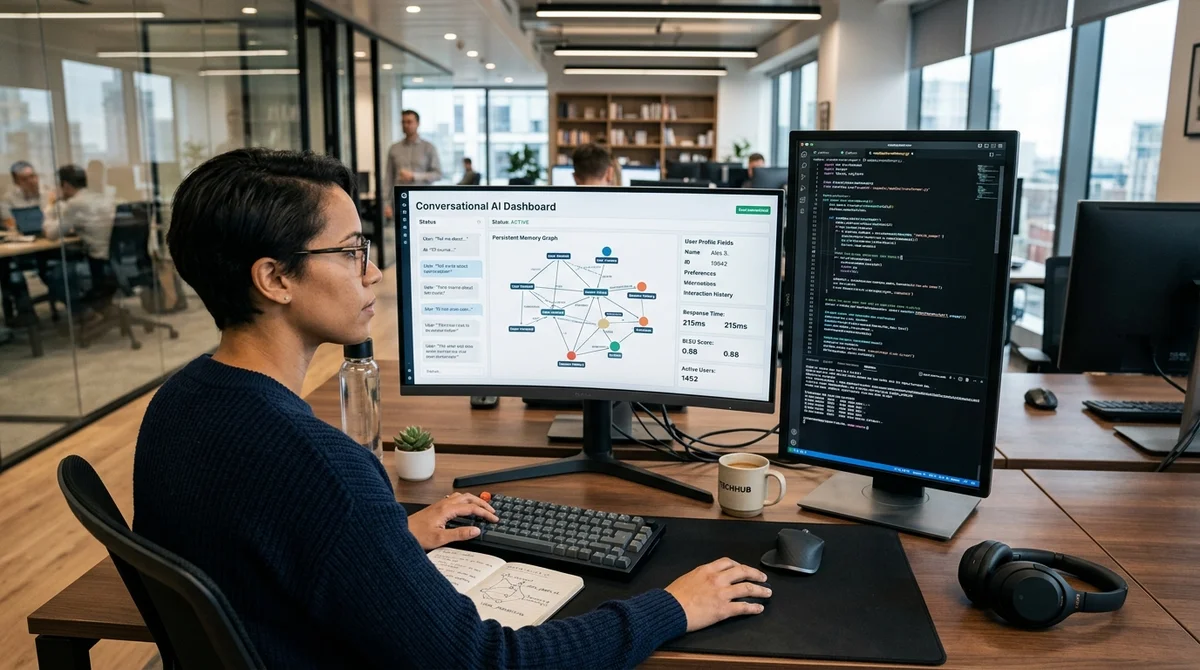
El módulo NGT Memory muestra cómo dar a un LLM memoria persistente sin base de datos vectorial
El módulo open source NGT Memory ofrece memoria persistente para LLM sin una base de datos vectorial externa: guarda el perfil del usuario, enlaza hechos y recupera contexto relevante en 2–3 ms en CPU.
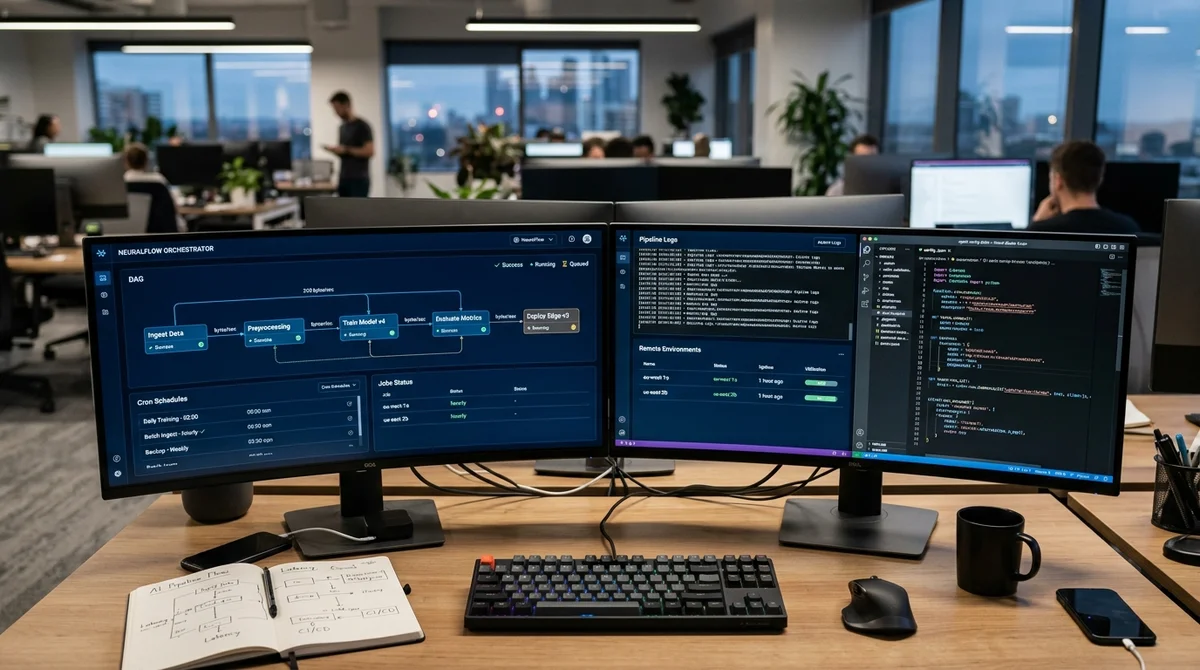
agent-pool para Google AI y Gemini CLI añade pipelines, cron y bounce-back
El servidor MCP agent-pool para Google AI y Gemini CLI automatiza cadenas multiagente: lanza pasos por disparadores, devuelve tareas para corregirlas y las programa con cron.
Agentic Legal RAG Challenge 2026: así puso Sparks of intelligence a prueba los límites del RAG agéntico
El equipo Sparks of intelligence analiza su paso por el Agentic Legal RAG Challenge 2026 y muestra por qué en el RAG jurídico lo deciden el chunking, la búsqueda, el grounding y el tiempo de depuración.
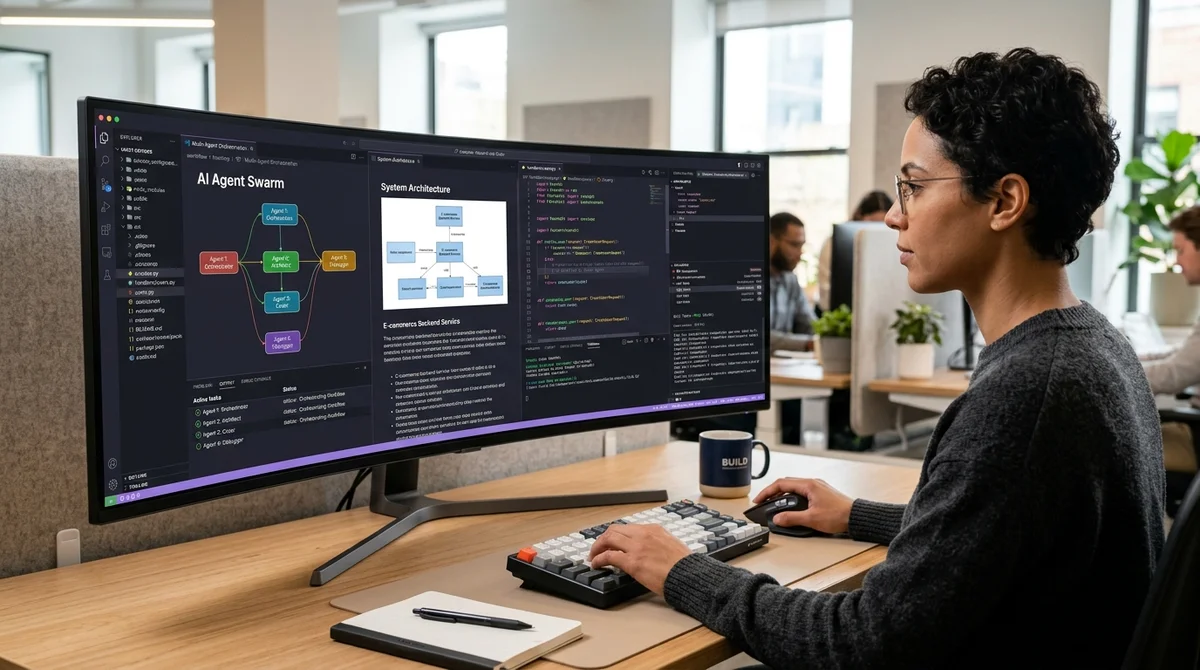
RooCode para VS Code: cómo configurar un desarrollo multiagente sin caos ni consultas innecesarias a los modelos
Un esquema detallado de RooCode explica cómo repartir roles entre modos, conectar servidores MCP y mejorar por etapas los agentes de IA en VS Code sin ruido innecesario.
Yandex 360 explica cómo enseñar a un asistente de IA a trabajar con un UI kit interno
El equipo de Yandex 360 cuenta cómo hacer que un repositorio frontend sea comprensible para la IA y por qué, sin ello, el asistente alucinará componentes.
LinkedIn y SHRM: la IA ha convertido el currículum en una señal débil y en un filtro de contratación
Los candidatos pulen sus currículums con IA, las empresas los filtran con algoritmos y el valor del CV «perfecto» cae. Pesan más los casos, las entrevistas y la experiencia verificable.
Agente LLM con MCP en Fusion360: primera prueba de vibe-design con una escalera de madera
Fusion360 ya tiene un asistente LLM con MCP. Un autor de Habr lo probó de inmediato con una escalera de madera que había modelado a mano más de 60 veces.
Claude Code ayudó a subir un RAG jurídico a 0.791, pero la final de ARLC 2026 chocó con la escala
Un caso de ARLC 2026 muestra que un RAG jurídico puede mejorarse en 17 iteraciones y luego perder un 42% del resultado al pasar de 30 a 303 documentos.
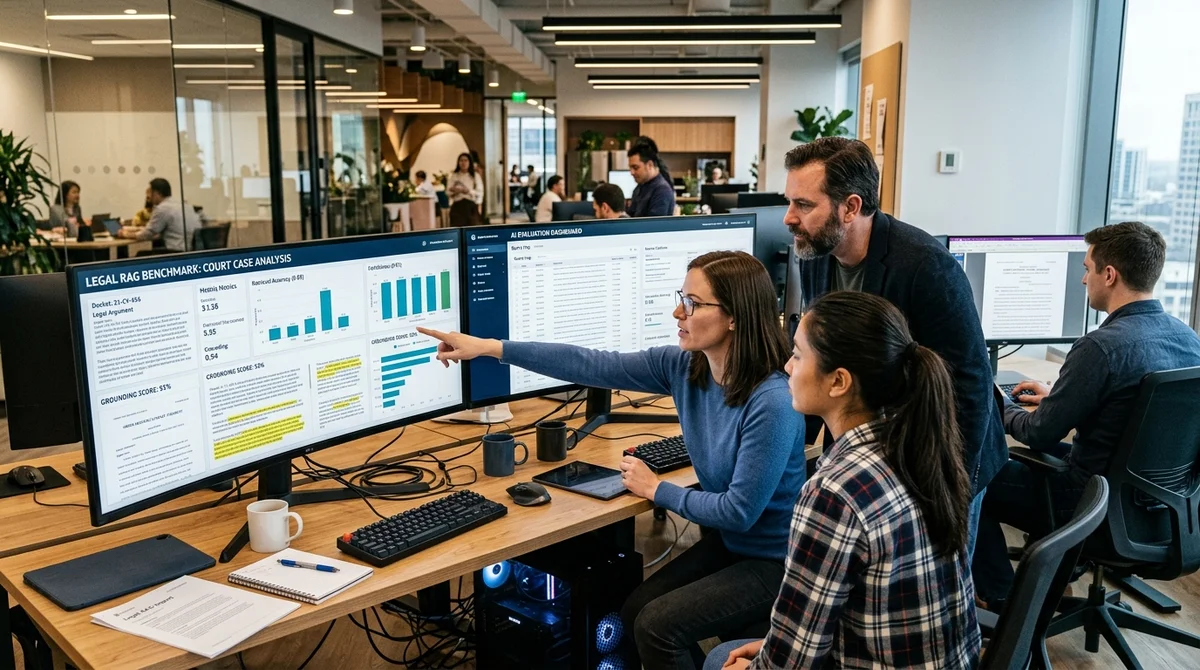
OpenAI y Grok pierden ante un RAG a medida en el Agentic RAG Legal Challenge
Un equipo con un Mac Studio M3 Ultra comparó RAG, CAG, BM25 y las bases integradas de OpenAI y Grok en un reto legal. Lo que decidió fue el grounding, no el nombre del modelo.
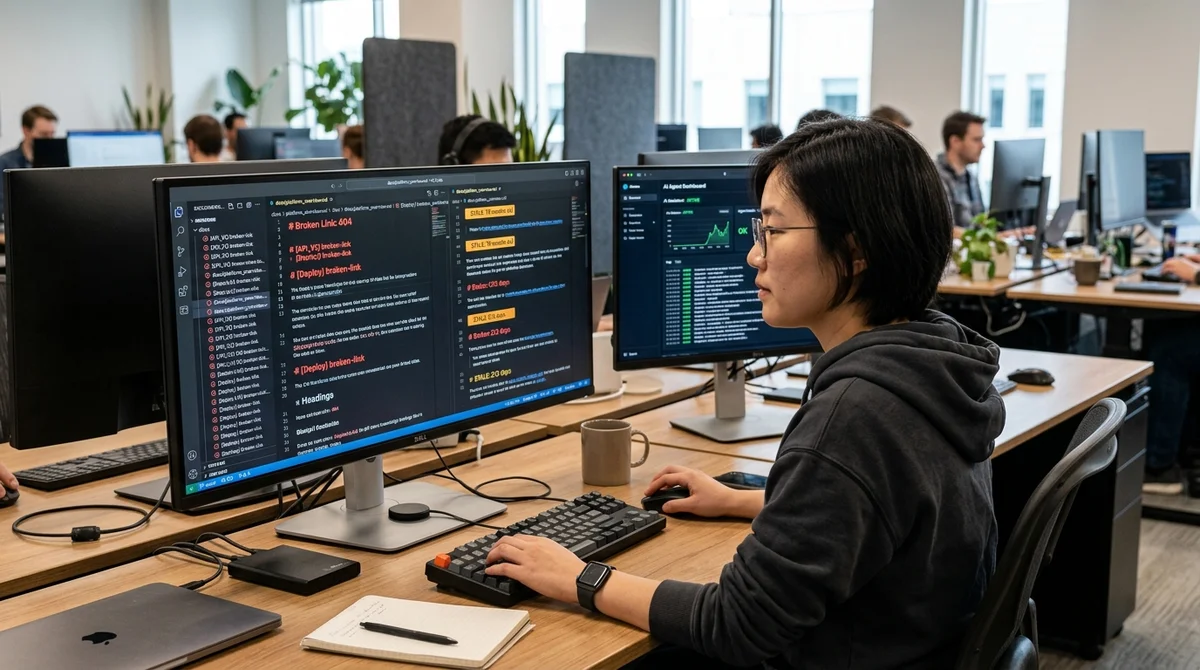
Habr: cómo una base de conocimiento obsoleta rompe el trabajo de los agentes LLM y cómo arreglarlo
Un artículo de Habr explica por qué la documentación obsoleta es más peligrosa para los agentes LLM que no tener ninguna, y propone tres prácticas: comprobaciones automáticas, estados de documentos y reglas estrictas de
El vibe coding promete multiplicar por 10 la productividad, pero PyPI aún no lo confirma
Los desarrolladores aseguran acelerar entre 10 y 100 veces con herramientas de IA. Si es cierto, ¿por qué PyPI no registra un aumento explosivo de paquetes de Python?

Anthropic refuerza Claude: por qué los nuevos clientes corporativos lo eligen frente a ChatGPT
Los datos de Ramp de marzo de 2026 muestran un giro en la demanda empresarial: entre las compañías que compran IA por primera vez, Claude de Anthropic supera claramente a OpenAI.

NotebookLM y Gemini automatizan la creación de tests con Google Apps Script y Forms
El autor muestra cómo enlazar NotebookLM, Gemini, Google Apps Script y Google Forms para crear tests de estudio a partir de fuentes ya preparadas y dedicar menos tiempo a la rutina.
Doka presenta un agente de IA local para Rusia sin VPN, sin suscripción y sin nube
Un desarrollador ha empaquetado su propio agente de IA en Doka, una app de escritorio que funciona en local con Qwen3 y no requiere nube, VPN ni pago mensual.
Por qué los modelos de lenguaje se equivocan aunque conozcan la respuesta correcta: un repaso a las limitaciones de los LLM
Valeri Shabashev, investigador de TechVill, explica por qué los LLM pueden fallar aun teniendo la respuesta correcta: el problema no es el conocimiento, sino la verificación del razonamiento.
Un conjunto de LLM pone a prueba interpretaciones teológicas: el caso de 1 Tim. 2:15 como análisis estático
Cinco modelos de lenguaje compararon dos lecturas de 1 Tim. 2:15. El conjunto de LLM no buscó la «verdad»: expuso supuestos ocultos y puntos débiles del argumento.
Botinok: un agente de IA de consola para servidores que funciona en local y consume poca memoria
Botinok es un agente de IA de consola, ligero, para trabajar por SSH: se lanza bajo demanda, entiende el contexto del servidor y está pensado para modelos locales con poca VRAM.