Habr AI
Fuente de noticias de IA. Los artículos son seleccionados y adaptados por la redacción de Hamidun News.
Últimas publicaciones
IA para Casa Inteligente: Llama 8B Localmente, Trampas Reales y Cómo Evitar la Nube
Guía práctica: conectando Llama 8B, Ollama y Home Assistant en un stack offline, expectativas de desempeño y trampas en el despliegue.
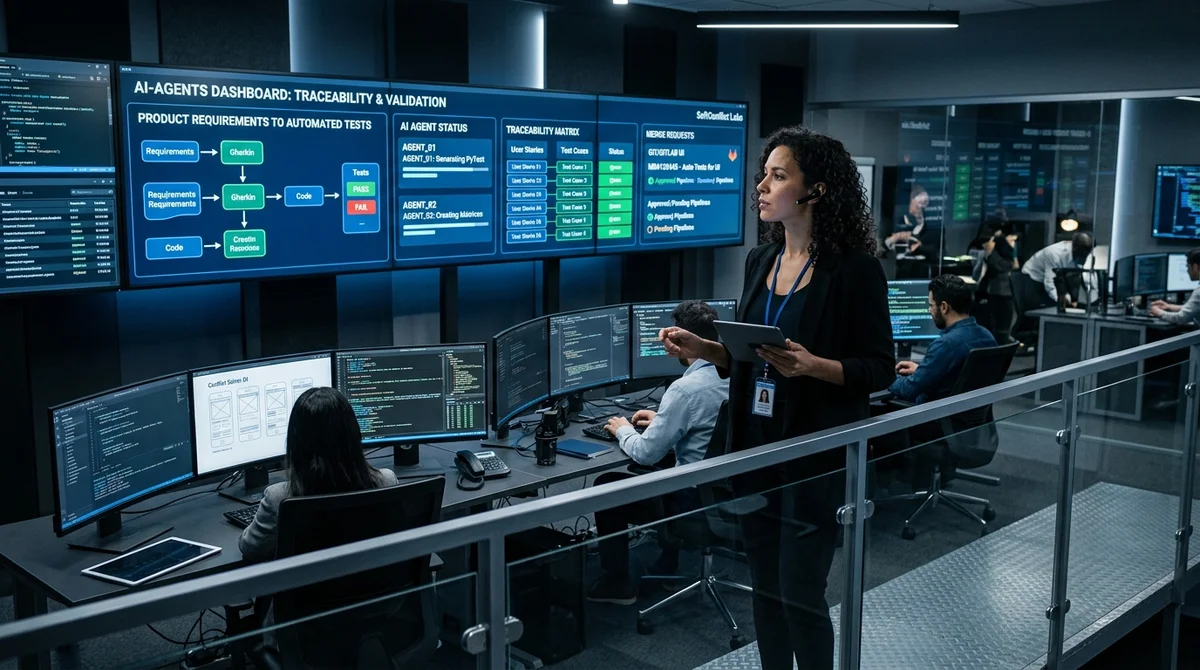
Claude Code y 11 Agentes: Cómo un equipo de QA automatizó hasta el 80% de la rutina de pruebas
Un equipo de QA construyó un sistema de 11 agentes de IA basados en Claude Code que convierte tareas de Jira en casos de prueba, pruebas automatizadas y Merge Requests en horas en lugar de días.
Por Qué los LLMs Mienten y Olvidan Hechos: Analizando Mecanismos de Memoria en Modelos de Lenguaje
Los modelos de lenguaje no almacenan hechos como bases de datos — generan texto plausible. Exploramos cuatro razones por las que los LLMs alucinan y olvidan.
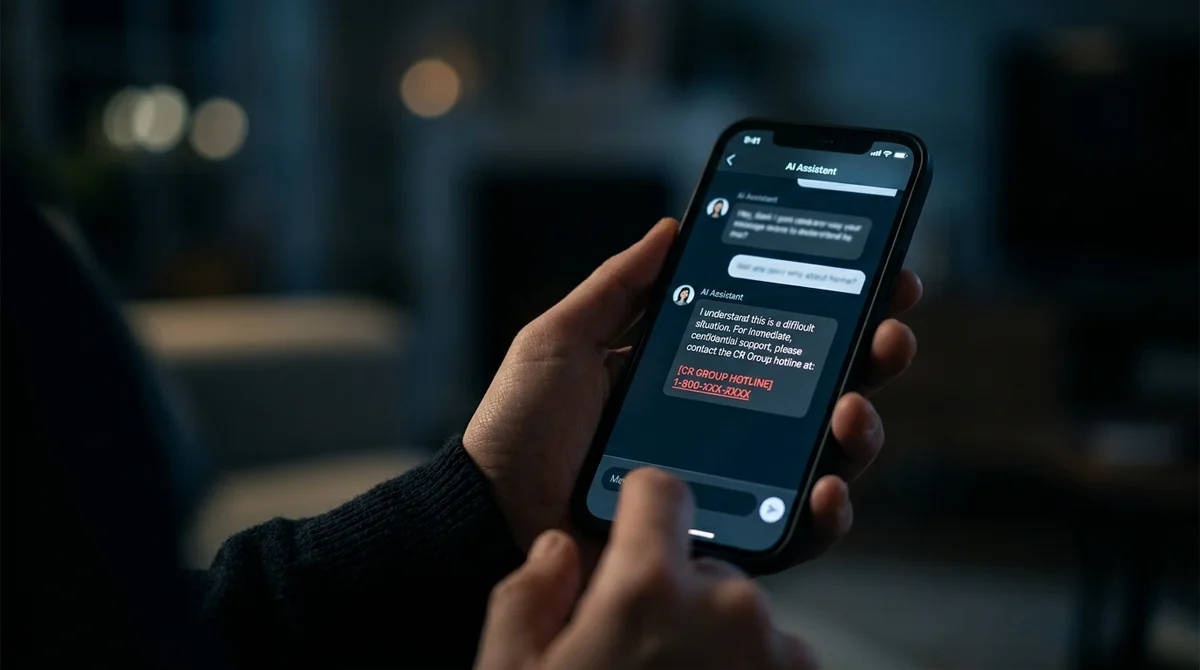
LLM Alucinó una Línea de Crisis: Por Qué los Prompts No Detienen las Alucinaciones
Un modelo de lenguaje recomendó a una chica perjudicada el número de una línea infantil en lugar de un centro de crisis. Una restricción en el prompt no funcionó—se necesita un cambio de arquitectura.
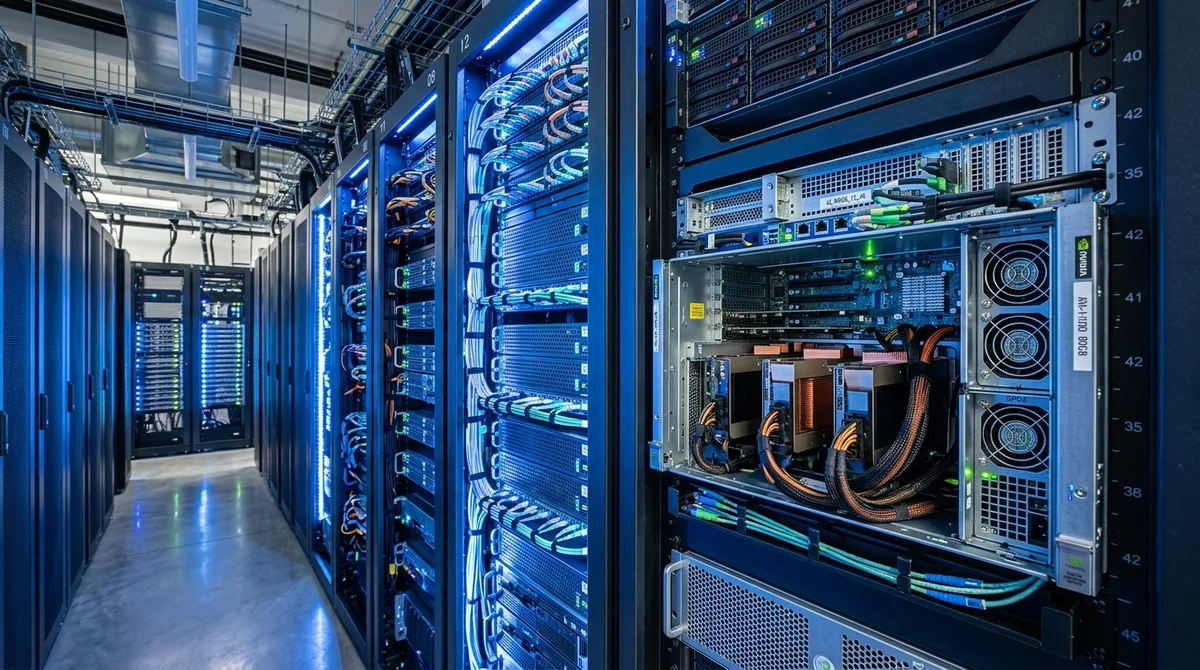
T1 Cloud: H200 y L40S — Revisión técnica de GPUs para tareas de IA generativa
T1 Cloud publicó una revisión técnica de servidores GPU H200 y L40S con fotografías del centro de datos y explicó cómo seleccionar correctamente un acelerador para tareas de IA.

NVIDIA Nemotron 3 Super 120B: Prueba en Tareas Analíticas Reales en una Sola GPU
El equipo Luxms BI pasó una semana probando NVIDIA Nemotron 3 Super 120B en tarefas reales de análisis empresarial — 120B parámetros y 256K tokens de contexto en una sola GPU.
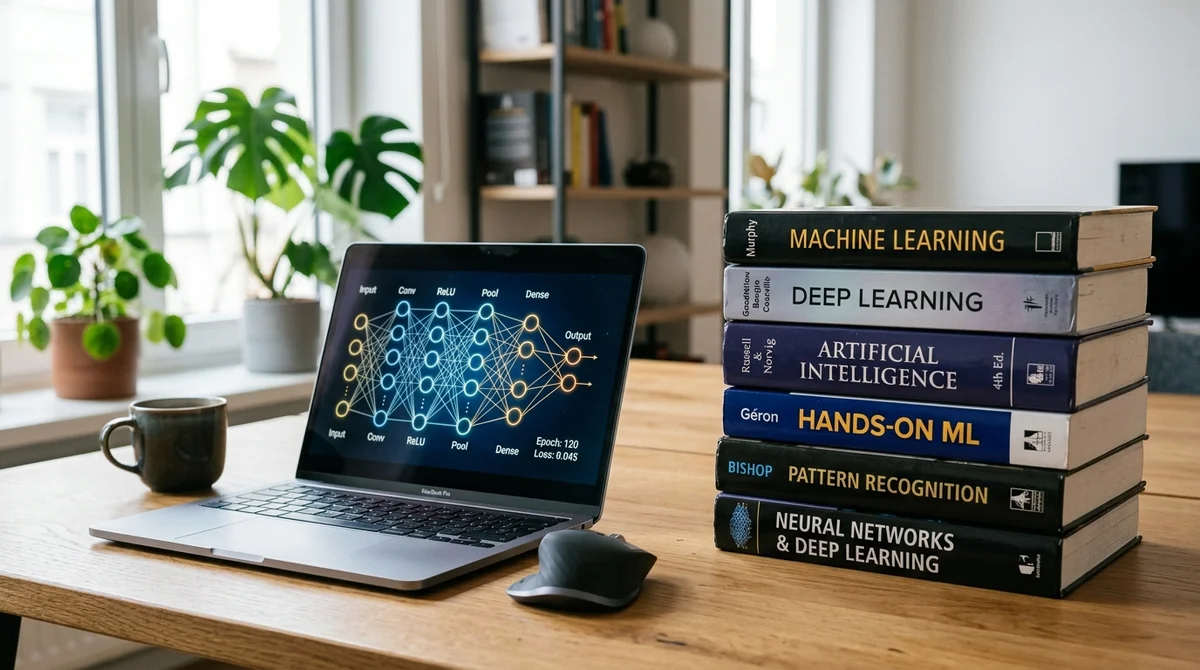
Se lanza bestseller internacional sobre grandes modelos de lenguaje en ruso
La editorial BHV publicó la traducción del bestseller internacional sobre LLM — una guía práctica para desarrolladores que necesitan entender cómo funcionan los modelos de lenguaje y aplicarlos en proyectos reales.

PSB mostró cómo implementa IA en el banco: chatbots, RAG y servicios para negocios
PSB reveló cómo utiliza IA generativa para PYMES y empleados: a través del asistente "Katyusha", consultoría RAG, pagos en mensajería y pilotos internos para ventas.
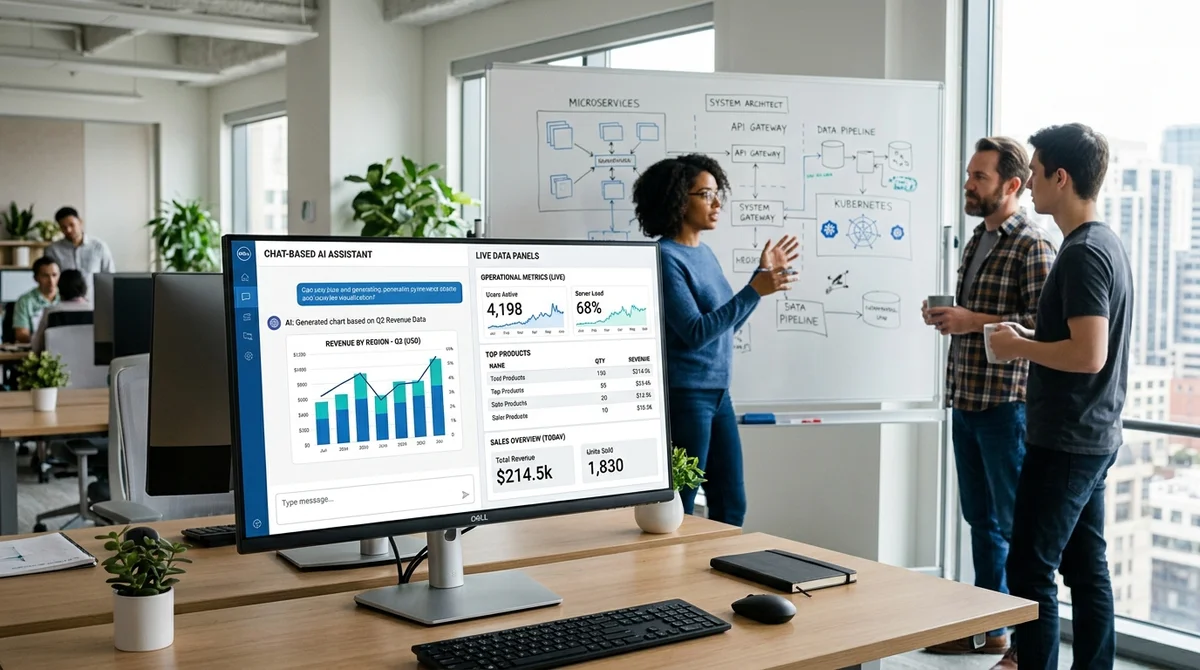
Yandex Cloud explica por qué el frontend lidera la integración de IA en DataLens
Yandex Cloud demostró a través de DataLens cómo mover la primera capa de integración de IA a un BFF frontend, permitiendo un lanzamiento más rápido del asistente de chat y gestión de contexto más cercana a la interfaz.
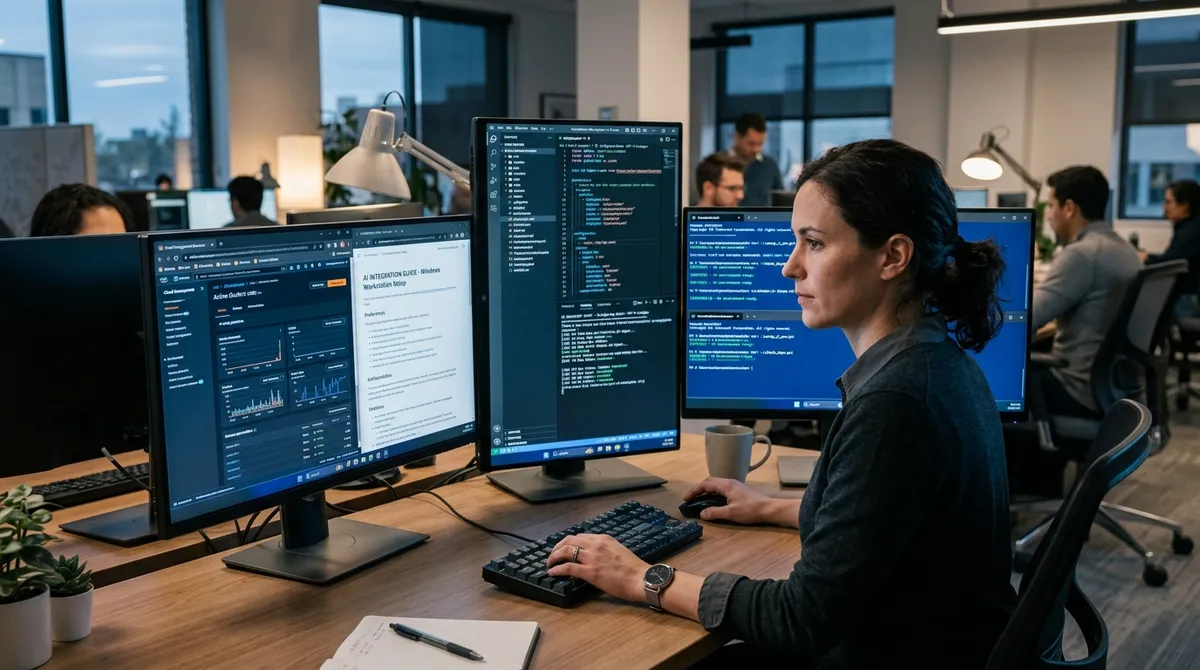
Claude Code en Windows: cómo configurar un entorno de trabajo estable y rápido
Un ingeniero del equipo AWS con 150+ cuentas documentó cómo lograr operación estable y rápida de Claude Code en Windows sin migrar a Linux, enfocándose en configuraciones de abril de 2026.
Anthropic, OpenAI y LangChain explicaron por qué los agentes de IA necesitan un harness
Anthropic, OpenAI y LangChain están desplazando el enfoque de los propios modelos al agent harness — una capa de orquestración, memoria y herramientas que hace que los agentes de IA sean resilientes en producción.
Anthropic y otros modelos de lenguaje pueden invocar herramientas ocultas sin permiso
Un investigador describió un fallo en el que Anthropic, Gemini y Grok pueden invocar una herramienta no autorizada si la función existe en el entorno y la validación de nombres en el lado de la API o cliente es débil.
Grupo fintech "Svoi" explica cómo hacer agentes LLM más baratos y precisos en código
El equipo del grupo fintech "Svoi" lanzó una guía práctica sobre cómo transformar LLM de "búsqueda mejorada" en un agente gestionado, reducir costos de tokens y aumentar la precisión de la generación de código.
Cómo un Autor de Habr Convirtió Siete Escenarios n8n en un Sistema Autónomo de Noticias de IA
En mes y medio, el autor transformó un frágil conjunto de siete escenarios n8n en un único pipeline Python con 11 workers, 5 agentes de IA, una LLM local y gestión a través de Telegram.
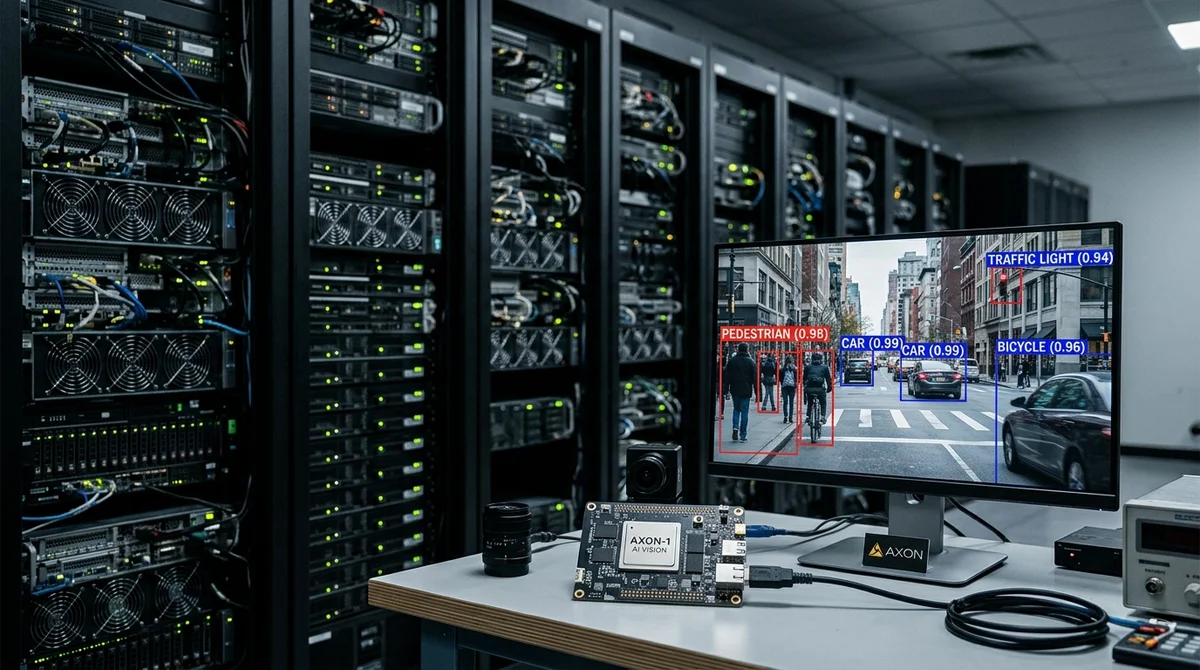
TAPe logra detección de nivel RF-DETR y YOLO en COCO con menos de 100 mil parámetros
Los autores de TAPe afirmaron haber logrado detección COCO al nivel de modelos RF-DETR y YOLO fuertes, manteniendo menos de 100 mil parámetros, 7-8 ms por fotograma, y reduciendo significativamente los requisitos de dato
Por qué OpenCode y modelos fuertes escriben pruebas verdes pero inútiles — y cómo solucionarlo
Un modelo reciente y un agente poderoso como OpenCode no ayudan si la base de código está llena de any-types, y el equipo pide a la IA que simplemente escriba pruebas sin especificación, restricciones y verificación.
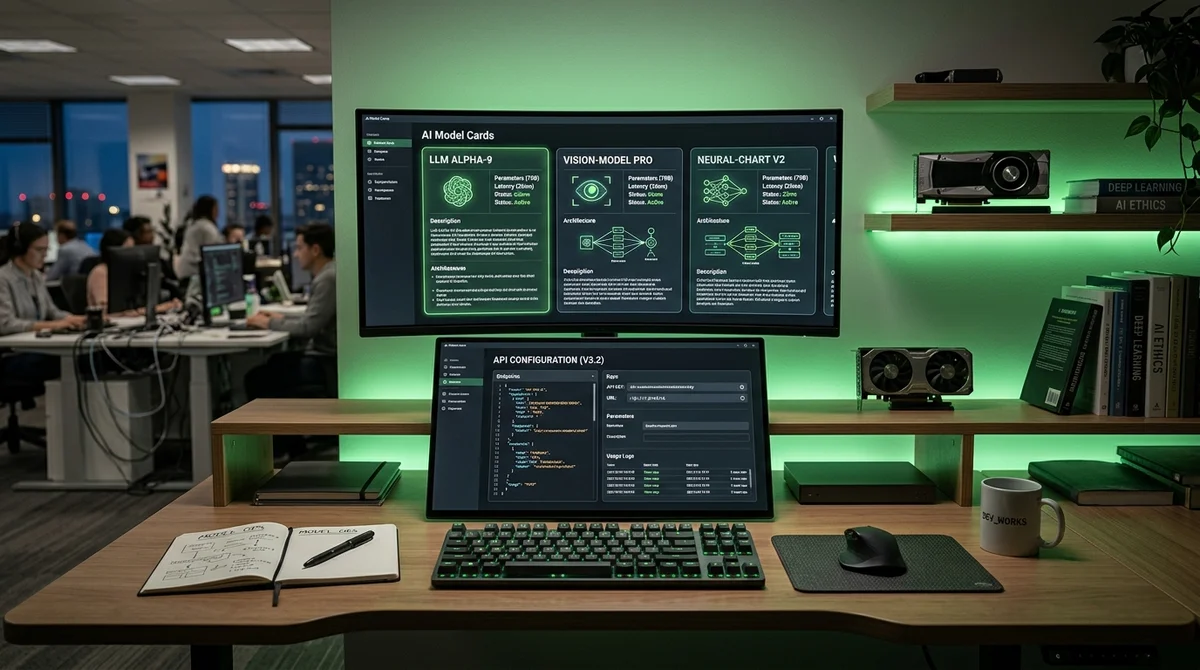
NVIDIA abrió acceso gratuito a API para más de 100 modelos de IA con compatibilidad OpenAI
NVIDIA comenzó a emitir claves gratuitas para acceder a más de 100 modelos de IA: los desarrolladores obtienen API compatible con OpenAI, límite de 40 solicitudes por minuto y acceso sin tarjeta de crédito.
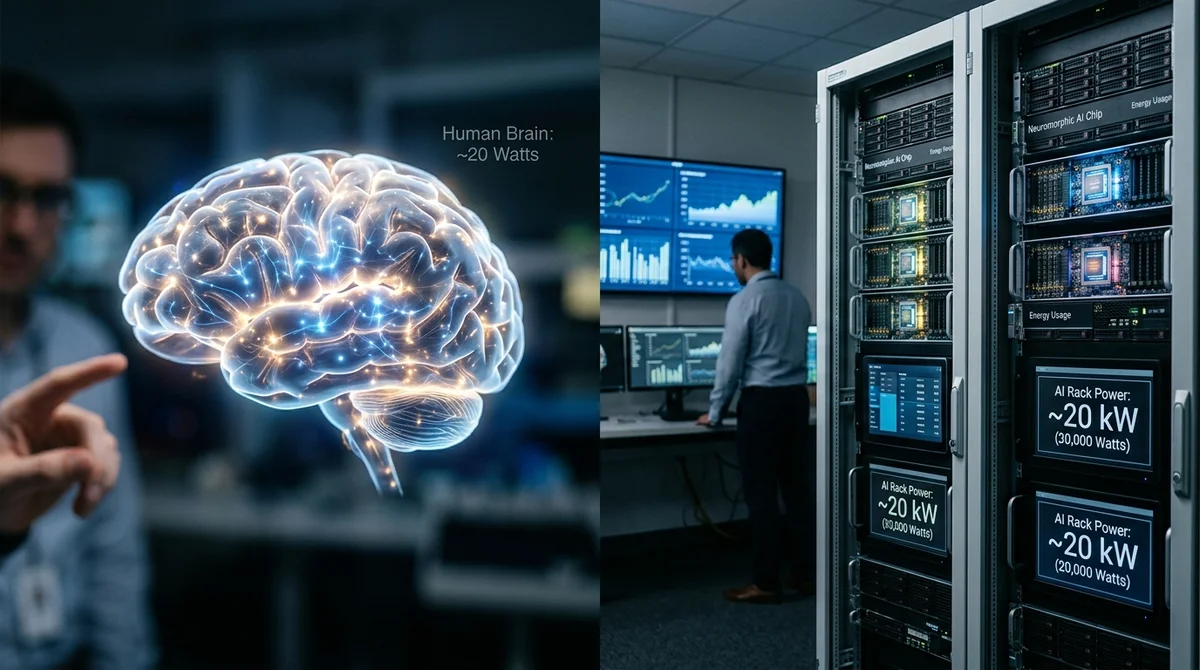
Por qué el cerebro es cientos de millones de veces más eficiente que GPT-4 y hacia dónde van los chips neuromórficos
El autor explora por qué el cerebro humano consume órdenes de magnitud menos energía para tareas cognitivas que GPT-4, y cómo los chips neuromórficos intentan cerrar esta brecha.
Investigación sobre ChatGPT: ¿afecta la forma gramatical femenina en el prompt a la calidad de resolución de tareas?
Un experimento del autor en LiveCodeBench mostró que en GPT-5.4 mini, la auto-presentación femenina en un prompt en ruso reduce ligeramente el pass@1, especialmente en tareas complejas.
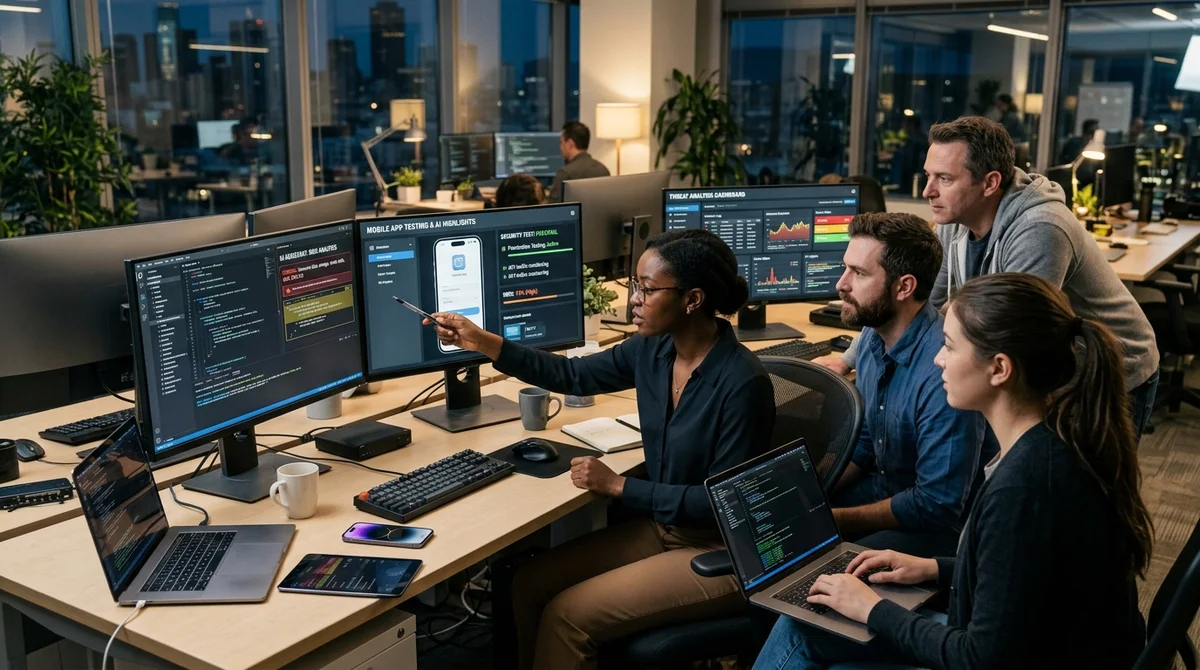
RuStore implementó IA en seguridad de la información: cómo VK automatiza la revisión de tareas, código y pruebas DAST
El equipo de seguridad de RuStore utiliza IA para el triaje inicial de tareas de seguridad, revisión de merge requests y pruebas dinámicas para reducir el trabajo rutinario de los ingenieros y acelerar el ciclo de lanzam
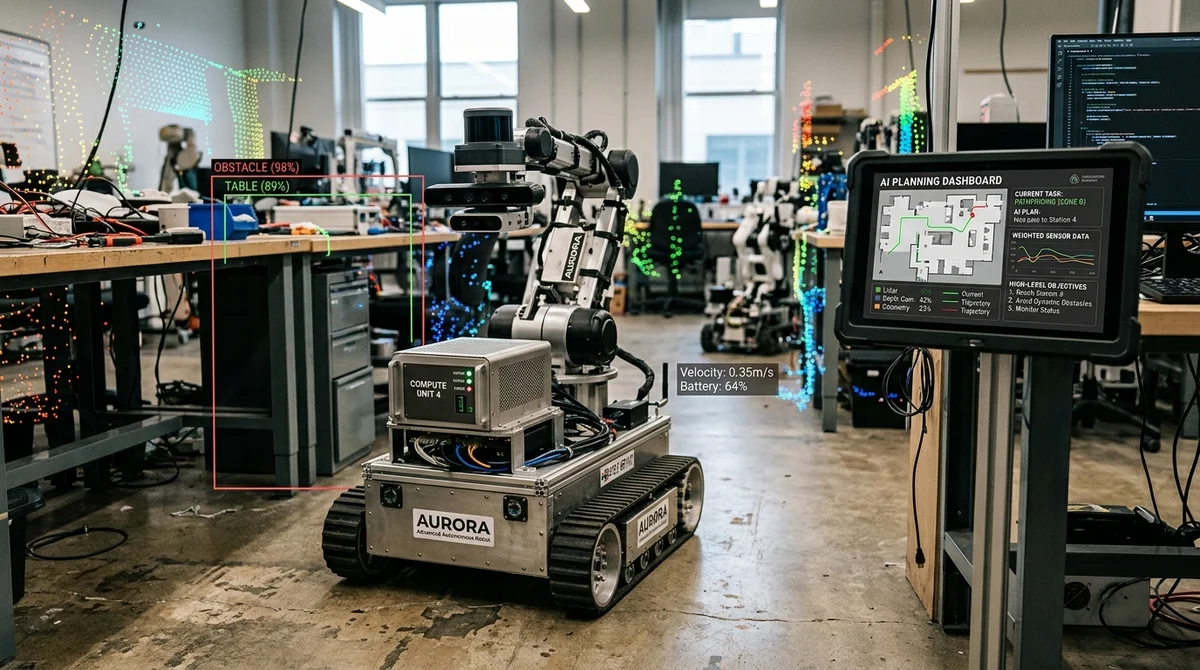
OpenGrall Presentó Arquitectura para Robots con IA donde el Modelo de Lenguaje Maneja la Estrategia
El framework OpenGrall propone dividir cognición y control: el modelo de lenguaje maneja estrategia, mientras que TinyML maneja ejecución y seguridad, reduciendo latencia incluso en hardware con recursos limitados.
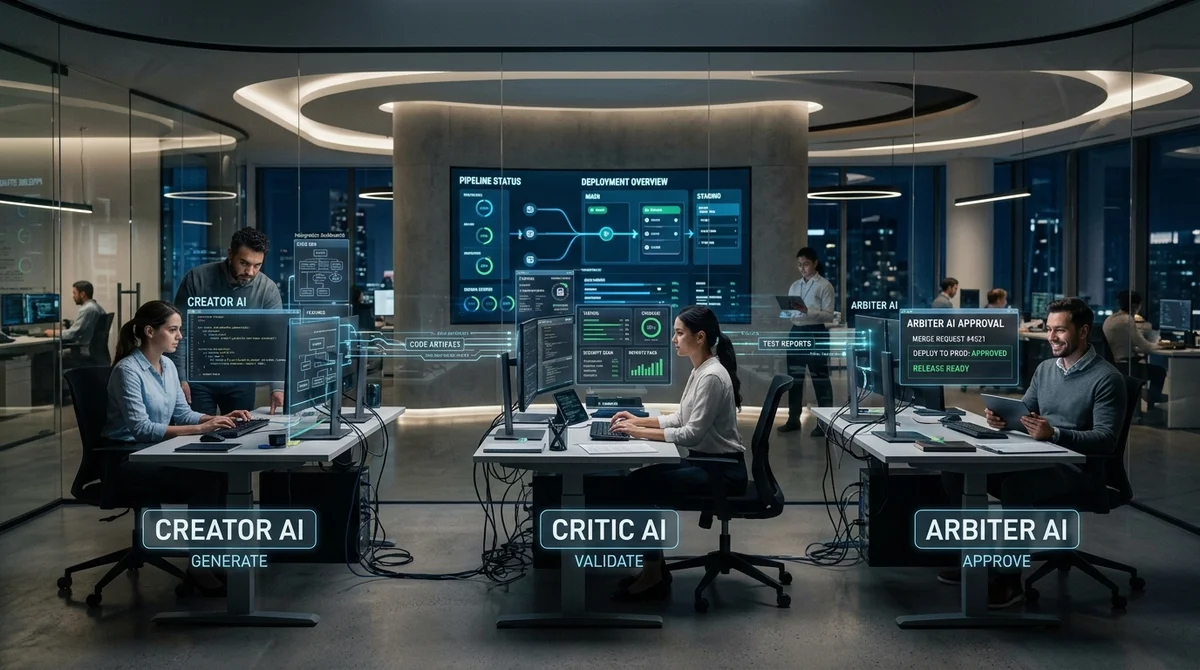
Habr AI: Cómo Pipeline Triad Arma un Pipeline de Agentes IA en Lugar de un Equipo de Desarrollo
Habr AI examinó Pipeline Triad — un modelo donde las etapas de desarrollo pasan a través de tríadas de agentes IA, con humanos involucrados solo en cuatro puntos de control.
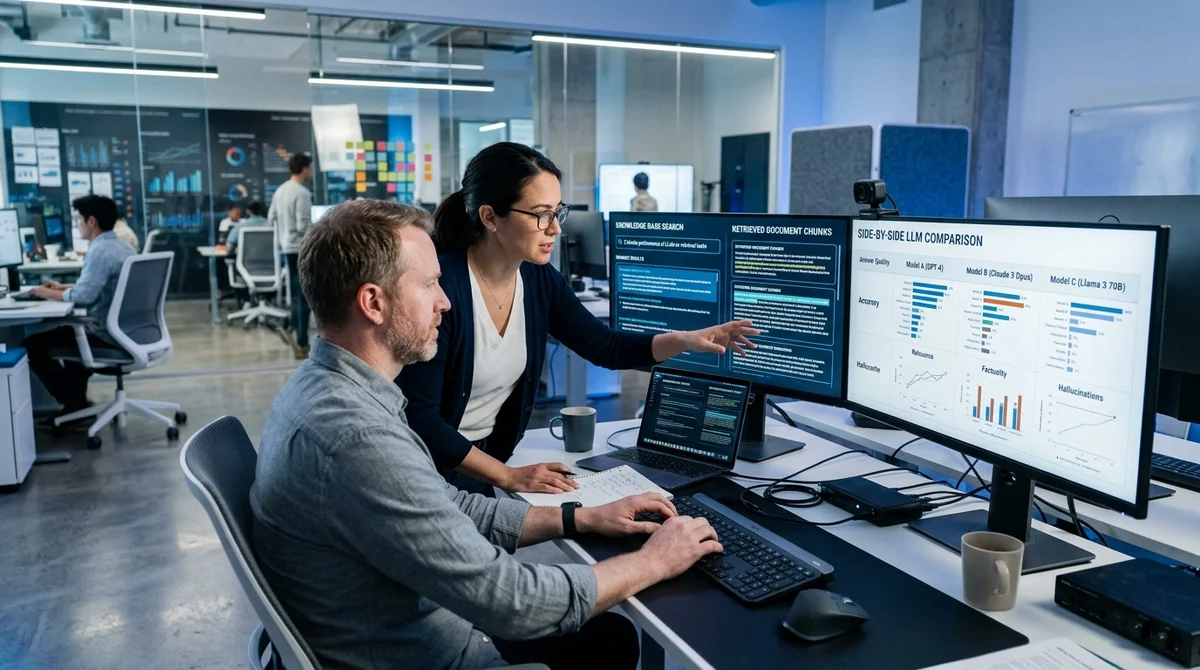
Gramax mostró cómo comparar la calidad de respuestas RAG sin evaluación manual subjetiva
Gramax explicó por qué las métricas de retrieval son insuficientes para RAG y propuso evaluar no los chunks recuperados, sino la respuesta final del usuario — por completitud, precisión y robustez.
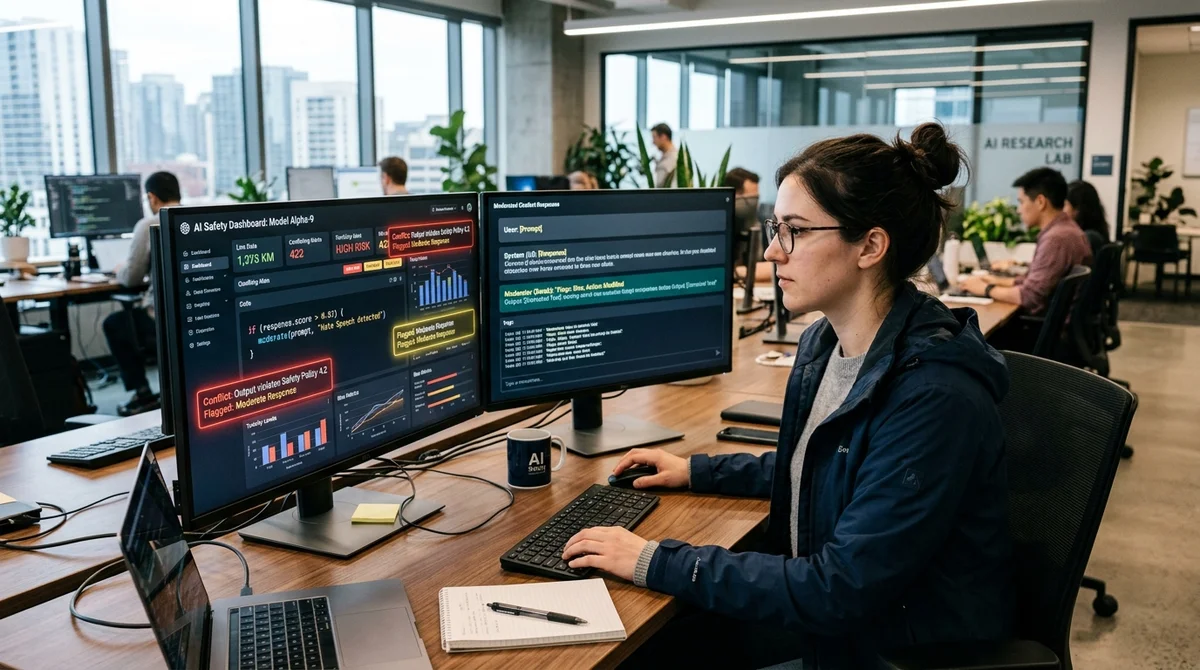
Cómo los guardrails para LLM en Java bloquean inyecciones y respuestas tóxicas
Un análisis de por qué un único system prompt es insuficiente para proteger LLMs, y cómo los guardrails en Java interceptan entradas peligrosas y filtran salidas tóxicas o no deseadas del modelo.
Anthropic y Mythos: por qué una amenaza para los bancos rápidamente se convirtió en un riesgo para todos
Anthropic presentó Mythos como demasiado peligrosa para acceso público, pero el verdadero riesgo resultó no estar en la banca sino en la incapacidad de las pequeñas empresas para cerrar vulnerabilidades antes de los ataq
Anthropic y Claude Mythos: por qué los críticos llaman al lanzamiento del modelo un espectáculo de relaciones públicas caro
Una columna crítica sobre Claude Mythos sostiene que Anthropic vende no solo un modelo de IA, sino un mito sobre su naturaleza casi humana, amplificando la escasez y la demanda entre corporaciones.
Asistentes de IA en 2026: Cómo un Desarrollador Solo Se Volvió Más Rápido que un Equipo de Tres Personas
El autor demuestra que en 2026, un único desarrollador equipado con un conjunto de herramientas de IA de código abierto puede escribir, probar y hacer commits de código más rápido que lo que un pequeño equipo podía hace
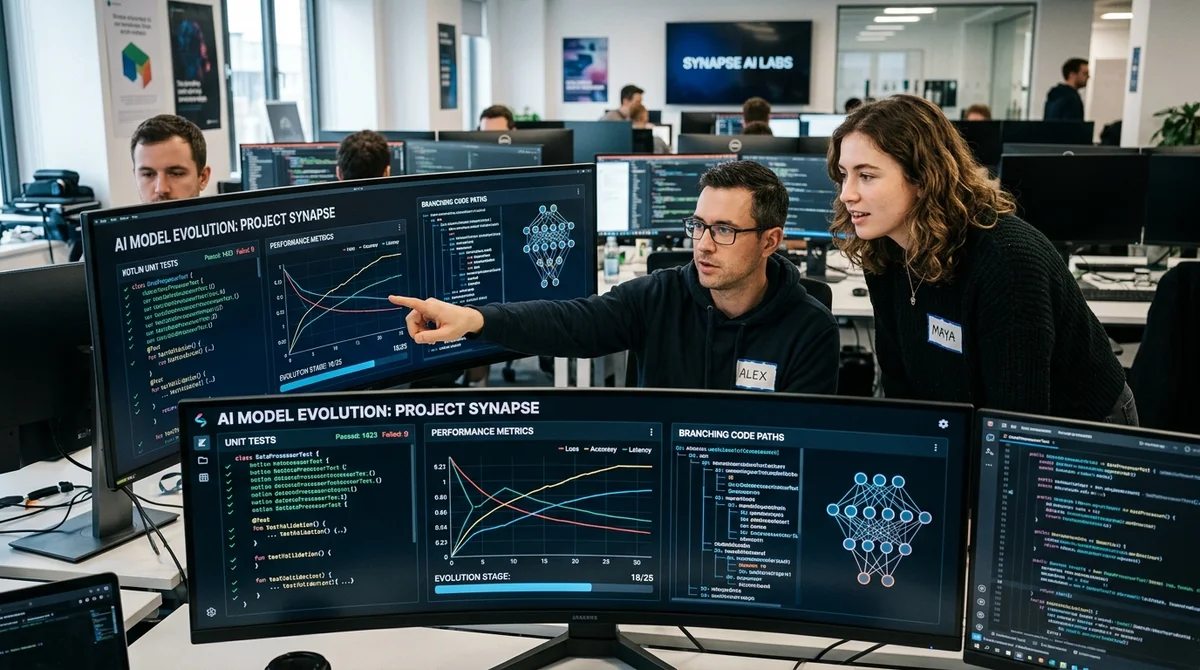
ecom.tech comparó el ajuste fino evolutivo de Qwen3-4B con SFT y GRPO para pruebas en Kotlin
El equipo de ecom.tech ajustó finamente Qwen3-4B-Instruct para generar pruebas unitarias en Kotlin y demostró que el algoritmo evolutivo supera a SFT y GRPO en métricas de calidad, pero degrada las capacidades generales
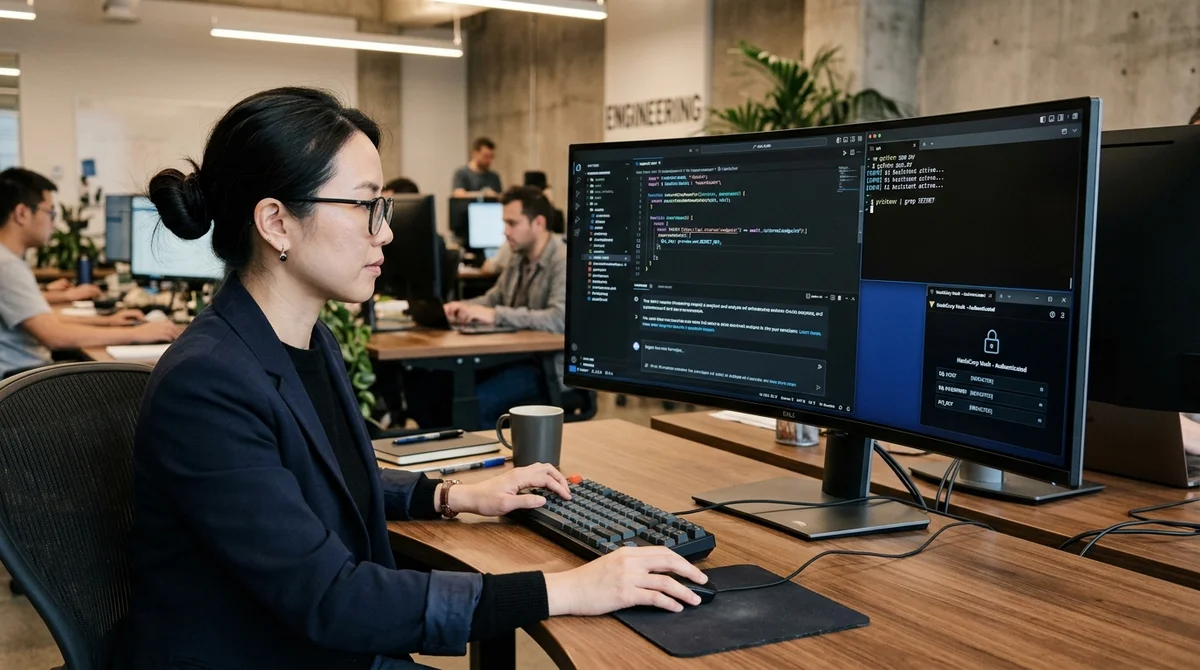
Yandex Code Assistant probado en manejo de secretos y comparado con Cursor
Un ingeniero de 'Infosystems Jet' probó Yandex Code Assistant en manejo de secretos y demostró que el agente ya está cerca de Cursor, pero aún requiere supervisión del desarrollador.
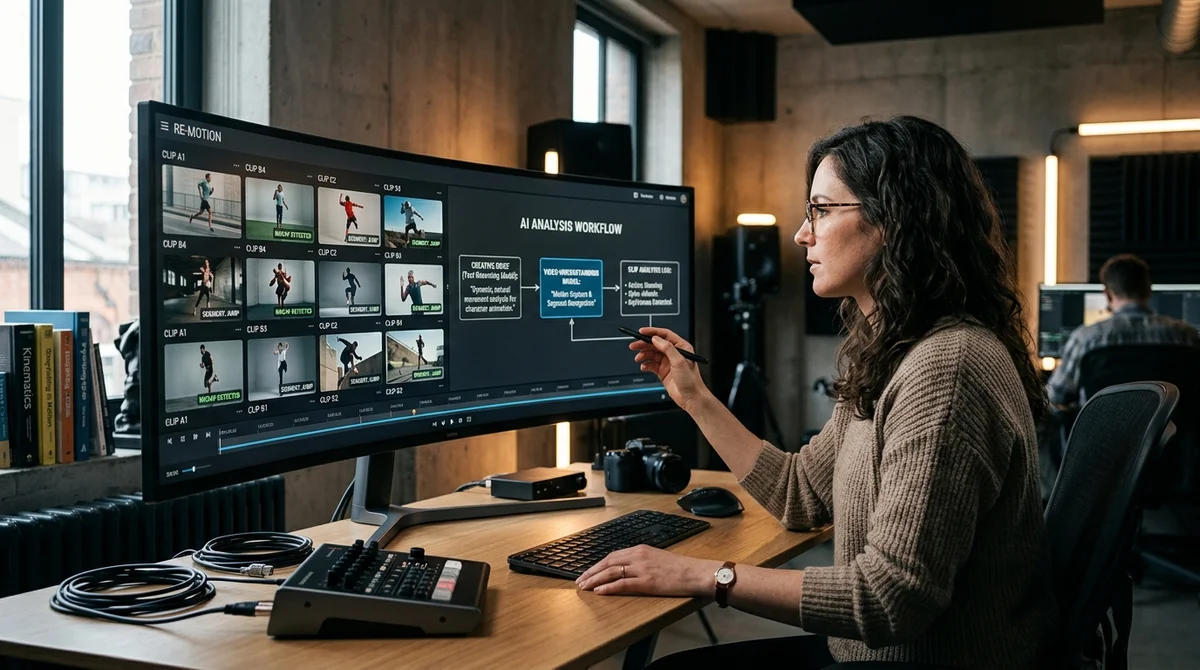
Claude y Qwen Omni: cómo un desarrollador integró análisis de vídeo en su pipeline de producción
Un autor en Habr conectó Claude con Qwen Omni para sortear la falta de procesamiento nativo de vídeo y categorizar automáticamente 29 referencias de animación por movimiento y tipo.