Sber muestra cómo RAG y un LLM dentro del IDE convierten guiones manuales en pruebas automatizadas
Sber ha presentado un prototipo para los IDE de JetBrains que genera pruebas automatizadas a partir de escenarios manuales combinando un LLM con RAG. El sistema busca pasos y tests relevantes en el propio proyecto, conserva el estilo del código y comprueba el resultado mediante PSI. Dentro de la compañía, el 68% de las pruebas generadas requirió solo correcciones mínimas, y la satisfacción de los usuarios fue de alrededor del 80%.
Procesado por IA desde Habr AI; editado por Hamidun News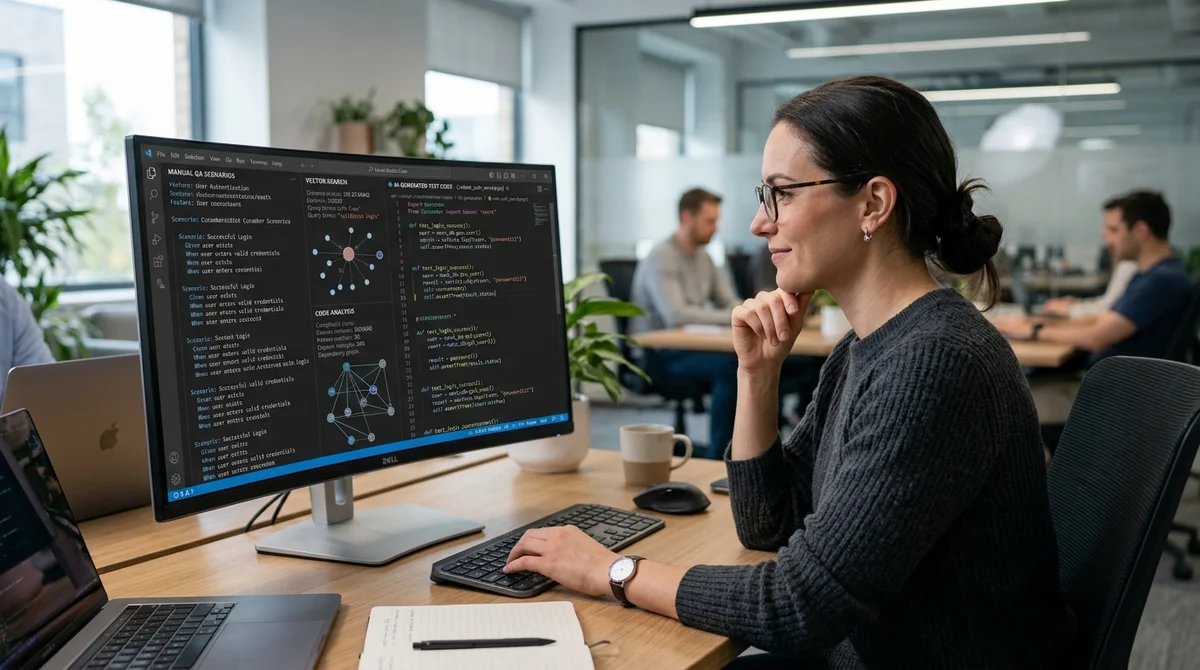
Sber ha mostrado cómo reducir una de las tareas más rutinarias del QA: convertir escenarios manuales en pruebas automatizadas directamente en el IDE. La base es una combinación de LLM y RAG que no se limita a escribir código, sino que primero busca ejemplos relevantes en el propio proyecto para conservar su estilo, sus convenciones y su arquitectura.
Por qué no funciona un prompt directo
La idea de «enviar el test manual al modelo y recibir el código listo» se rompe en los detalles. Un LLM sí puede montar un test en Java que funcione, pero casi seguro no lo hará como se hace en un equipo concreto: olvidará Allure, romperá el esquema de nombres, colocará la URL y el cuerpo de la petición donde no toca, añadirá comprobaciones superfluas o no usará utilidades internas, como un método común de verificación de estado. En la automatización de pruebas esto no es algo cosmético, sino una pérdida real de compatibilidad con el proyecto.
El problema es más profundo que la calidad del prompt. Los autotests viven en su propio framework y dependen de la arquitectura, el CI, Page Object, las claves de TMS y las convenciones de anotaciones. Si se intenta pasar al modelo todo el proyecto, enseguida se chocan los límites de la ventana de contexto, el aumento de la latencia y el coste de las solicitudes. Incluso así siguen las alucinaciones, los pasos omitidos y un resultado inestable que hay que llevar a mano al estado deseado.
Cómo funciona RAG
En lugar del few-shot estático con ejemplos elegidos a mano, el equipo de Sber creó un plugin para los IDE de JetBrains. Escanea el proyecto a través de la estructura PSI, no como texto sin procesar, por lo que ve clases, métodos, anotaciones y llamadas. Con esa base, el sistema reúne pasos de Allure, autotests existentes, sus claves de TMS, el código y breves descripciones textuales. Después, esas descripciones se convierten en embeddings y se guardan junto con los metadatos en una base de conocimiento local o en un almacén vectorial.
Cuando llega un nuevo escenario manual, el sistema pasa por varias etapas:
- extrae la acción y el resultado esperado de cada paso;
- construye varias variantes semánticas de la consulta para buscar pasos similares;
- pide al LLM que describa brevemente todo el test para encontrar un autotest cercano por significado;
- inserta automáticamente los ejemplos encontrados en el prompt en lugar del few-shot manual;
- verifica el resultado con una nueva consulta al modelo y mediante PSI dentro del IDE.
Este enfoque permite obtener código que parece escrito por alguien de ese equipo, y no por un modelo externo sin contexto. El artículo subraya que la búsqueda semántica no está ahí por moda del RAG, sino con un fin práctico: llevar a la generación justo los pasos, utilidades y patrones que ya han demostrado funcionar dentro del proyecto.
RAG es un few-shot que encuentra por sí mismo los ejemplos necesarios.
Resultados del prototipo
Según el equipo, el prototipo interno ya ha logrado un efecto medible. Alrededor del 68% de las pruebas generadas alcanzó un nivel aceptable y requirió solo correcciones mínimas, y la satisfacción general de los usuarios fue de aproximadamente el 80%. La herramienta rindió mejor en escenarios de API sencillos y parecidos, donde más importa reproducir rápido una plantilla de código establecida sin copiar a mano de tests vecinos. Los ingenieros de automatización también señalaron una menor carga cognitiva: se dedica menos tiempo a la rutina y más a escenarios complejos y decisiones de arquitectura.
Pero aquí no hay un «piloto automático» universal. El modelo sigue tendiendo a simplificar los tests complejos con muchos pasos, y para los escenarios de UI necesita más contexto, por ejemplo información sobre los objetos de la página. Las alucinaciones tampoco han desaparecido, así que la revisión final sigue siendo obligatoria. Los autores señalan además que no vieron limitaciones serias por lenguaje: se obtuvieron resultados similares no solo con Java, sino también con Python y Gherkin. Según su estimación, una herramienta así puede ahorrar al ingeniero de automatización más de la mitad del tiempo de escribir nuevos tests rutinarios.
Qué significa
Para las herramientas de IA en desarrollo empieza una etapa más interesante: el valor pasa de «generar cualquier código» a «generar código que se integre de inmediato en un proyecto vivo». El caso de Sber indica que en QA no ganarán los equipos que simplemente conecten un LLM al IDE, sino los que envuelvan el modelo en su propia base de conocimiento, sus verificaciones y sus reglas de ingeniería.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué no funciona un prompt directo?
La idea de «enviar el test manual al modelo y recibir el código listo» se rompe en los detalles. Un LLM sí puede montar un test en Java que funcione, pero casi seguro no lo hará como se hace en un equipo concreto: olvidará Allure, romperá el esquema de nombres, colocará la URL y el cuerpo de la petición donde no toca, añadirá comprobaciones superfluas o no usará utilidades internas, como un método común de verificación de estado. En la automatización de pruebas esto no es algo cosmético, sino una pérdida real de compatibilidad con el proyecto. El problema es más profundo qu
Cómo funciona RAG?
En lugar del few-shot estático con ejemplos elegidos a mano, el equipo de Sber creó un plugin para los IDE de JetBrains. Escanea el proyecto a través de la estructura PSI, no como texto sin procesar, por lo que ve clases, métodos, anotaciones y llamadas. Con esa base, el sistema reúne pasos de Allure, autotests existentes, sus claves de TMS, el código y breves descripciones textuales. Después, esas descripciones se convierten en embeddings y se guardan junto con los metadatos en una base de conocimiento local o en un almacén vectorial. Cuando llega un nuevo escenario manual
¿Qué se sabe sobre Resultados del prototipo?
Según el equipo, el prototipo interno ya ha logrado un efecto medible. Alrededor del 68% de las pruebas generadas alcanzó un nivel aceptable y requirió solo correcciones mínimas, y la satisfacción general de los usuarios fue de aproximadamente el 80%. La herramienta rindió mejor en escenarios de API sencillos y parecidos, donde más importa reproducir rápido una plantilla de código establecida sin copiar a mano de tests vecinos. Los ingenieros de automatización también señalaron una menor carga cognitiva: se dedica menos tiempo a la rutina y más a escenarios complejos y deci
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.