Leman Tech muestra cómo combinó LLM, RAG y ML clásico en su soporte técnico
Leman Tech explicó cómo rediseñó su soporte tras el aumento de solicitudes: la clasificación masiva se quedó en manos del ML clásico, y el LLM con RAG se activa solo para consultas complejas de dominio en el entorno corporativo. El enfoque elevó la clasificación automatizada al 76%, aceleró las respuestas exitosas más de 20 veces y descargó a los especialistas más caros, sin riesgos adicionales, retrasos ni automatización ciega.
Procesado por IA desde Habr AI; editado por Hamidun News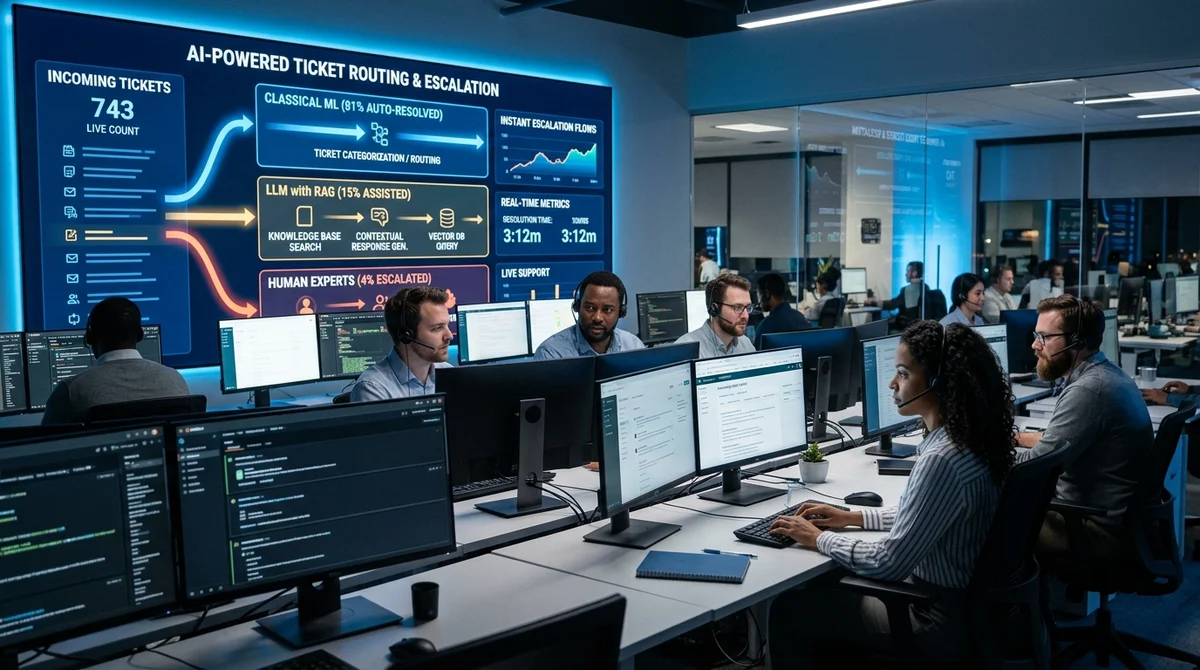
Leman Tech explicó cómo rediseñó la automatización de su Service Desk tras el aumento del flujo de solicitudes. La empresa no sustituyó todo el soporte por un único modelo grande, sino que montó un esquema híbrido: dejó la clasificación masiva al ML clásico y incorporó el LLM con RAG solo donde aporta un beneficio real.
Por qué el ML antiguo se queda corto
El ecosistema de Leman Tech incluye más de 500 sistemas de negocio, 2500 operaciones de servicio y unas 100 mil solicitudes de soporte al mes. Con esa carga importan no solo la calidad del modelo, sino también el coste de un error, la velocidad de reacción y el coste de cómputo.
La pila básica de boosting y TF-IDF funcionó bien durante mucho tiempo. Un modelo con rasgos adicionales, como el puesto, el lugar de trabajo y la hora de la solicitud, alcanzaba un F1 de en torno a 0,86 y cubría una gran parte de las rutas habituales. Pero al crecer el número de escenarios, dejó de bastar.
El equipo probó LSTM, GRU, BERT, RoBERTa, Electra, Yandex Foundation Models y adaptadores LoRA para LLM abiertos. Algunos enfoques perdieron frente al boosting en las métricas y otros resultaron demasiado caros de entrenar. Al final, el mejor resultado en clasificación no lo dio un enfoque «puro» de LLM, sino un transformer con rasgos tabulares adicionales y additive attention: ese esquema subió el F1 macro a 0,89 y tuvo mejor en cuenta el contexto de cada empleado.
Dónde se activa el RAG
El LLM de esta arquitectura no intenta resolverlo todo. Se activa solo en las clases de solicitudes en las que el usuario necesita una respuesta con sentido basada en la documentación interna, y no solo un enrutamiento correcto del ticket.
Un ejemplo es el soporte de la plataforma MLOps, donde los empleados necesitan respuestas sobre Kubeflow, Jenkins y los pipelines internos. Aquí la solicitud llega al chat, pasa por el clasificador y entra en un circuito RAG basado en Qwen2.5 8B con un embedder personalizado. Si la respuesta está en la base de conocimiento, el usuario la recibe en unos 60 segundos. Si el modelo no está seguro del resultado, o la persona pulsa el comando para pasar a un especialista, el ticket va directo a un experto humano sin esperar según el SLA habitual.
Es un punto importante: el LLM no se interpone como barrera adicional ante la persona, sino que funciona como una primera capa rápida donde se puede ahorrar el tiempo de los costosos especialistas de nivel L4 sin perder el control de la calidad.
- Qwen2.5 8B se usa en una versión cuantizada para CPU
- El embedder personalizado se entrenó con 10 mil tripletes
- La precisión de la búsqueda en la base de conocimiento llegó al 92% en Hit@3
- La escalada se activa cuando el confidence score es inferior a 0,7
- El usuario puede cambiar al instante a una persona
Lo que funcionó mejor
Una parte aparte del caso son las autorresoluciones. El equipo encontró patrones de solicitudes recurrentes que se pueden cerrar sin intervención del soporte, pero no automatizó a ciegas todas las respuestas frecuentes. Para la selección usó Qwen2.5 14B: el modelo evaluaba si una persona podría resolver realmente el problema por sí sola siguiendo las instrucciones, o si sin un empleado no saldría nada. Eso descartó plantillas falsas, como el restablecimiento de contraseña, donde el correo es estándar pero la acción debe ejecutarla igualmente un especialista.
«No conviene usar LLM en todas partes, como está de moda ahora».
Tras esa selección, en producción vuelve a funcionar no un LLM, sino un modelo ligero: regresión logística. Aprende rápido, casi no cuesta nada en inferencia y puede atender de forma continua el flujo de solicitudes.
Como resultado, Leman Tech habla de un aumento de la clasificación automatizada del 55% al 76%, de una precisión de clasificación de hasta el 92% teniendo en cuenta los umbrales y de una aceleración de más de 20 veces en las autorresoluciones exitosas y las respuestas del bot. El LLM no sustituyó aquí al ML clásico, sino que ocupó un lugar estrecho pero valioso en la cadena.
Qué significa
El caso de Leman Tech ilustra bien la lógica madura actual de adopción de la IA generativa en el soporte: los LLM caros no tienen por qué ser el núcleo de todo el sistema. A menudo el mejor resultado lo da un híbrido en el que el ML clásico ordena rápido el flujo, el RAG responde solo en las zonas de dominio complejas y una persona interviene sin fricción si la confianza del modelo no basta. Para los equipos corporativos, probablemente es un camino más realista que intentar trasladar todo el Service Desk a un único modelo universal.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué el ML antiguo se queda corto?
El ecosistema de Leman Tech incluye más de 500 sistemas de negocio, 2500 operaciones de servicio y unas 100 mil solicitudes de soporte al mes. Con esa carga importan no solo la calidad del modelo, sino también el coste de un error, la velocidad de reacción y el coste de cómputo. La pila básica de boosting y TF-IDF funcionó bien durante mucho tiempo. Un modelo con rasgos adicionales, como el puesto, el lugar de trabajo y la hora de la solicitud, alcanzaba un F1 de en torno a 0,86 y cubría una gran parte de las rutas habituales. Pero al crecer el número de escenarios, dejó de
Dónde se activa el RAG?
El LLM de esta arquitectura no intenta resolverlo todo. Se activa solo en las clases de solicitudes en las que el usuario necesita una respuesta con sentido basada en la documentación interna, y no solo un enrutamiento correcto del ticket. Un ejemplo es el soporte de la plataforma MLOps, donde los empleados necesitan respuestas sobre Kubeflow, Jenkins y los pipelines internos. Aquí la solicitud llega al chat, pasa por el clasificador y entra en un circuito RAG basado en Qwen2.5 8B con un embedder personalizado. Si la respuesta está en la base de conocimiento, el usuario la
¿Qué se sabe sobre Lo que funcionó mejor?
Una parte aparte del caso son las autorresoluciones. El equipo encontró patrones de solicitudes recurrentes que se pueden cerrar sin intervención del soporte, pero no automatizó a ciegas todas las respuestas frecuentes. Para la selección usó Qwen2.5 14B: el modelo evaluaba si una persona podría resolver realmente el problema por sí sola siguiendo las instrucciones, o si sin un empleado no saldría nada. Eso descartó plantillas falsas, como el restablecimiento de contraseña, donde el correo es estándar pero la acción debe ejecutarla igualmente un especialista. «No conviene us
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.