Habr AI muestra cómo una arquitectura de reflejos para agentes LLM elimina el lag hasta los 60 fps
Habr AI ha mostrado cómo resolver el principal problema de los agentes de IA en videojuegos, asistentes y robótica: una latencia de 1–3 segundos. El equipo dividió el sistema en dos circuitos: uno reflejo y rápido, y otro más lento, basado en un LLM, dedicado al reasoning. Como resultado, el agente puede reaccionar en milisegundos, cambiar su comportamiento sobre la marcha y aprender durante la propia sesión. Además, no rompe la sensación de interacción viva, ni siquiera en una escena dinámica.
Procesado por IA desde Habr AI; editado por Hamidun News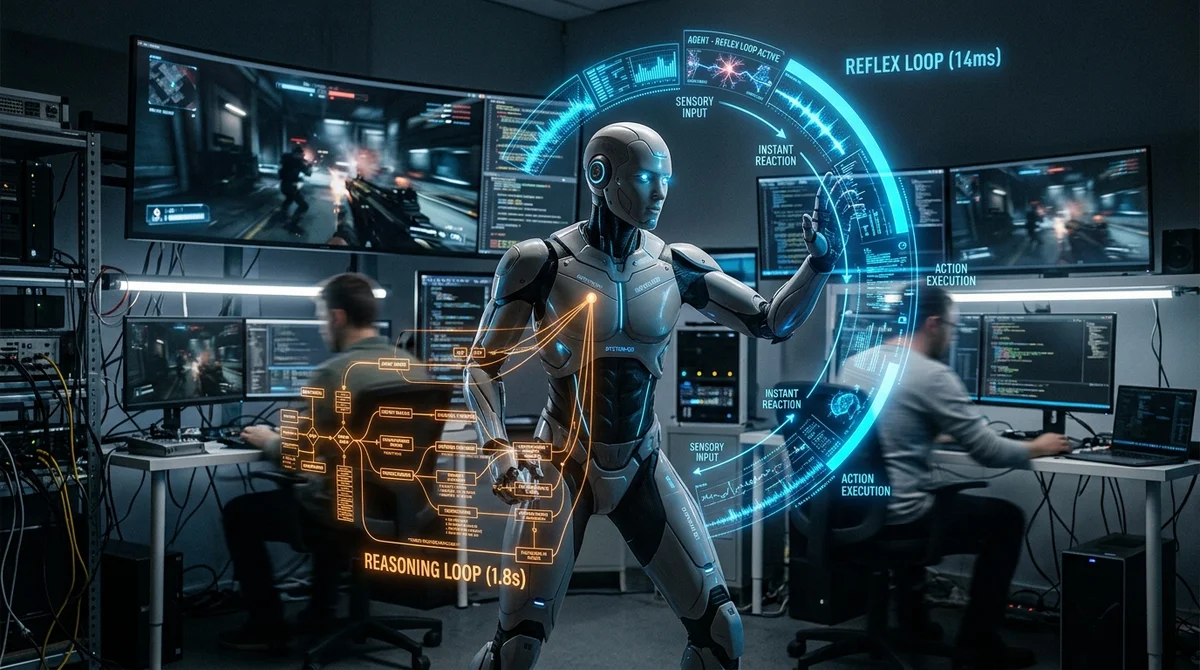
Habr AI ha publicado un análisis de una arquitectura que dota a los agentes LLM de una especie de «médula espinal»: una capa rápida de reflejos que funciona por encima del reasoning lento. El objetivo es eliminar la pausa habitual de 1–3 segundos y conseguir que los NPC de los videojuegos, los asistentes de voz y los robots reaccionen de forma casi instantánea.
Dónde se rompe la velocidad
El problema resulta familiar para cualquiera que haya intentado integrar un modelo de lenguaje grande en un entorno interactivo. El agente recibe el audio, reúne el contexto, envía la petición, espera la respuesta del modelo y la convierte en una animación o una acción. Todo ese proceso lleva demasiado tiempo. En un chat, ese retraso es tolerable, pero en un videojuego, un robot o una interfaz viva supone un fracaso de UX: el usuario no percibe inteligencia, sino un cuelgue. Por eso, incluso un modelo potente suele dar la impresión de ser «listo, pero lento».
Los autores comparan este tipo de integración con montar el motor de un transbordador espacial en una carreta: la potencia de cálculo existe, pero no logra traducirse en un comportamiento real. Con su prototipo, la atención del público se centró en la capa visual y no en el propio motor. En lugar de debatir sobre la inferencia, el equipo recibió críticas por la salida de depuración en bruto y la calidad de los fotogramas. Es decir, la discusión giró en torno a la imagen, cuando la verdadera noticia era que el sistema ya intentaba mantener el ritmo del tiempo real.
«Es pronto para presumir de “60 FPS reales”.
Lo que tenéis ahí es un caleidoscopio de fotogramas caóticos, imagen borrosa y dedos deformes».
Sistema 1 y 2
La solución fue una Dual-Process Architecture, que divide al agente en un circuito rápido y otro lento. La primera capa funciona como un sistema reflejo: vigila los eventos y dispara reacciones inmediatas sin esperar a que el modelo complete su razonamiento. La segunda capa sigue en manos del LLM y se ocupa de las tareas más costosas: interpretar contextos complejos, planificar, elegir las réplicas y reajustar el comportamiento. Así, el agente puede reaccionar primero y «pensar» después, igual que hace una persona en el mundo real.
En este enfoque es crucial no obligar al LLM a ser el único centro ejecutivo. El reasoning lento funciona bien cuando se necesita profundidad, pero encaja mal con los movimientos, los microgestos, los giros rápidos de cámara, la reacción ante colisiones o las respuestas de voz breves. Una arquitectura de dos velocidades elimina este conflicto: la interfaz y el cuerpo del agente operan en milisegundos, mientras que el significado y la estrategia funcionan en un ciclo más largo. Precisamente este desacoplamiento permite no perder fotogramas ni hacer esperar al usuario antes de cada gesto o réplica.
Según los autores, este esquema aporta además dos ventajas difíciles de lograr en un pipeline monolítico: la personalidad puede cambiarse sobre la marcha y el agente puede incorporar nuevos patrones de comportamiento mientras está en funcionamiento. Esto es especialmente importante para NPC, asistentes y robótica, donde el agente no debe limitarse a responder, sino adaptarse de forma continua al entorno. En un esquema convencional, estos cambios exigen una nueva petición al modelo y vuelven a toparse con la latencia.
El efecto práctico del enfoque
Si los reflejos se sacan del pesado circuito del LLM, no solo cambia la latencia, sino también la sensación de que el sistema está «vivo». El usuario deja de esperar a que la inteligencia complete todo el recorrido de la cadena y empieza a ver un comportamiento continuo. Para los equipos de producto, se trata de un cambio importante: la calidad de un agente ya no se mide por lo vistoso de un fotograma de demo, sino por la naturalidad con la que mantiene el ritmo de la interacción.
En un producto interactivo, esto suele importar más que un texto perfecto, porque la sensación de presencia se rompe antes de que el usuario pueda valorar la profundidad de la respuesta.
- Reacciones instantáneas a eventos, sonidos, obstáculos y órdenes
- Integración fluida entre generación, animación y control
- Cambio rápido de rol, carácter o estilo de respuesta
- Aprendizaje y ajuste del comportamiento sin reiniciar por completo el agente
En esencia, el equipo propone ver el LLM no como el único cerebro del sistema, sino como una de sus capas. Esto cambia la perspectiva de ingeniería: en lugar de librar una batalla interminable contra la latencia de red y una inference pesada, surge la posibilidad de diseñar un motor independiente para el tiempo real. Sí, la visualización del prototipo puede estar poco pulida. Pero si la capa refleja ya mantiene el ritmo, el pulido de los gráficos, las manos y los fotogramas puede llegar en la siguiente iteración.
Qué significa esto
Este caso ilustra bien hacia dónde se dirigen los agentes de IA: hacia sistemas híbridos en los que los reflejos rápidos están separados del reasoning lento. Para quienes desarrollan videojuegos, asistentes de voz y embodied AI, es un paso casi obligatorio: sin él, incluso el mejor LLM parecerá lento y torpe.
- 28 oct 2026Anthropic revela cómo construye Claude con el propio Claude: el cerebro, separado de las manos
- 28 oct 2026Bayer lanza un motor multiagente sobre AgentCore: el 80% de las consultas, sin ingenieros
- 28 oct 2026Liquid AI lanza LFM2.5-24B-A2B: un modelo para agentes con 2B de parámetros activos
- 28 oct 2026AgentOrch: el plan de IA trazado por adelantado ya solo pierde por 8,5 puntos frente al paso a paso
Preguntas frecuentes sobre la noticia
Dónde se rompe la velocidad?
El problema resulta familiar para cualquiera que haya intentado integrar un modelo de lenguaje grande en un entorno interactivo. El agente recibe el audio, reúne el contexto, envía la petición, espera la respuesta del modelo y la convierte en una animación o una acción. Todo ese proceso lleva demasiado tiempo. En un chat, ese retraso es tolerable, pero en un videojuego, un robot o una interfaz viva supone un fracaso de UX: el usuario no percibe inteligencia, sino un cuelgue. Por eso, incluso un modelo potente suele dar la impresión de ser «listo, pero lento». Los autores co
¿Qué se sabe sobre Sistema 1 y 2?
La solución fue una Dual-Process Architecture, que divide al agente en un circuito rápido y otro lento. La primera capa funciona como un sistema reflejo: vigila los eventos y dispara reacciones inmediatas sin esperar a que el modelo complete su razonamiento. La segunda capa sigue en manos del LLM y se ocupa de las tareas más costosas: interpretar contextos complejos, planificar, elegir las réplicas y reajustar el comportamiento. Así, el agente puede reaccionar primero y «pensar» después, igual que hace una persona en el mundo real. En este enfoque es crucial no obligar al L
¿Qué se sabe sobre El efecto práctico del enfoque?
Si los reflejos se sacan del pesado circuito del LLM, no solo cambia la latencia, sino también la sensación de que el sistema está «vivo». El usuario deja de esperar a que la inteligencia complete todo el recorrido de la cadena y empieza a ver un comportamiento continuo. Para los equipos de producto, se trata de un cambio importante: la calidad de un agente ya no se mide por lo vistoso de un fotograma de demo, sino por la naturalidad con la que mantiene el ritmo de la interacción. En un producto interactivo, esto suele importar más que un texto perfecto, porque la sensación
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.