MiniMax sustituye a la API de Claude y reduce el gasto de un agente de IA de 200 a 20 dólares
El desarrollador de un agente de IA para redes sociales explicó cómo redujo el gasto en modelos de más de $200 a ~$20 al mes, no con ingeniería de prompts, sino cambiando de modelo. Tras pasar de la API de Claude a MiniMax M2.5, con Kimi K2.5 como respaldo, la mayor parte de la carga se cubre ahora con una suscripción. El texto incluye además tres reglas sencillas de enrutamiento para quienes pagan por token.
Procesado por IA desde Habr AI; editado por Hamidun News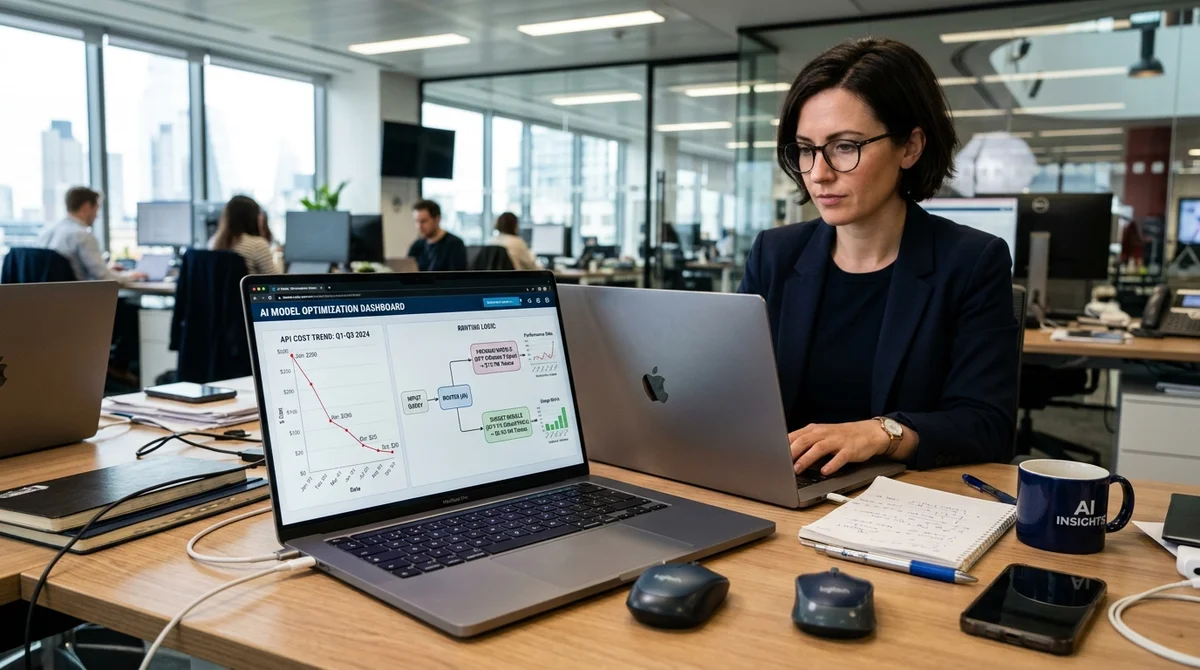
El desarrollador de un agente de IA para redes sociales demostró que la forma más eficaz de recortar el gasto en modelos no es exprimir hasta el último céntimo de los prompts, sino replantearse la elección del propio modelo. En su caso, el cambio de la API de Claude a alternativas más baratas redujo la factura de modelos de más de $200 a unos $20 al mes, sin pérdida de calidad apreciable.
De la suscripción a la API
El agente funcionaba originalmente con una suscripción a Claude Max. Al autor le parecía un escenario casi gratuito: ya pagaba unos $100 al mes por acceder a Claude para el desarrollo diario, y la carga adicional del agente no exigía un presupuesto aparte. El sistema se ocupaba de la rutina típica de contenidos: leía feeds, reunía temas, investigaba, escribía borradores, los editaba y preparaba publicaciones para redes sociales.
La situación cambió tras la actualización de las normas de Anthropic. Dejó de estar permitido usar la suscripción para agentes de IA y sistemas automatizados, así que el proyecto tuvo que pasar al pago por tokens de la API. En teoría las tarifas parecían razonables, pero en la práctica el modelo resultó demasiado voraz para este caso. Una sola sesión de investigación matinal podía quemar hasta 250 mil tokens antes de que apareciera un texto terminado, y las llamadas fallidas y las peticiones repetidas inflaban rápido la factura. El primer mes completo con la API costó más de $200.
El problema principal no era solo la cifra, sino su imprevisibilidad: los días normales el gasto era moderado, pero cualquier caso límite con una larga cadena de razonamiento lo multiplicaba. Para un desarrollador en solitario y un proyecto paralelo, ya no es un «precio por la comodidad», sino una partida de gasto que hay que controlar tan estrictamente como los servidores o las API externas.
En busca de un modelo barato
Después llegó la prueba de alternativas. Los criterios eran prácticos: el modelo debía escribir textos largos, seguir bien instrucciones complejas, mantener un tono estable y costar bastante menos que Claude.
La primera opción viable fue Kimi K2.5 a través de OpenRouter, a unos $0.45 por millón de tokens. Según el autor, ofrecía aproximadamente el 80% de la calidad de Claude por una pequeña fracción del coste y cumplía bien con borradores de publicaciones, resúmenes de investigación y esquemas de artículos. El cambio a Kimi ya ayudó de forma notable: el gasto mensual bajó al rango de $40–60. Pero el problema de la imprevisibilidad no desapareció, porque el pago seguía siendo por tokens.
El punto de inflexión llegó con el paso a MiniMax M2.5, ofrecido por suscripción a unos $20 al mes. Para un agente de contenidos esto resultó más importante que perseguir la máxima calidad en benchmarks: un pago fijo simplificó la planificación del presupuesto y eliminó el miedo a los picos de carga.
En la configuración actual el autor usa MiniMax como modelo principal y deja Kimi como alternativa. Según él, el respaldo casi no hace falta, porque MiniMax cubre más del 95% de las peticiones. La economía global es esta:
- suscripción a MiniMax M2.5: unos $20 al mes
- Kimi K2.5 como reserva: unos $1–2
- TwitterAPI.io para recopilar el feed: $5
- VPS en Contabo: $6.36
El coste total del agente en producción ronda los $33 al mes con la infraestructura incluida, mientras que solo el modelo en la API de Claude consumía antes entre $200 y $400+.
Reglas sencillas de enrutamiento
El autor subraya que la suscripción no sirve para todos. Si la carga supera los límites, se necesitan capacidades únicas de un modelo concreto o la empresa ya está muy metida en su propia infraestructura en la nube, habrá que aceptar el pago por token. En ese caso, la principal palanca de ahorro es el enrutamiento de modelos. La idea es simple: no enviar cada petición al motor más caro, sino elegir el modelo según la complejidad de la tarea.
El artículo enumera varios enfoques. El enrutamiento en cascada prueba primero el modelo más barato y escala la petición solo si el resultado es débil. FrugalGPT, que cita el autor, mostró un ahorro de hasta el 98% manteniendo una precisión de nivel GPT-4, aunque el precio es una latencia adicional. RouteLLM, de LMSYS, demostró una reducción de costes de hasta el 85% en MT Bench conservando el 95% del rendimiento de GPT-4. Y AWS Bedrock ofrece Intelligent Prompt Routing como servicio gestionado y habla de un ahorro medio del 30%, y de hasta el 63% en cargas RAG.
Para equipos pequeños y desarrolladores en solitario, el autor aconseja una opción aún más terrenal, reglas de tres líneas:
- enviar al modelo más barato las peticiones cortas, de hasta 500 tokens, de formateo o extracción de datos
- enviar al modelo insignia las tareas de código, análisis complejo y razonamiento profundo
- dirigir todo lo intermedio a un modelo de gama media
«¿De verdad necesitas un modelo caro?» es la pregunta clave que el
autor propone hacerse antes de configurar un enrutamiento complejo.
Qué significa
La historia muestra la rapidez con que cambia la economía de los modelos de IA. En muchos casos un equipo paga de más no por malos prompts, sino porque elige por defecto un modelo de frontera para todas las tareas. La conclusión práctica es sencilla: primero pasa tu carga real por modelos baratos o de suscripción, y reserva los caros para donde la calidad realmente cae sin ellos.
- 2 nov 2026El creador de Bun migra 750 mil líneas de Zig a Rust en 11 días con Claude Code
- 2 nov 2026mcp-linter detecta 18 parámetros sin descripción en el servidor filesystem de Anthropic
- 2 nov 2026Un periodista de The Verge construye con Claude Code un equivalente del Meta Muse Charm por 50 dólares
- 2 nov 2026Reúnen 8 Skills de vídeo para Claude Code: de 244 efectos de píxeles al montaje
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre De la suscripción a la API?
El agente funcionaba originalmente con una suscripción a Claude Max. Al autor le parecía un escenario casi gratuito: ya pagaba unos $100 al mes por acceder a Claude para el desarrollo diario, y la carga adicional del agente no exigía un presupuesto aparte. El sistema se ocupaba de la rutina típica de contenidos: leía feeds, reunía temas, investigaba, escribía borradores, los editaba y preparaba publicaciones para redes sociales. La situación cambió tras la actualización de las normas de Anthropic. Dejó de estar permitido usar la suscripción para agentes de IA y sistemas aut
¿Qué se sabe sobre En busca de un modelo barato?
Después llegó la prueba de alternativas. Los criterios eran prácticos: el modelo debía escribir textos largos, seguir bien instrucciones complejas, mantener un tono estable y costar bastante menos que Claude. La primera opción viable fue Kimi K2.5 a través de OpenRouter, a unos $0.45 por millón de tokens. Según el autor, ofrecía aproximadamente el 80% de la calidad de Claude por una pequeña fracción del coste y cumplía bien con borradores de publicaciones, resúmenes de investigación y esquemas de artículos. El cambio a Kimi ya ayudó de forma notable: el gasto mensual bajó a
¿Qué se sabe sobre Reglas sencillas de enrutamiento?
El autor subraya que la suscripción no sirve para todos. Si la carga supera los límites, se necesitan capacidades únicas de un modelo concreto o la empresa ya está muy metida en su propia infraestructura en la nube, habrá que aceptar el pago por token. En ese caso, la principal palanca de ahorro es el enrutamiento de modelos. La idea es simple: no enviar cada petición al motor más caro, sino elegir el modelo según la complejidad de la tarea. El artículo enumera varios enfoques. El enrutamiento en cascada prueba primero el modelo más barato y escala la petición solo si el re
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.