Qdrant y DRAG with KNEE: cómo hacer un RAG adaptativo sin malgastar tokens
Un nuevo análisis aborda el gran desequilibrio del RAG clásico: o el modelo recibe muy poco contexto, o recibe un muro de texto que no necesita. El enfoque DRAG with KNEE, basado en Qdrant y Python, organiza los documentos en una jerarquía, busca un punto de inflexión en la relevancia y corta la cola de fragmentos irrelevantes. La idea es dar al modelo exactamente el contexto que requiere cada consulta.
Procesado por IA desde Habr AI; editado por Hamidun News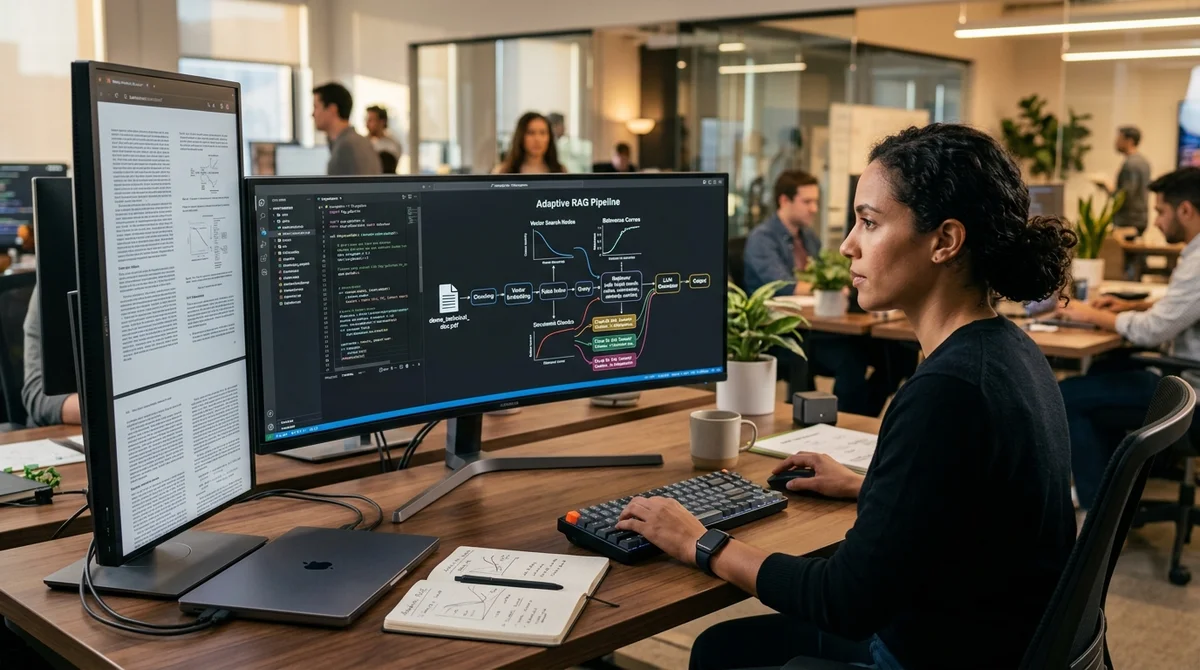
Se ha publicado un análisis práctico sobre cómo hacer que un sistema RAG gaste menos y sea más preciso. Se centra en DRAG with KNEE, un enfoque basado en Qdrant y Python que ajusta el volumen de contexto de forma dinámica en lugar de usar un top_k fijo.
Por qué falla un top_k estático
Casi cualquiera que haya montado un RAG sobre PDF largos se ha topado con el mismo problema. Si se recuperan muy pocos fragmentos, el modelo no ve contexto importante y empieza a inventar. Si se recuperan demasiados, el prompt se llena de ruido, y con él aumentan el coste, la latencia y el riesgo de que el LLM se aferre a un fragmento aleatorio. En este esquema, un único parámetro top_k intenta resolver tareas muy distintas y casi siempre lo hace mal.
El autor llama a este compromiso una debilidad fundamental del RAG clásico. Un número fijo de documentos no tiene en cuenta el tipo de consulta, la estructura del archivo de origen ni la densidad de información útil en el corpus. Para un dato breve pueden bastar un par de pasajes, pero no para una pregunta compleja sobre un documento de varias páginas. El resultado: el sistema o deja al modelo con poco contexto o lo satura de texto irrelevante y quema el presupuesto de tokens.
Cómo funciona DRAG
La idea de DRAG with KNEE no es solo buscar fragmentos similares, sino mirar primero los documentos como una jerarquía y decidir después, de forma dinámica, dónde detener la selección. En lugar de un límite rígido, el algoritmo analiza la distribución de la relevancia y busca un punto de inflexión, la "rodilla" a partir de la cual cada fragmento añadido aporta cada vez menos. Todo lo que queda en la larga cola tras ese punto puede descartarse sin una pérdida apreciable de sentido.
En la práctica, es una estrategia de extracción de contexto más adaptativa. El sistema no tiene que devolver el mismo número de fragmentos para cada consulta: a veces serán tres, otras diez y otras varios grupos relacionados de distintas partes del documento. Así, el RAG se ajusta a la estructura real del conocimiento y no a una constante elegida de antemano.
- Primero se obtienen candidatos por similitud vectorial
- Después se agrupan y ordenan por documentos y niveles
- A continuación, el algoritmo busca el punto en que la utilidad empieza a caer bruscamente
- Solo el núcleo relevante, sin la larga cola de ruido, llega al contexto final
Este enfoque resulta especialmente útil cuando el conocimiento no está en una base de FAQ ordenada, sino en instrucciones dispersas, informes, reglamentos y PDF grandes. En esos corpus, las distancias entre fragmentos dicen poco por sí solas si no se considera cómo se relacionan entre sí y con qué rapidez cae su valor para la respuesta. Ahí el análisis geométrico deja de ser un adorno matemático y se convierte en un filtro práctico.
Para qué sirve Qdrant
Un punto a favor del artículo es que no se pierde en la teoría pura. El autor muestra cómo montar este pipeline con Qdrant y Python, un stack conocido que ya se usa en muchos proyectos RAG. Qdrant se encarga de la búsqueda vectorial y del trabajo con los candidatos, y la lógica de DRAG with KNEE añade encima una capa de adaptación: no solo encontrar lo similar, sino determinar cuánto de ello necesita realmente el modelo en ese momento.
Para los equipos que ya han implantado un retrieval convencional y se han topado con un límite en la calidad de las respuestas o en el coste de inferencia, es una señal importante. El problema puede no estar en los embeddings ni en el propio LLM, sino en cómo se corta y se entrega el contexto. Sustituir el top_k estático por un corte dinámico en el punto de inflexión puede reducir el ruido y mejorar la precisión a la vez, sin rehacer toda la arquitectura.
Qué significa
El RAG se aleja poco a poco de los ajustes toscos de un solo parámetro para todos los casos. El material sobre DRAG with KNEE muestra un cambio sencillo pero importante: el siguiente nivel de calidad no depende solo de una buena búsqueda, sino de saber parar a tiempo para que el LLM reciba contexto suficiente para responder y no un exceso aleatorio de texto.
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Por qué falla un top_k estático?
Casi cualquiera que haya montado un RAG sobre PDF largos se ha topado con el mismo problema. Si se recuperan muy pocos fragmentos, el modelo no ve contexto importante y empieza a inventar. Si se recuperan demasiados, el prompt se llena de ruido, y con él aumentan el coste, la latencia y el riesgo de que el LLM se aferre a un fragmento aleatorio. En este esquema, un único parámetro top_k intenta resolver tareas muy distintas y casi siempre lo hace mal. El autor llama a este compromiso una debilidad fundamental del RAG clásico. Un número fijo de documentos no tiene en cuenta
Cómo funciona DRAG?
La idea de DRAG with KNEE no es solo buscar fragmentos similares, sino mirar primero los documentos como una jerarquía y decidir después, de forma dinámica, dónde detener la selección. En lugar de un límite rígido, el algoritmo analiza la distribución de la relevancia y busca un punto de inflexión, la "rodilla" a partir de la cual cada fragmento añadido aporta cada vez menos. Todo lo que queda en la larga cola tras ese punto puede descartarse sin una pérdida apreciable de sentido. En la práctica, es una estrategia de extracción de contexto más adaptativa. El sistema no tien
¿Qué se sabe sobre Para qué sirve Qdrant?
Un punto a favor del artículo es que no se pierde en la teoría pura. El autor muestra cómo montar este pipeline con Qdrant y Python, un stack conocido que ya se usa en muchos proyectos RAG. Qdrant se encarga de la búsqueda vectorial y del trabajo con los candidatos, y la lógica de DRAG with KNEE añade encima una capa de adaptación: no solo encontrar lo similar, sino determinar cuánto de ello necesita realmente el modelo en ese momento. Para los equipos que ya han implantado un retrieval convencional y se han topado con un límite en la calidad de las respuestas o en el coste
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.