MTS تطلق «ميثان»: ذكاء اصطناعي للبحث عن البيانات في كتالوج يضم 500 ألف جدول
أنشأت MTS مساعد الذكاء الاصطناعي «ميثان» للبحث السريع عن البيانات. يضم الكتالوج المؤسسي في MTS أكثر من 500 ألف جدول مسجّل، وكان المحللون يضيّعون سابقًا ساعات في العثور على البيانات المطلوبة، إذ كان عليهم استشارة الزملاء ودراسة الوثائق. يجمع النظام الجديد بين مبادئ حوكمة البيانات (data governance) ونماذج LLM الحديثة، فينشئ طبقة دلالية فوق البيانات الوصفية الخام ويجيب مباشرة عن الأسئلة التجارية للمحللين.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News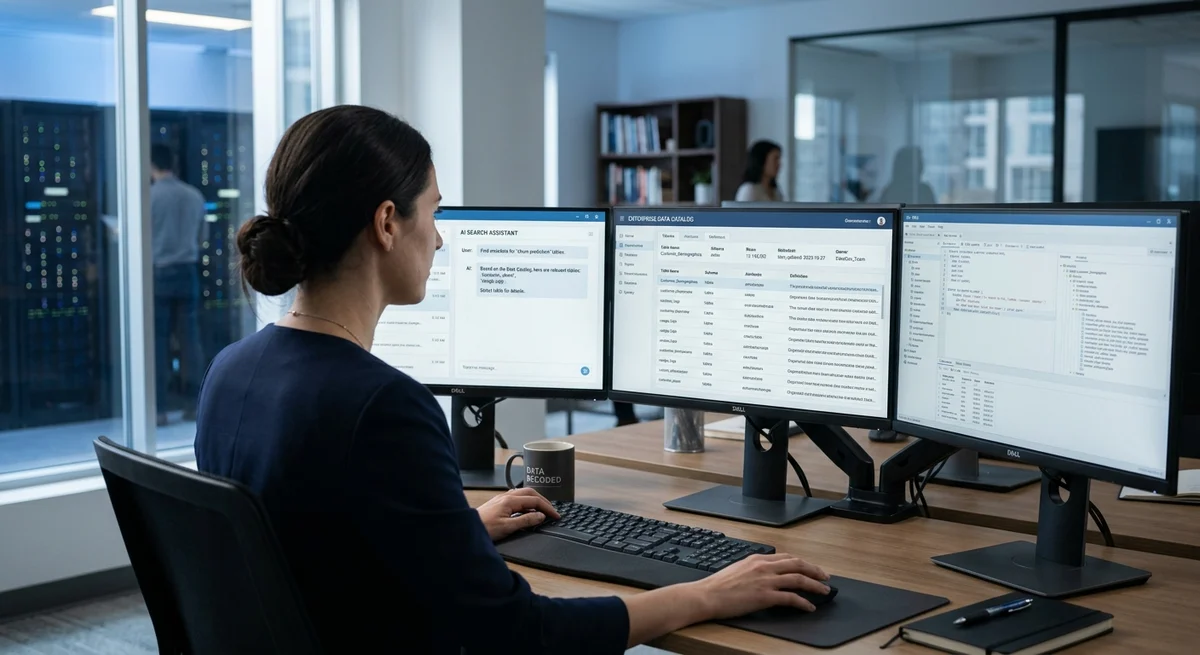
أنشأت MTS نظام «ميثان»، وهو مساعد ذكي يساعد المحللين على العثور على البيانات المطلوبة في كتالوج مؤسسي يضم 500 ألف جدول، بمجرد طرح سؤال باللغة الروسية.
كتالوج لا يجيب عن الأسئلة
تراكمت لدى MTS كميات هائلة من البيانات. فكتالوج البيانات في الشركة يحتوي على أكثر من 500 ألف جدول مسجّل. ويعمل مع هذه البيانات كل يوم مئات المتخصصين: محللون ومهندسو بيانات ومتخصصون في التعلم الآلي يبنون واجهات البيانات (витрины) لنماذج ML.
لكن المشكلة هي أن الكتالوج لا يعمل جيدًا إلا إذا كنت تعرف مسبقًا ما تبحث عنه. هل تحتاج إلى جدول يحتوي معلومات عن العملاء؟ تُدخل الاستعلام، فيعرض لك الكتالوج وصف الحقول والمالك والمخطط. أما إذا واجهت سؤالًا تجاريًا من قبيل «أي الجداول تحتوي معلومات عن العملاء في منطقة موسكو خلال الربع الأخير؟»، فلن يساعدك الكتالوج. عندها يضطر المحلل إلى التدبّر بنفسه: يقرأ الوثائق، ويستشير زملاء من فرق مختلفة، ويدرس الروابط بين المصادر. وقد يستغرق ذلك ساعات أو حتى أيامًا.
لماذا لا تستطيع الشبكة العصبية الحل وحدها
قد يبدو منطقيًا أن الشبكة العصبية قادرة على حل هذه المهمة، فيكفي أن تسألها أين توجد البيانات. لكن هناك مشكلة جوهرية: الذكاء الاصطناعي يعتمد فقط على المعلومات التي تُقدَّم إليه. فإذا خلت البيانات الوصفية من معلومات صريحة عن الروابط بين الجداول، أو عن كيفية ارتباط بيانات مصدر ما بمصدر آخر، أو عن المعنى الفعلي لكل مصطلح في سياق الشركة، فإن حتى أكثر النماذج تطورًا سيتعثر.
غير أن MTS شهدت تزامنًا نادرًا بين عاملين. فخلال أكثر من 15 عامًا من العمل المنهجي على حوكمة البيانات، راكمت الشركة خبرة جدية في الوصف الصحيح للبيانات الوصفية، وفي هيكلة الروابط، وفي توثيق العمليات التجارية داخل البيانات. وفي الوقت نفسه ظهرت نماذج LLM قادرة على التعامل مع مثل هذه الطبقات الدلالية المنظّمة.
نظام «ميثان»: الجمع بين حوكمة البيانات والذكاء الاصطناعي
«ميثان» اسم مختصر يجمع كلمتي «البيانات الوصفية» و«التحليلات». وهو نظام تجريبي تختبره MTS حاليًا. يعمل النظام كواجهة ذكية للبيانات المؤسسية: تطرح سؤالك بلغة بشرية، فيفهم النظام أي الجداول والمصادر تحتاج إليها ويقدّم لك الإجابة.
ويعمل ذلك لأن البيانات الوصفية في MTS ليست مجرد مجموعة أوصاف، بل هي رسم معرفي متكامل (graph):
- جداول مرتبطة بأوصافها وببنية حقولها
- قاموس للمصطلحات التجارية الخاصة بالشركة
- روابط بين الجداول ومصادر البيانات
- معلومات عن المسؤولين والمالكين
- تاريخ التبعيات والروابط بين واجهات البيانات
وتُضاف إلى هذا الرسم طبقة دلالية مفهومة لنماذج LLM. فيستطيع النموذج أن «يرى» لا الكلمات والأوصاف فحسب، بل المعاني والعلاقات بينها.
ماذا يعني ذلك للأعمال
«ميثان» ليس المحاولة الأولى لأتمتة البحث عن البيانات في الشركات الكبرى. لكنه من أوائل الأنظمة التي تعمل فعلًا، لأنه لم يُبنَ على الذكاء الاصطناعي وحده، بل على الجمع بين عمل مكلف في حوكمة البيانات وقدرات LLM الحديثة.
وبالنسبة إلى شركات مثل MTS، يعني ذلك تسريع عمل المحللين: وقتًا أقل في البحث عن المصادر والتنسيق مع الزملاء، ووقتًا أكثر للتحليل الفعلي. أما بالنسبة إلى القطاع بأكمله، فهذه إشارة إلى أن الوكلاء (agents) يعملون بصورة أفضل لا مع بيانات فوضوية، بل مع بيانات منظّمة وموصوفة جيدًا. فالنظام والذكاء الاصطناعي ليسا عدوّين، بل شريكان.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.