تضمينات OpenAI والتعلّم المعزَّز: كيف تبني وكيلًا بذاكرة طويلة الأمد لإجابات دقيقة
استعرض الدليل كيفية بناء وكيل تعلّم معزَّز بذاكرة طويلة الأمد، يتعلّم أن يستخرج من قاعدة المعرفة السجلات التي تساعد نموذج LLM على الإجابة بدقة أكبر. يبدأ المخطط بمجموعة بيانات اصطناعية وبأسئلة تتطلب استرجاع حقائق محددة، ثم يستخدم تضمينات OpenAI لتحويل الذاكرة والأسئلة إلى متجهات، وتدريب سياسة تختار الذكريات ذات الصلة بصورة موجَّهة.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News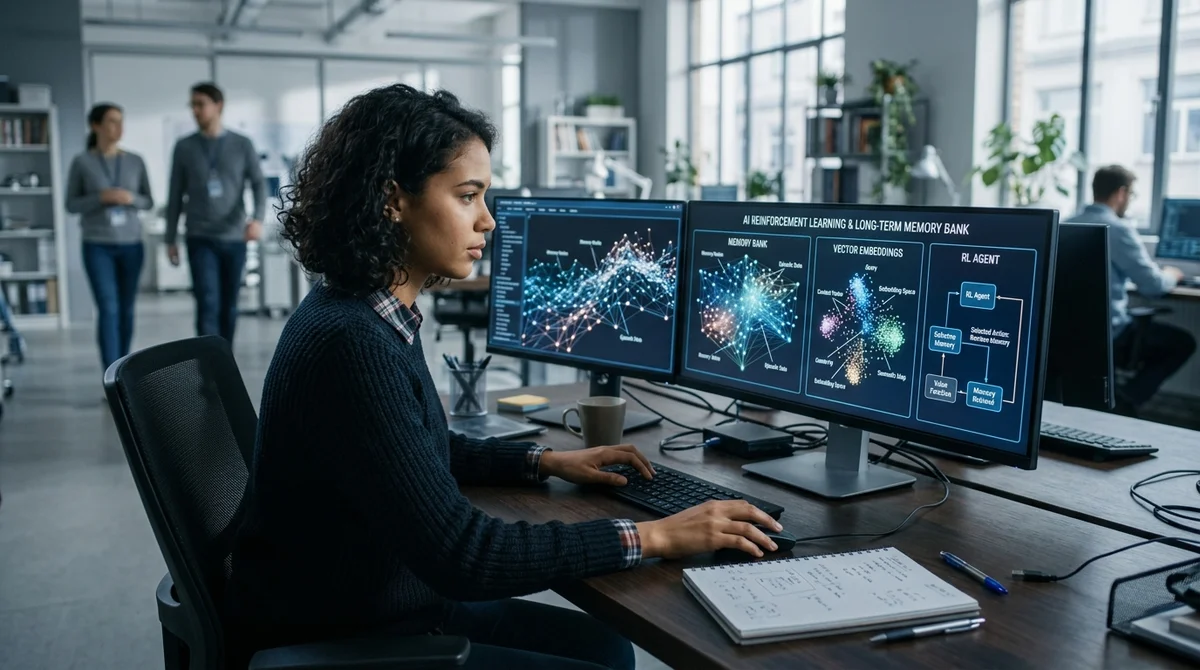
تتحول فكرة الذاكرة طويلة الأمد في الذكاء الاصطناعي إلى مهمة عملية: يعرض دليل تطبيقي جديد كيفية بناء وكيل قائم على التعلّم المعزَّز لا يكتفي بالبحث عن السجلات المتشابهة، بل يتعلّم أن يستخرج من الذاكرة الحقائق التي يحتاجها نموذج LLM تحديدًا لإجابة دقيقة. وتبرز أهمية هذا النهج في الأنظمة التي تفوق معارفها سعة نافذة سياق واحدة، إذ يؤثر أي خطأ في اختيار الذكرى المناسبة مباشرة في جودة الإجابة.
يبدأ المؤلفون بمجموعة ذاكرة اصطناعية: ينشئون مجموعة من السجلات، ثم يصوغون أسئلة تتطلب تذكّر تفاصيل محددة. وهذه صيغة مريحة للمهمة، لأنها تتيح التحكم في السجل الذي يُعدّ ذا صلة فعلًا، وتقييم مرحلة استرجاع الذاكرة نفسها، لا الإجابة النهائية للنموذج فحسب. وبدلًا من اختيار القواعد يدويًا، يُستخدم وكيل قابل للتدريب يتلقى تدريجيًا إشارة عن الإجراءات التي تقوده إلى الحقيقة الصحيحة. كما يقلّل ذلك من خطر الإفراط في الملاءمة مع سيناريو بحث واحد بعينه، ويسهّل التحقق الآلي من التجارب.
بعد ذلك تُحوَّل الذاكرة والأسئلة إلى فضاء متجهي بواسطة تضمينات OpenAI. وبفضل ذلك يحصل النظام على إشارة تشابه أساسية: أي السجلات تبدو قريبة من السؤال من حيث المعنى. لكن هذه الأنظمة كثيرًا ما تتعثر إذا اعتمدت على التقارب المتجهي وحده. فقد يكون السجل المشابه عامًّا أكثر من اللازم، أو يتطابق جزئيًا مع الموضوع، أو يتضمن حقيقة مجاورة لا الحقيقة المطلوبة. وهنا يصبح التعلّم المعزَّز طبقة إضافية فوق البحث التقليدي: على الوكيل أن يتعلّم اختيار ما هو الأنفع للإجابة، لا ما هو الأكثر تشابهًا فقط.
عمليًا، يعني ذلك أن مرحلة البحث في الذاكرة تتحول من بحث ساكن عن أقرب الجيران إلى سلسلة من القرارات. يستطيع الوكيل ترتيب المرشحين، وتدقيق اختياره، ودمج الإشارات، وتلقّي مكافأة على استخراج المقاطع التي تجعل نموذج LLM يجيب بدقة أكبر. وهذا تحوّل مهم للمطورين: فالذاكرة لم تعد مخزنًا سلبيًا، بل جزءًا من حلقة قابلة للتحسين.
ويفيد هذا التصميم خصوصًا المساعدين الشخصيين، وقواعد المعرفة المؤسسية، والأنظمة الوكيلة ذات سجل المحادثات، وأي منتج ينبغي فيه للنموذج أن يتذكر حقائق قديمة دون تحميل الأرشيف كاملًا في الموجِّه (prompt) باستمرار. وتساعد هذه البنية تحديدًا على الفصل بين السياق قصير الأمد للطلب الحالي والذاكرة المتراكمة التي تنمو مع نمو المنتج.
وتبرز كذلك أهمية الطابع الاصطناعي لمجموعة البيانات وطريقة تقييم النتيجة. ففي المراحل الأولى تساعد مجموعة كهذه على تشغيل التدريب بسرعة ومعرفة ما إذا كانت آلية إشارة المكافأة تعمل، لكن لاحقًا سيتعيّن نقل المخطط إلى بيانات واقعية أكثر فوضوية: ملاحظات المستخدمين، وأحداث أنظمة CRM، ومقتطفات من المستندات، والمراسلات، ومحاضر الاجتماعات. ففي البيئة الواقعية لا تكون الصلة ثنائية تقريبًا أبدًا، وقد تتوزع الحقائق المهمة على عدة سجلات.
لذلك لا يكفي في هذه الأنظمة التحقق من أن النموذج وجد شيئًا مشابهًا؛ بل ينبغي قياس ما إذا كان الاسترجاع قد ساعد على تقديم الإجابة الصحيحة، وهل انخفض عدد حالات الهلوسة، ومدى ثبات سلوك الوكيل عبر أنواع مختلفة من الأسئلة. وفي هذا المعنى تكمن قيمة التعلّم المعزَّز في أنه يحسّن فائدة الذاكرة المستخرَجة للمهمة النهائية، لا مقياس تشابه مجرّدًا.
والخلاصة الرئيسية من هذه المادة أن الموجة المقبلة من تحسينات وكلاء LLM لن ترتبط بحجم النموذج وحده، بل بجودة إدارة الذاكرة أيضًا. فإذا استطاع الوكيل أن يتعلّم من إشارة الفائدة وأن يختار الذكرى المناسبة في اللحظة المناسبة، أمكن حتى دون توسيع نافذة السياق رفع دقة الإجابات بوضوح، وتقليل الضوضاء، وجعل سلوك النظام أكثر ثباتًا على المدى الطويل. وبالنسبة إلى الفرق التي تبني منتجات ذكاء اصطناعي فوق RAG والسيناريوهات الوكيلة، فهذا مؤشر جيد: فالأجدر تحسينه ليس التوليد فحسب، بل سياسة استرجاع المعرفة أيضًا.
- 28 أكتوبر 2026OpenAI تطلق GPT-6.1 Terra: بنصف السعر وبمستوى يقارب النماذج الأعلى فئة
- 28 أكتوبر 2026OpenAI تطلق GPT-6.1 Terra: سعر الرمز $1 وسرعة تفوق Astra بثلاثة أضعاف
- 28 أكتوبر 2026Anthropic تودع وثيقة S-1: إيرادات ربع سنوية بقيمة $11,6 مليار والتزامات بقيمة $780 مليار
- 28 أكتوبر 2026DeepSeek تفتح مصدر DeepInfer: 155 تريليون توكن يوميًا وهامش ربح 80%
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.