MarkTechPost
Fonte de notícias de IA. Os artigos são selecionados e adaptados pela redação do Hamidun News.
Últimas publicações
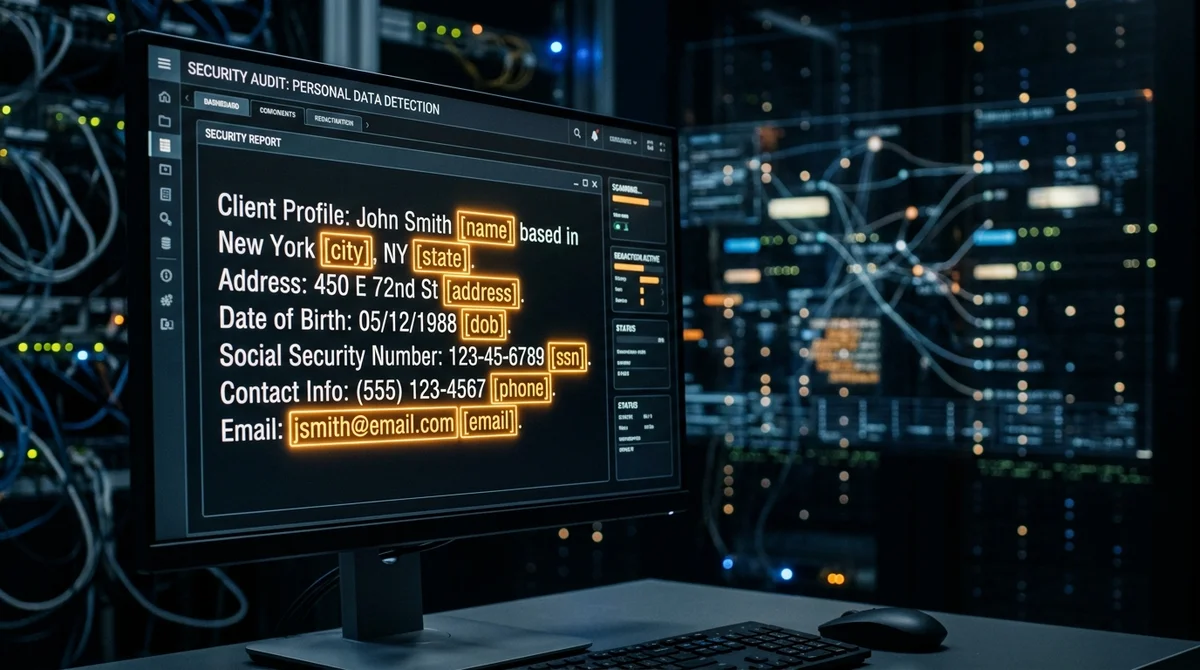
OpenAI Lançou Privacy Filter: Modelo Aberto para Remover Dados Pessoais
OpenAI publicou Privacy Filter — um modelo open-source para detecção e substituição automática de dados pessoais, funcionando diretamente no navegador sem infraestrutura de servidor.
OpenAI e Promptflow: Como Construir um Pipeline LLM com Rastreamento e Avaliação de Qualidade
O guia mostra como construir um pipeline LLM no Google Colab usando Promptflow, Prompty e OpenAI com configuração segura de chaves, rastreamento de execuções e avaliação de qualidade integrada.
Meta FAIR Lança NeuralSet — Pacote Python para Conectar Dados Neurais e Modelos de IA
Meta FAIR abriu NeuralSet — um framework Python que combina fMRI, M/EEG, spikes e embeddings do Hugging Face em um único pipeline PyTorch para pesquisa Neuro-AI.
A equipe Qwen lançou FlashQLA: acelerando atenção linear até 3× em NVIDIA Hopper
QwenLM lançou FlashQLA — uma biblioteca de kernels CUDA para Gated Delta Network que oferece ganho de desempenho de até 3× em GPU NVIDIA Hopper para pré-treinamento e inferência agentiva.
OpenAI Privacy Filter: Como Construir um Pipeline de Produção para Detecção e Mascaramento de PII
O guia do OpenAI Privacy Filter desglosa um pipeline completo para detectar e mascarar dados pessoais — desde o carregamento do modelo até a edição automática de texto.
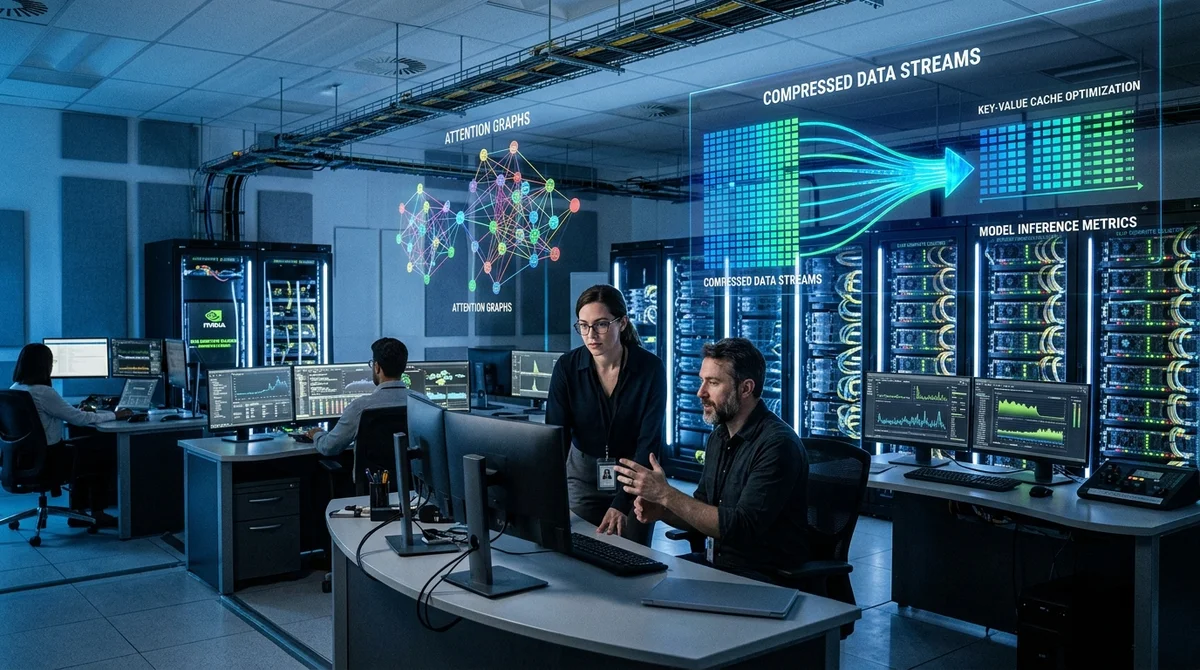
DeepSeek, Google e Meta: 10 técnicas de compressão de KV-cache em LLM para reduzir memória em inferência
KV-cache se tornou um consumidor de memória GPU em grandes LLMs, e uma nova revisão apresenta 10 abordagens — de H2O e SnapKV até TurboQuant e MLA do DeepSeek — que reduzem o consumo de memória sem reestruturação complet
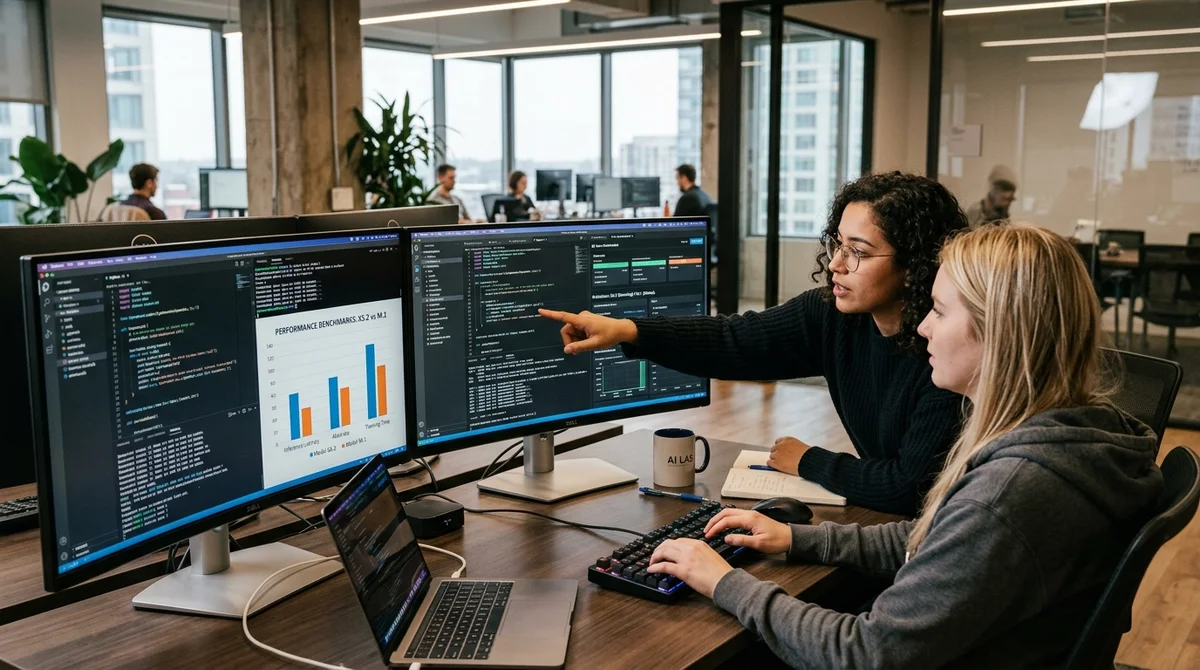
Poolside lançou Laguna XS.2 e M.1 — modelos abertos para programação com agentes
Poolside apresentou dois modelos Laguna para codificação com agentes: o XS.2 aberto é executado localmente, enquanto o mais poderoso M.1 é projetado para tarefas longas com edições de código, testes e trabalho em termina
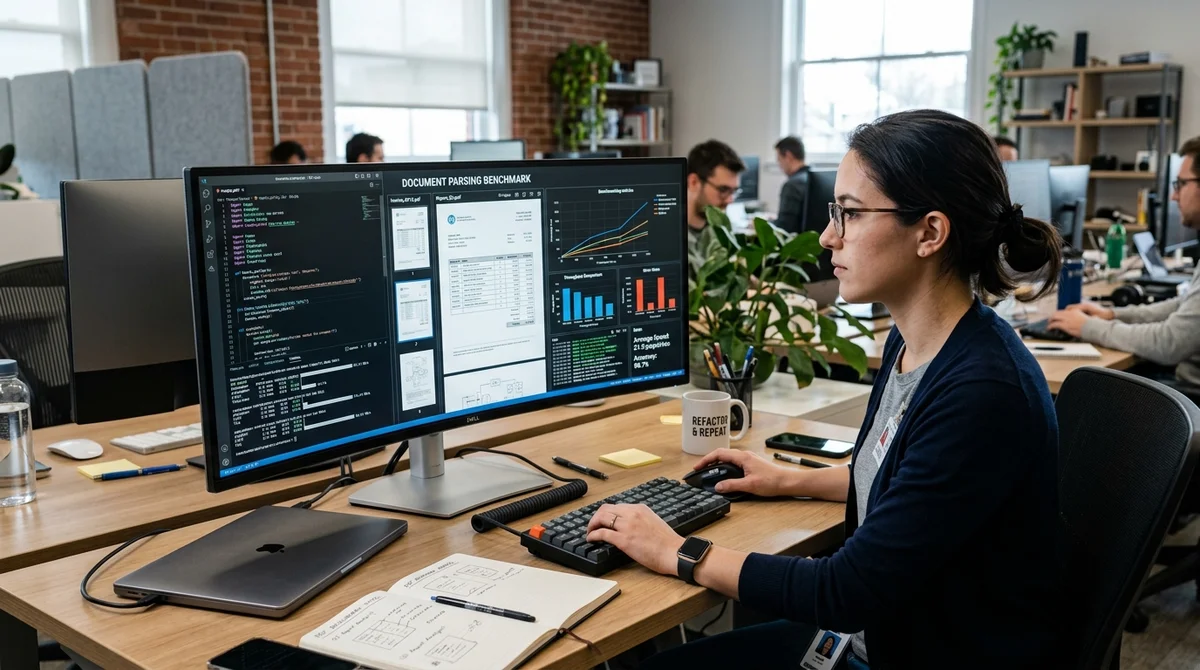
LlamaIndex ParseBench: como testar parsing de documentos via Python e Hugging Face
Um guia prático mostra como construir um pipeline de avaliação de analisadores de documentos usando o dataset LlamaIndex ParseBench: carregar PDFs do Hugging Face, comparar texto extraído e medir qualidade.
smol-audio da Deep-unlearning: Uma coleção de notebooks Colab para ajuste fino de modelos de áudio
Deep-unlearning lançou smol-audio — uma coleção de notebooks compatíveis com Colab para ajustar Whisper, Parakeet, Voxtral, Granite Speech e outros modelos de áudio.
Os 10 principais modelos de IA física que controlam robôs reais em 2026
Em 18 meses, a lacuna entre LLMs e a robótica real diminuiu drasticamente: modelos de IA física já funcionam em fábricas, armazéns e laboratórios de pesquisa.
Hugging Face e Gemma 3 1B: Construindo um Pipeline de Geração Pronto para Produção no Colab
Um breakdown de como executar Gemma 3 1B Instruct no Colab via Hugging Face Transformers: com autorização segura, chat templates e um pipeline de inferência reproduzível.
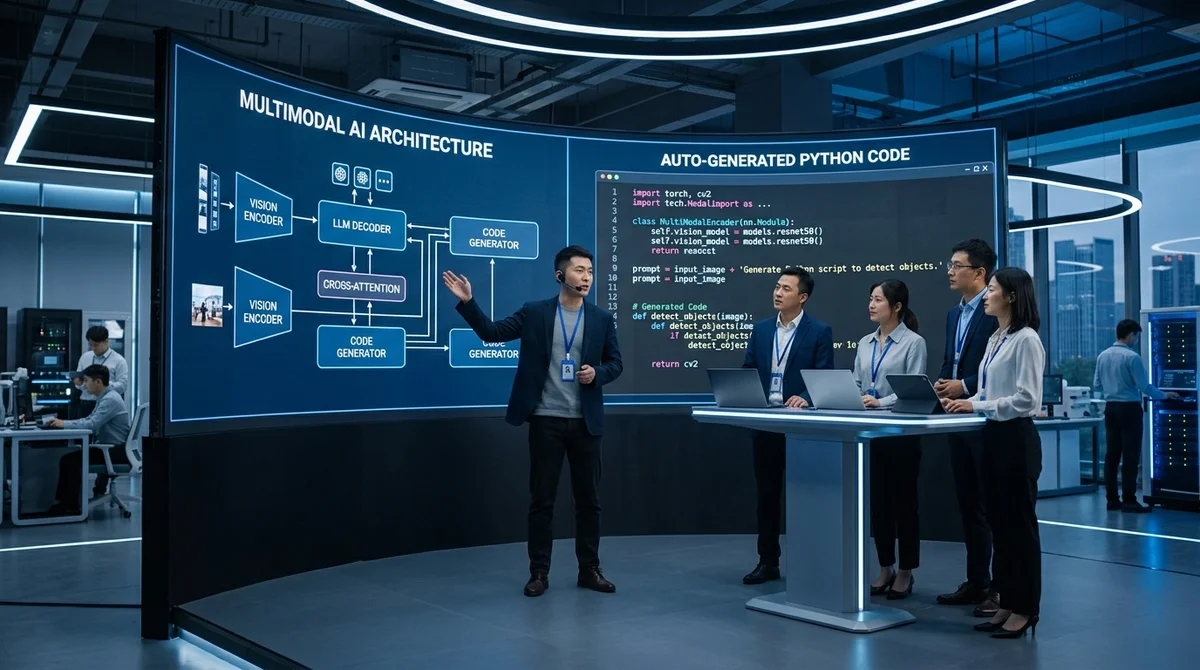
Z.ai lança GLM-5V-Turbo — modelo multimodal nativo para programação visual
O laboratório chinês Z.ai lançou GLM-5V-Turbo — um modelo que reconhece diagramas arquitetônicos e capturas de tela e gera imediatamente código funcional para sistemas de engenharia de agentes.
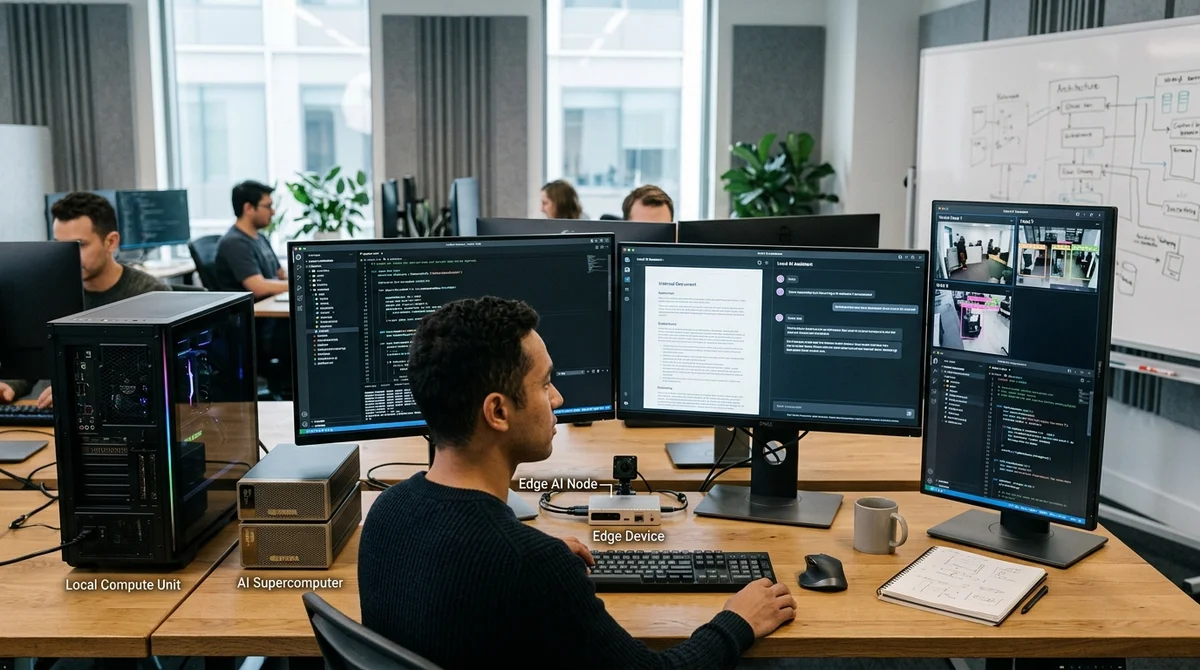
Google Gemma 4, NVIDIA e OpenClaw: Agentes AI locais sem cobrança por token
Google e NVIDIA estão promovendo a execução local do Gemma 4 em RTX, Jetson e DGX Spark para que agentes AI sempre ativos como OpenClaw funcionem mais rápido, mais barato e sem cobranças de tokens em nuvem.
Talkie-1930: Pesquisadores lançaram um modelo 13B sem conhecimento da internet e Segunda Guerra Mundial
Talkie-1930 é um modelo 13B aberto, treinado apenas em textos em inglês até 1931, para estudar pensamento histórico, vazamentos de dados e capacidade de generalização da IA além de sua época.
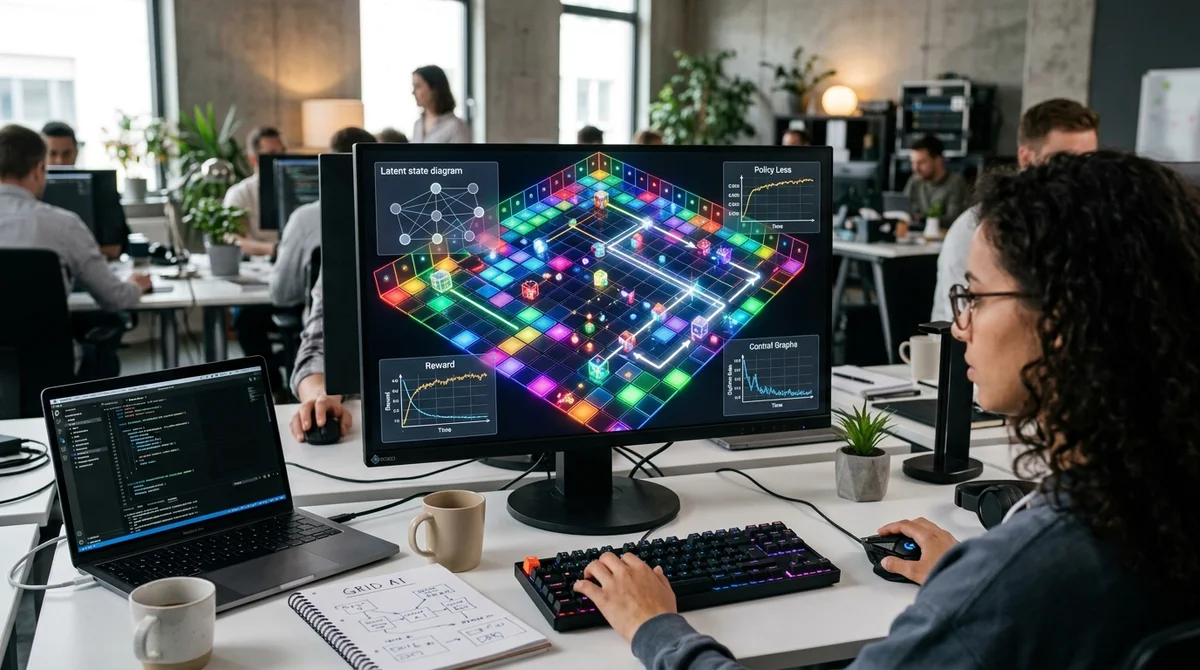
MarkTechPost mostra como construir um agente VLA leve com modelo de mundo latente e MPC
Em um novo tutorial, MarkTechPost detalha como construir um agente embodied simplificado: ele opera em frames RGB, aprende um modelo de mundo latente e planeja ações através de MPC.
Arcee AI Lança Trinity Large Thinking — Modelo de Raciocínio Aberto para Agentes IA
Arcee AI disponibilizou os pesos do Trinity Large Thinking sob licença Apache 2.0 e aposta em cenários de agentes longos, raciocínio multietapas e uso confiante de ferramentas.
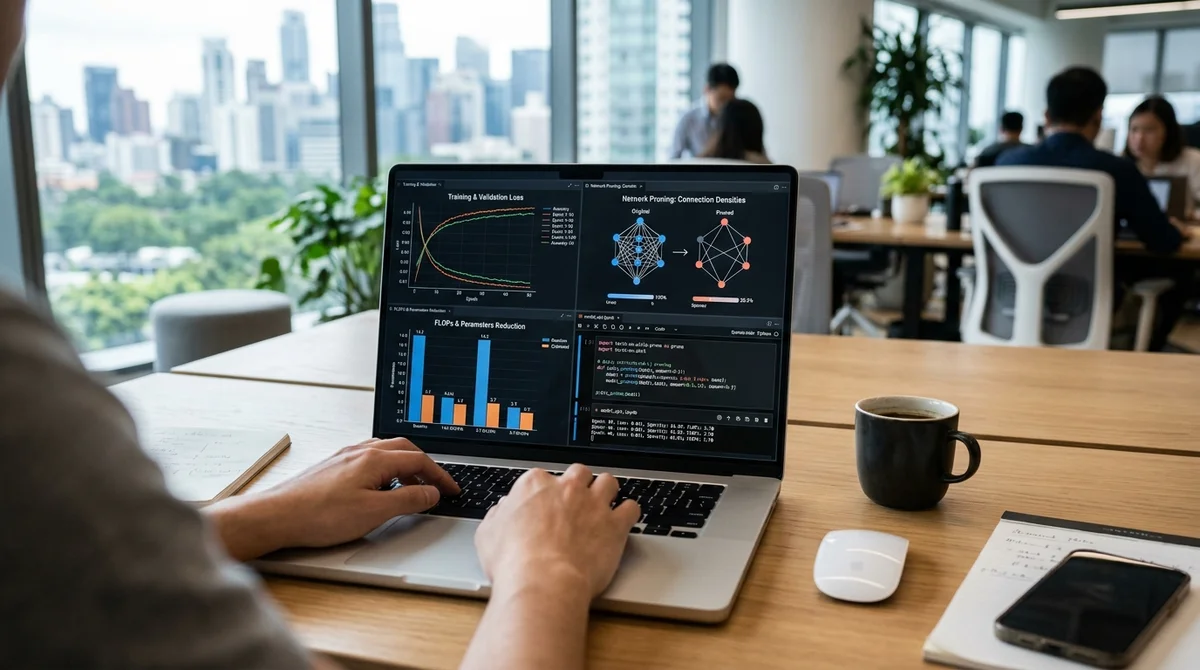
NVIDIA mostrou pipeline completo de otimização de modelo com FastNAS pruning e fine-tuning
NVIDIA lançou um guia prático para o Model Optimizer: em um único notebook Colab, demonstra-se treinamento de ResNet20, FastNAS pruning sob limite de FLOPs e recuperação de qualidade através de fine-tuning.
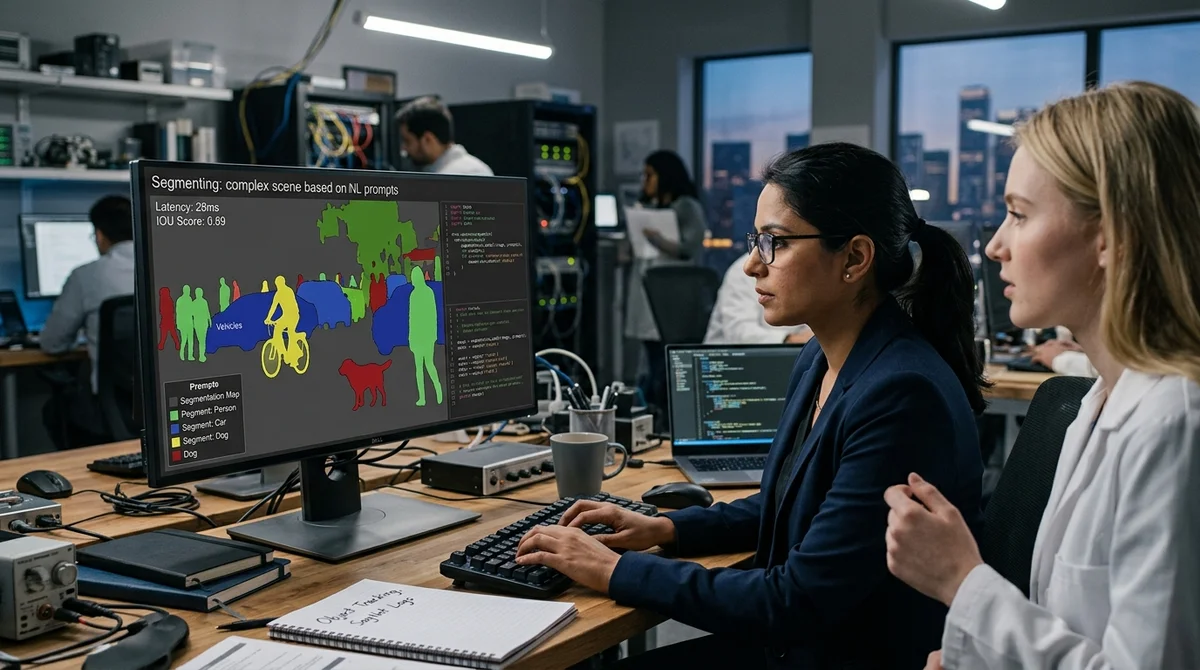
TII lança Falcon Perception — modelo 0,6B para segmentação e busca de objetos por texto
TII apresentou Falcon Perception — um modelo vision-language compacto com 0,6 bilhão de parâmetros que busca e segmenta objetos a partir de consultas em texto simples, superando SAM 3 em requisições complexas.
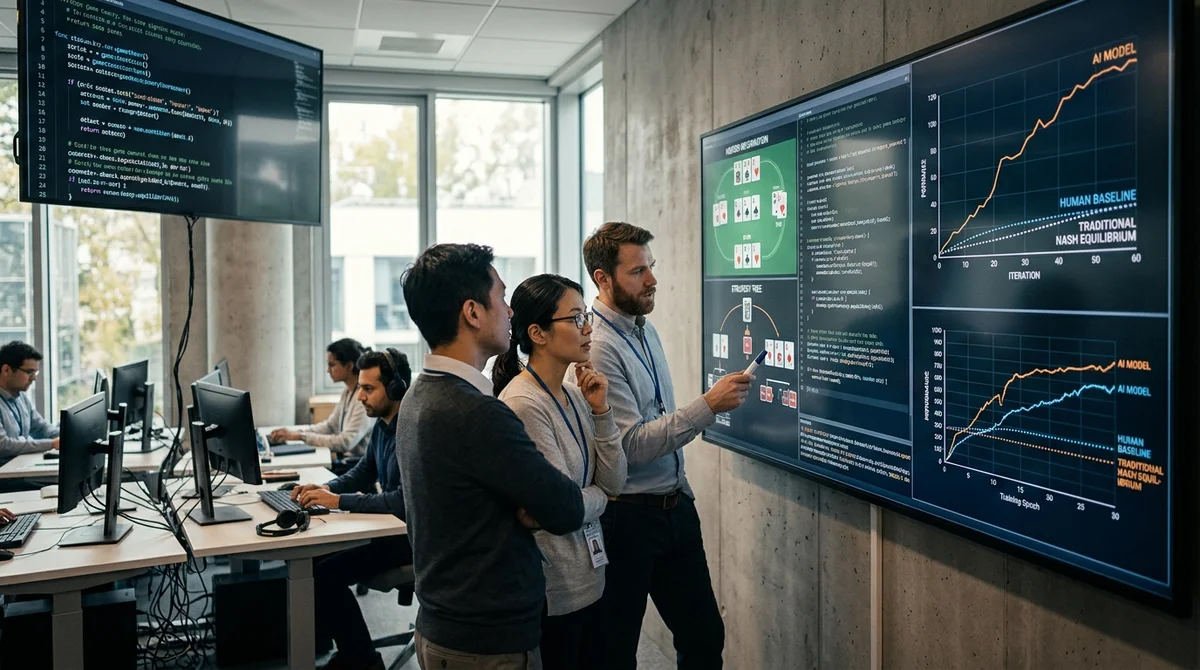
Google DeepMind Permite que LLM Reescreva Algoritmos da Teoria dos Jogos e Supere Especialistas
Google DeepMind demonstrou que AlphaEvolve pode reescrever código de algoritmos para jogos com informação incompleta e encontrar soluções que superam versões manuais de especialistas na maioria dos testes.
Z.AI mostrou como construir sistemas agentic production-ready no GLM-5 com tool calling
Z.AI lançou um tutorial detalhado sobre GLM-5: desde a configuração do SDK e API compatível com OpenAI até streaming, tool calling, saída JSON e agente multi-turn para produção.
Netflix Abre Void — Modelo para Remover Objetos de Vídeos com Consideração da Física da Cena
A equipe da Netflix e INSAIT lançou em open source o Void — um sistema que remove objetos de vídeos e recalcula simultaneamente quedas, sustentação de objetos e outras consequências físicas.
Como a Inteligência Artificial Ajuda Marcas de Moda a Projetar a Moda do Futuro
Algoritmos já ajudam marcas de moda a criar coleções mais rapidamente, prever tendências, reduzir superprodução e personalizar compras, mas também levantam questões sobre autoria e trabalho.
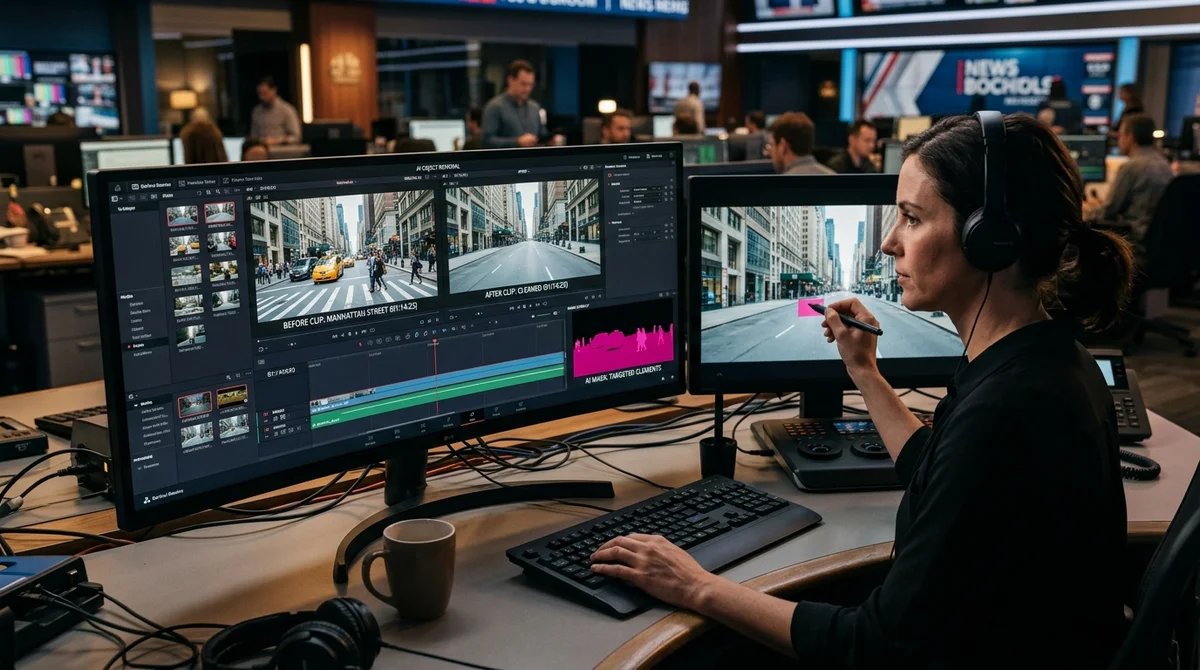
Como Construir um Pipeline Netflix Void para Remoção de Objetos em Vídeo usando CogVideoX
Um passo a passo detalhado mostra como implantar o modelo Netflix Void, baixar os checkpoints necessários, preparar dados de entrada e executar a remoção de objetos de vídeo através do CogVideoX.
Gladstone Institutes apresentam MaxToki — modelo de IA que prevê envelhecimento celular
O modelo MaxToki do Gladstone Institutes aprende a ver não um 'instantâneo' da célula, mas sua trajetória ao longo do tempo, avalia a aceleração do envelhecimento e identifica metas para intervenção.
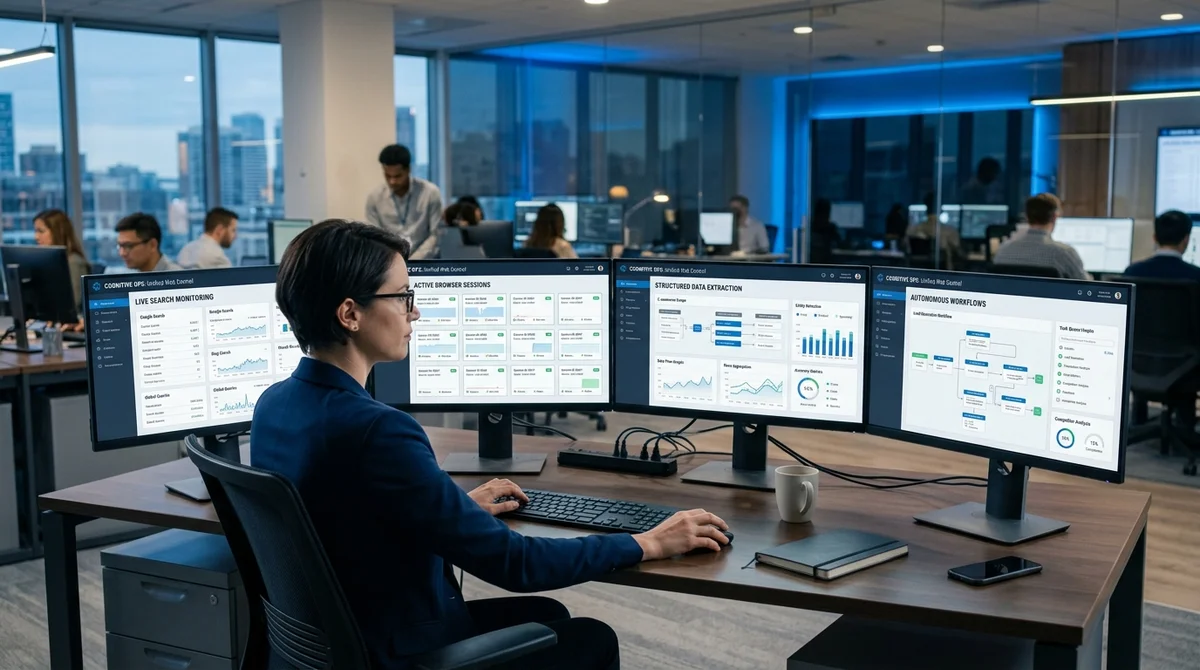
TinyFish Lança Plataforma Web Unificada para Agentes de IA com Search, Fetch, Browser e Agent
TinyFish combinou busca, renderização de páginas, sessões de navegador e fluxos de trabalho web autônomos em uma única plataforma para agentes de IA com uma chave API única e pool de créditos compartilhado.
Google adicionou Skills no Chrome e transformou prompts de IA em cenários de um clique
Google lançou a funcionalidade Skills no Chrome: usuários do Gemini poderão salvar prompts frequentemente usados como cenários reutilizáveis e executá-los no navegador com um único clique.
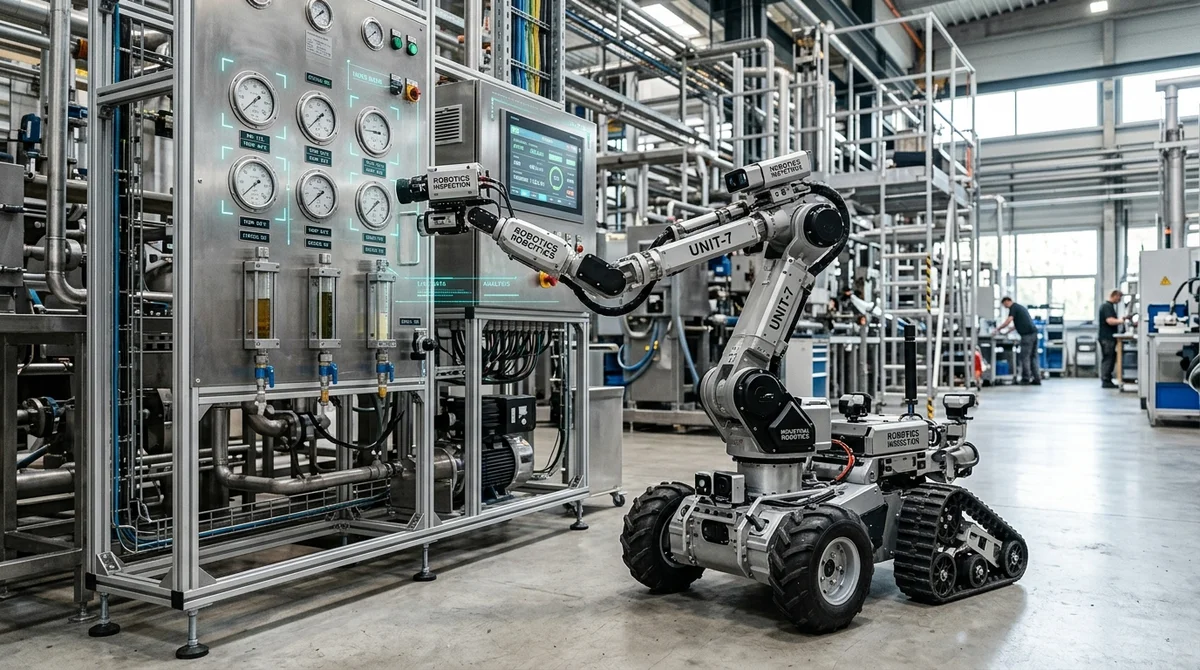
Google DeepMind Apresenta Gemini Robotics-ER 1.6 para Autonomia e Leitura de Instrumentos por Robôs
Google DeepMind atualizou Gemini Robotics-ER para a versão 1.6: um modelo para robôs que compreende melhor o espaço, múltiplos fluxos de vídeo e consegue ler instrumentos industriais complexos.
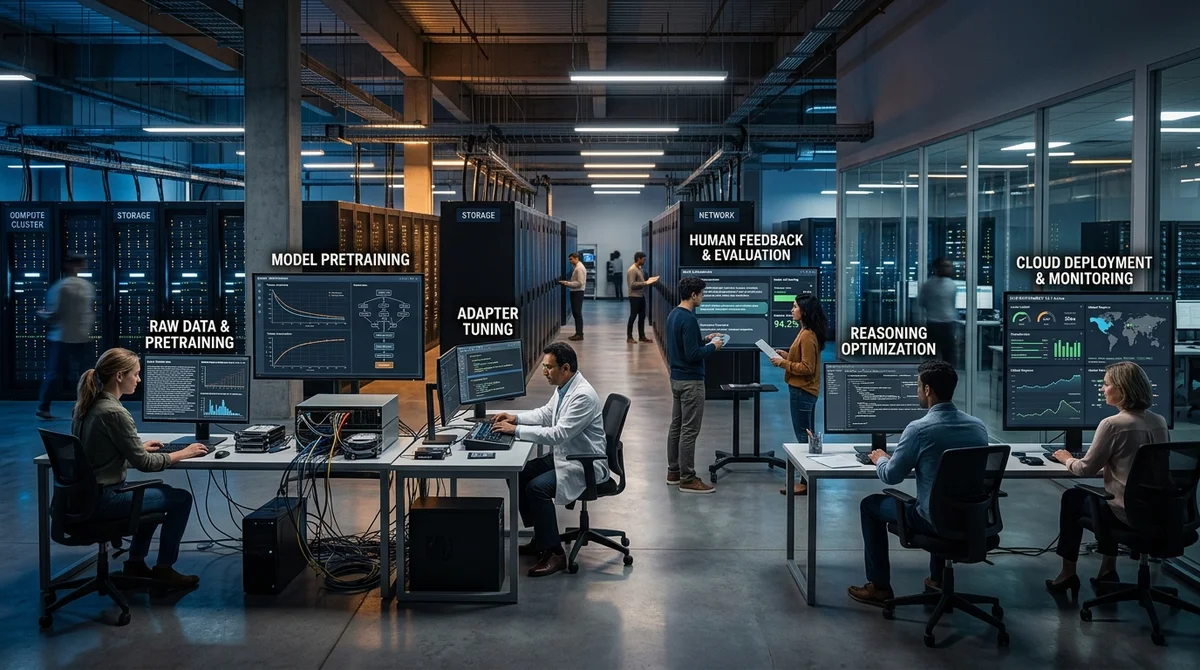
MarkTechPost desmembrou o ciclo completo de treinamento de grandes modelos de linguagem: dos dados ao deployment
MarkTechPost lançou uma análise detalhada de como os LLMs são construídos hoje: desde o pré-treinamento em grandes corpora até SFT, RLHF, otimização de raciocínio e deployment em produção.
Google apresentou Gemini 3.1 Flash TTS — modelo de fala com controle, diálogos e 70+ idiomas
Google lançou Gemini 3.1 Flash TTS em pré-visualização: o modelo sintetiza texto em 70+ idiomas, suporta diálogos com duas vozes e permite controlar a entrega através de tags de áudio.
Mem0 e OpenAI: como construir uma camada universal de memória de longo prazo para agentes de IA
Um novo tutorial decompõe a combinação de Mem0, modelos OpenAI e ChromaDB: ela extrai fatos de conversas comuns, armazena-os por user_id, busca por significado semântico e injeta-os nas respostas do agente.