Baidu lança o Qianfan-OCR, modelo de 4B para reconhecer e entender documentos
A Baidu apresentou o Qianfan-OCR, um modelo de 4B que reúne OCR, análise de layout e compreensão de documentos em uma só arquitetura. Em vez de um pipeline com várias etapas, o sistema converte a imagem direto em Markdown e aceita tarefas por prompt, como extração de tabelas, respostas a perguntas sobre o documento e automação de processos internos. É mais um passo rumo a serviços de IA documental inteligentes para empresas.
Processado por IA de MarkTechPost; editado por Hamidun News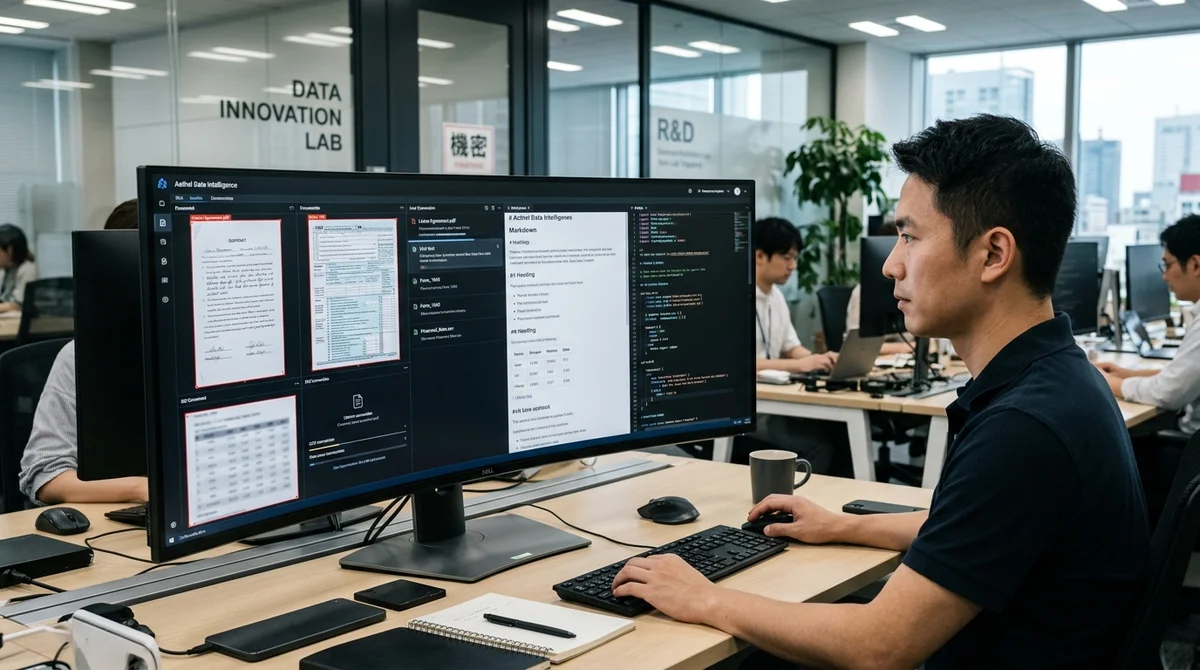
A Baidu apresentou o Qianfan-OCR, um modelo unificado de 4B para trabalhar com documentos que reúne reconhecimento de texto, análise de estrutura e compreensão do conteúdo. Em vez do pipeline clássico de OCR com várias etapas, o sistema converte a imagem do documento diretamente em Markdown estruturado e executa tarefas conforme o pedido do usuário.
Por que o mercado está abandonando os pipelines de OCR
Os sistemas de OCR clássicos costumam ser montados com vários blocos independentes: um localiza as áreas da página, outro reconhece o texto e um terceiro tenta entender tabelas, títulos e ordem de leitura. Essa abordagem funciona enquanto o documento é simples, mas começa a falhar em layouts complexos, digitalizações, formulários, conteúdo misto, modelos fora do padrão e arquivos de várias páginas. Quanto mais etapas na cadeia, maior o risco de um erro no início estragar todo o resultado.
Nesse contexto, a Baidu Qianfan aposta em uma abordagem única de visão e linguagem. O Qianfan-OCR não deve apenas ler caracteres, mas perceber o documento como um objeto inteiro: com blocos, estrutura, lógica e significado. Para as empresas, é uma mudança importante, porque o negócio normalmente não precisa do texto em si, mas de dados prontos para uso em busca, análise, automação e cenários internos de IA, inclusive processos em produção.
O que o Qianfan-OCR faz
Segundo a descrição da equipe, é um modelo end-to-end com 4 bilhões de parâmetros que reúne análise de documentos, layout analysis e document understanding em uma só arquitetura. A principal diferença em relação ao OCR tradicional é que o modelo não depende de uma longa sequência de módulos encadeados. Em vez disso, ele recebe a imagem como entrada e devolve de imediato um resultado estruturado, incluindo a conversão de imagem para Markdown. Isso reduz bastante o número de transformações intermediárias.
A lógica guiada por prompt merece destaque. O modelo pode ser usado não só para o reconhecimento básico, mas também para tarefas aplicadas, em que o usuário descreve exatamente o que quer extrair do documento. O artigo menciona de forma explícita cenários como extração de tabelas e respostas a perguntas sobre o documento. Isso aproxima o OCR de uma interface para trabalhar com arquivos corporativos nos fluxos das empresas, e não de uma ferramenta de arquivo para digitalizações.
O formato Markdown também importa. Para equipes que constroem bases de conhecimento, busca com IA ou pipelines para LLMs, não basta obter texto sem estrutura. É preciso ter títulos, listas, tabelas e uma ordem lógica dos blocos. Se o modelo entrega o documento já em uma forma conveniente para processamento por máquina, reduz-se o pós-processamento e o resultado fica mais adequado para indexação automática, sumarização e uma camada posterior de perguntas e respostas. Para a integração, é um ganho claro.
- Conversão direta da imagem do documento em Markdown
- Análise da estrutura da página sem um pipeline separado de vários módulos
- Extração de tabelas sob demanda do usuário
- Respostas a perguntas sobre o conteúdo do documento
- Um único modelo no lugar de um conjunto de componentes isolados
Onde isso pode ser útil
O valor prático desses modelos está em reduzir o número de operações intermediárias entre o documento e a ação útil. Se o sistema realmente entende de forma estável layout, texto e significado em uma única passada, fica mais simples processar contratos, manuais, relatórios, formulários, apresentações e bases de conhecimento internas. Isso é especialmente relevante para equipes que querem converter automaticamente PDFs e digitalizações em um formato adequado para RAG, busca de conhecimento ou análise posterior por LLMs.
Para desenvolvedores e times de produto, há outro ponto: a unificação reduz a complexidade de engenharia. Em vez de manter vários serviços de OCR e pós-processamento, é possível montar um stack mais curto. Isso não garante qualidade perfeita em todos os tipos de documento, mas a direção é clara: o mercado está migrando de um conjunto de detectores especializados para grandes modelos que tratam o documento como um objeto multimodal, já o preparam para tarefas downstream e colocam novos cenários no ar mais rápido.
O que isso significa
O Qianfan-OCR mostra que o OCR está deixando de ser uma tecnologia restrita de reconhecimento de caracteres para se tornar uma camada de inteligência documental. Se esses modelos confirmarem a qualidade em cenários reais, ficará mais fácil para as empresas automatizar o trabalho com documentos sem pipelines complexos de várias etapas e sem a montagem manual de componentes separados. Quem mais ganha são as equipes que precisam passar rápido de PDFs e digitalizações para dados prontos para busca, análise e assistentes de IA.
Perguntas frequentes sobre a notícia
Por que o mercado está abandonando os pipelines de OCR?
Os sistemas de OCR clássicos costumam ser montados com vários blocos independentes: um localiza as áreas da página, outro reconhece o texto e um terceiro tenta entender tabelas, títulos e ordem de leitura. Essa abordagem funciona enquanto o documento é simples, mas começa a falhar em layouts complexos, digitalizações, formulários, conteúdo misto, modelos fora do padrão e arquivos de várias páginas. Quanto mais etapas na cadeia, maior o risco de um erro no início estragar todo o resultado. Nesse contexto, a Baidu Qianfan aposta em uma abordagem única de visão e linguagem. O
O que o Qianfan-OCR faz?
Segundo a descrição da equipe, é um modelo end-to-end com 4 bilhões de parâmetros que reúne análise de documentos, layout analysis e document understanding em uma só arquitetura. A principal diferença em relação ao OCR tradicional é que o modelo não depende de uma longa sequência de módulos encadeados. Em vez disso, ele recebe a imagem como entrada e devolve de imediato um resultado estruturado, incluindo a conversão de imagem para Markdown. Isso reduz bastante o número de transformações intermediárias. A lógica guiada por prompt merece destaque. O modelo pode ser usado não
Onde isso pode ser útil?
O valor prático desses modelos está em reduzir o número de operações intermediárias entre o documento e a ação útil. Se o sistema realmente entende de forma estável layout, texto e significado em uma única passada, fica mais simples processar contratos, manuais, relatórios, formulários, apresentações e bases de conhecimento internas. Isso é especialmente relevante para equipes que querem converter automaticamente PDFs e digitalizações em um formato adequado para RAG, busca de conhecimento ou análise posterior por LLMs. Para desenvolvedores e times de produto, há outro ponto
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.