OpenAI lança Privacy Filter, modelo aberto para remover dados pessoais de textos
A OpenAI lançou o Privacy Filter, um modelo aberto que remove automaticamente dados pessoais (PII) de textos. Apesar dos 1,5 bilhão de parâmetros, apenas 50 milhões são realmente ativados, e o modelo roda direto no navegador via WebAssembly, sem infraestrutura de servidor. Ele encontra nomes, endereços, telefones e documentos de identificação e os troca por marcadores padrão, como [NOME] ou [ENDEREÇO]. Serve para ambientes self-hosted e pipelines de CI/CD.
Processado por IA de MarkTechPost; editado por Hamidun News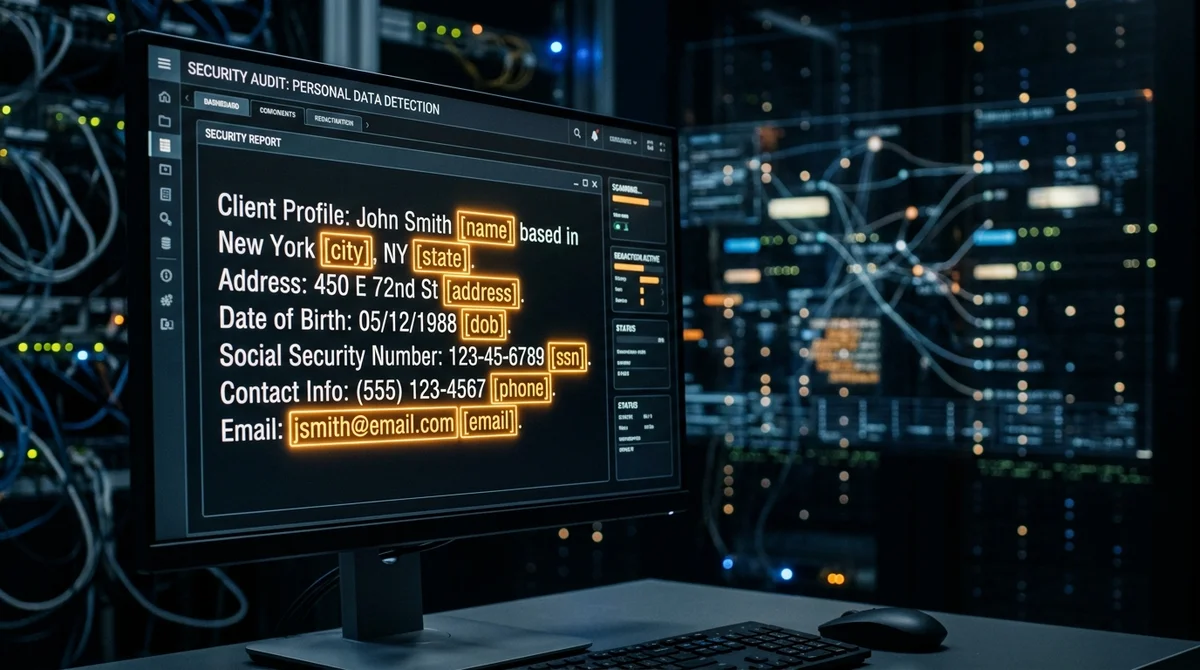
A OpenAI publicou o Privacy Filter, um modelo aberto baseado em um decodificador destilado que encontra e remove dados pessoais (PII) de textos. Apesar de os pesos somarem 1,5 bilhão de parâmetros, apenas 50 milhões ficam ativos durante a inferência, o que permite rodá-lo direto no navegador, sem infraestrutura de servidor.
O que é o Privacy Filter
O Privacy Filter é um modelo de linguagem especializado em uma única tarefa: detectar e censurar automaticamente dados pessoais (Personally Identifiable Information, PII) em textos. Não é um assistente de chat generalista, mas uma ferramenta utilitária, focada exclusivamente em encontrar informações sensíveis e substituí-las por marcadores padronizados.
A especialização é uma vantagem: um modelo ajustado de forma estreita resolve a tarefa melhor que LLMs generalistas, que muitas vezes deixam passar dados pessoais escritos de maneira atípica ou erram em contextos complexos.
A base é um decodificador destilado: um modelo professor grande transfere seu conhecimento a um modelo aluno compacto por meio da destilação. O resultado é alta precisão de detecção com exigências computacionais bem menores. O modelo está disponível em acesso aberto, e qualquer empresa pode incorporá-lo aos próprios pipelines sem enviar dados aos servidores da OpenAI.
Arquitetura: 50 milhões de 1,5 bilhão
O detalhe técnico central é a diferença entre o total de parâmetros (1,5 bilhão) e os que são realmente ativados no processamento de cada token (50 milhões). Essa abordagem é típica de arquiteturas de ativação esparsa: diferentes blocos neurais se especializam em diferentes aspectos da tarefa e são ativados seletivamente, conforme os dados de entrada.
Isso torna o Privacy Filter prático em cenários com recursos limitados:
- Navegador: compatível com WebAssembly e ONNX, então os dados não saem do dispositivo do usuário
- Dispositivos edge: 50M de parâmetros ativos permitem rodar sem GPU em notebooks e smartphones
- Self-hosted: o modelo cabe por inteiro na infraestrutura da empresa
- Pipelines de CI/CD: inferência rápida, sem dependências de nuvem nem custos adicionais
O que ele detecta
O Privacy Filter reconhece um amplo conjunto de categorias de dados pessoais, cobrindo requisitos centrais de GDPR, LGPD e CCPA:
- Nomes, sobrenomes, iniciais (incluindo reconhecimento contextual sem marcadores explícitos)
- Endereços, códigos postais, coordenadas geográficas
- Telefones e endereços de e-mail
- Documentos de identificação: passaportes, SSN, INN (número de identificação fiscal russo), carteiras de motorista
- Dados financeiros: números de cartões e contas bancárias
- Identificadores médicos
O modelo não apenas marca os trechos com PII, mas também os substitui por marcadores padrão: [NOME], [ENDEREÇO], [TELEFONE]. O texto de saída já fica pronto para o processamento seguinte, sem pós-processamento manual.
Contexto regulatório
A pressão regulatória sobre dados pessoais cresce no mundo todo. A GDPR na Europa, a LGPD no Brasil e a CCPA na Califórnia exigem das empresas um tratamento cuidadoso de informações sensíveis. A maioria das soluções comerciais de anonimização automática ficava aquém em qualidade ou exigia enviar os dados para a nuvem, o que por si só contrariava a lógica da confidencialidade.
O Privacy Filter preenche essa lacuna: um modelo aberto, compatível com o navegador, que uma equipe pequena pode incorporar a um produto em um dia, sem sacrificar a privacidade dos usuários.
O que isso significa
A OpenAI investe de forma consistente em infraestrutura aberta ao lado dos carros-chefes comerciais. O Privacy Filter mostra que a empresa vê mercado não só no acesso via API ao GPT, mas também em ferramentas utilitárias que atendem necessidades operacionais específicas. É um sinal para o mercado: ferramentas open source de nível corporativo para segurança de dados em IA estão virando norma.
Para as empresas, é uma solução pronta para anonimização, sem desenvolver do zero e sem depender da nuvem.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
O que é o Privacy Filter?
O Privacy Filter é um modelo de linguagem especializado em uma única tarefa: detectar e censurar automaticamente dados pessoais (Personally Identifiable Information, PII) em textos. Não é um assistente de chat generalista, mas uma ferramenta utilitária, focada exclusivamente em encontrar informações sensíveis e substituí-las por marcadores padronizados. A especialização é uma vantagem: um modelo ajustado de forma estreita resolve a tarefa melhor que LLMs generalistas, que muitas vezes deixam passar dados pessoais escritos de maneira atípica ou erram em contextos complexos.
O que se sabe sobre Arquitetura: 50 milhões de 1,5 bilhão?
O detalhe técnico central é a diferença entre o total de parâmetros (1,5 bilhão) e os que são realmente ativados no processamento de cada token (50 milhões). Essa abordagem é típica de arquiteturas de ativação esparsa: diferentes blocos neurais se especializam em diferentes aspectos da tarefa e são ativados seletivamente, conforme os dados de entrada. Isso torna o Privacy Filter prático em cenários com recursos limitados: Navegador: compatível com WebAssembly e ONNX, então os dados não saem do dispositivo do usuário Dispositivos edge: 50M de parâmetros ativos permitem rodar
O que ele detecta?
O Privacy Filter reconhece um amplo conjunto de categorias de dados pessoais, cobrindo requisitos centrais de GDPR, LGPD e CCPA: Nomes, sobrenomes, iniciais (incluindo reconhecimento contextual sem marcadores explícitos) Endereços, códigos postais, coordenadas geográficas Telefones e endereços de e-mail Documentos de identificação: passaportes, SSN, INN (número de identificação fiscal russo), carteiras de motorista Dados financeiros: números de cartões e contas bancárias Identificadores médicos O modelo não apenas marca os trechos com PII, mas também os substitui por marcad
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.