OpenAI explica quais dados o ChatGPT usa para treinamento e como protege a privacidade
A OpenAI detalhou como o ChatGPT usa dados para treinamento e quais controles de privacidade os usuários têm. A empresa diz aplicar o Privacy Filter para mascarar informações pessoais, e que é possível desativar nas configurações o uso de novas conversas para melhorar os modelos. Para um modo mais fechado, há o Temporary Chat: essas conversas não entram no histórico, não criam memória e são excluídas após 30 dias.
Processado por IA de OpenAI Blog; editado por Hamidun News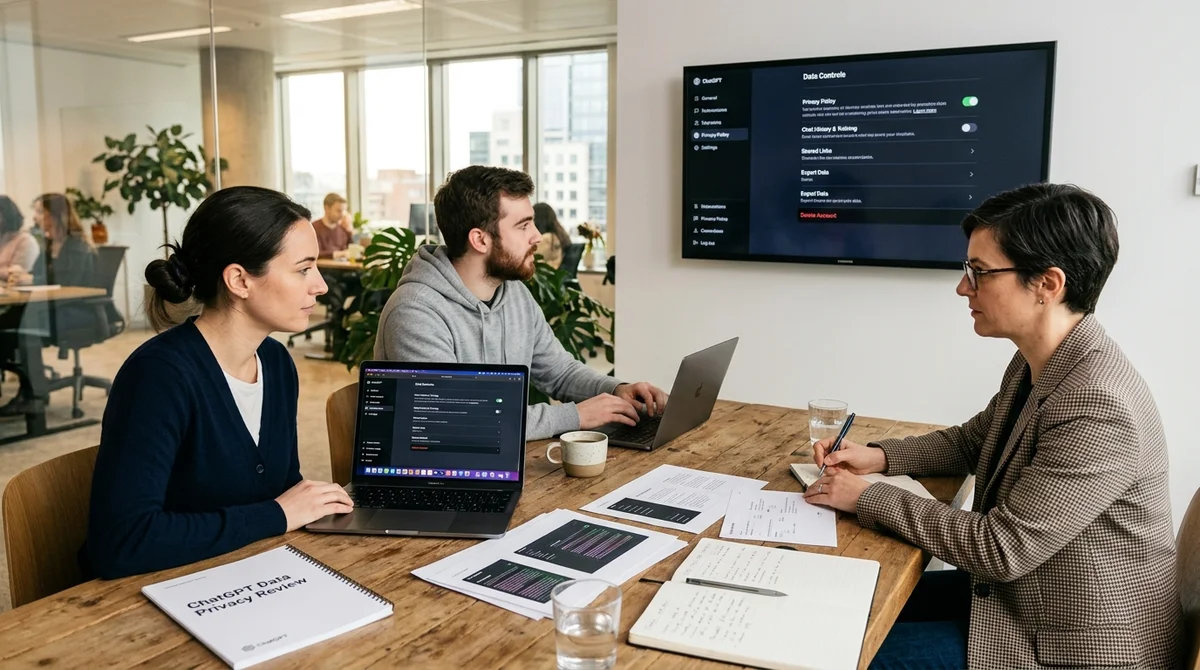
Em 6 de maio, a OpenAI publicou uma explicação detalhada de como o ChatGPT adquire conhecimento sobre o mundo e, ao mesmo tempo, tenta não levar para o treinamento dados pessoais desnecessários. A empresa descreveu as fontes de dados, os filtros internos e as configurações que o usuário pode usar para limitar o uso das próprias conversas.
De onde vêm os dados
No post, a OpenAI divide as fontes de dados em várias categorias. Para treinar os modelos que sustentam o ChatGPT, a empresa usa informações publicamente disponíveis na internet, dados de parcerias e material fornecido ou gerado por usuários, contratados e pesquisadores. A ideia é que o modelo absorva padrões gerais, fatos e relações entre temas, e não memorize histórias pessoais individuais. Segundo a OpenAI, é justamente esse conjunto amplo de fontes que ajuda a tornar as respostas mais úteis, estáveis e seguras.
A empresa esclarece ainda um detalhe importante: no caso de conteúdo da internet aberta, só são usados no treinamento materiais em acesso livre e aberto. Como exemplos, a OpenAI cita posts públicos, blogs e discussões em fóruns abertos. Isso não encerra as dúvidas sobre os limites do uso aceitável de dados abertos, mas mostra que a empresa tenta formalizar uma regra: nem tudo que está na rede é considerado automaticamente adequado para treinamento se o acesso a esse conteúdo for restrito.
Como o conteúdo pessoal é removido
Antes de os dados entrarem no treinamento, a OpenAI os passa por um conjunto de mecanismos de proteção que devem reduzir o volume de informação pessoal nos conjuntos de dados. O principal é o Privacy Filter, ferramenta para encontrar e mascarar dados pessoais em texto. Segundo a empresa, o filtro é aplicado em várias etapas do processo, inclusive em conjuntos de dados públicos e em conversas de usuários, quando a pessoa tem a configuração Improve the model for everyone ativada. A OpenAI também afirma ter tornado o Privacy Filter gratuito para outros desenvolvedores, para que a abordagem possa ser usada fora do ChatGPT.
Há ainda uma camada de proteção que não se relaciona ao treinamento, mas às próprias respostas do ChatGPT. O serviço deve recusar pedidos de informações privadas ou sensíveis sobre pessoas específicas, embora a OpenAI reconheça abertamente que erros ainda são possíveis. Se uma informação pessoal aparecer em uma resposta e a pessoa a considerar imprecisa ou inadequada, ela pode enviar uma solicitação pelo portal de privacidade. A empresa ressalta que a privacidade e a reação a riscos graves, como ameaças críveis de violência, devem funcionar ao mesmo tempo, sem atrapalhar uma à outra.
"A proteção da privacidade é uma parte central de como construímos o
ChatGPT."
Quais configurações existem
A parte mais prática do material é a lista de chaves que o usuário pode ajustar para decidir quantos dados entrega ao sistema. A OpenAI enfatiza que o controle sobre as conversas não está escondido na documentação, mas colocado direto na interface do ChatGPT. Ou seja, não se trata apenas de princípios da empresa, mas de ações bem práticas: dá para desativar a participação de chats novos no treinamento, remover a memória ou passar para um modo temporário separado para pedidos mais sensíveis.
- Em Settings -> Data Controls é possível desativar a opção Improve the model for everyone. Depois disso, os chats novos continuam no histórico, mas não serão usados para treinar modelos.
- O modo Temporary Chat inicia uma conversa descartável: ela não é salva no histórico, não cria memória e não é usada para melhorar os modelos.
- Chats temporários são mantidos por 30 dias por motivos de segurança e depois excluídos.
- O recurso Memory pode ser visualizado, editado, limpo ou totalmente desativado, caso o usuário não queira que o ChatGPT lembre detalhes passados.
- O usuário também pode exportar seus dados, excluir a conta e enviar uma solicitação pelo portal de privacidade.
Há também um aviso direto: não é recomendável enviar ao ChatGPT informações sensíveis que o usuário não estaria disposto a compartilhar nem no contexto de uma verificação ou processamento pelo sistema. É uma ressalva importante, porque muita gente enxerga a interface de chat como um caderno privado ou um interlocutor seguro por padrão. A OpenAI, ao contrário, tenta transmitir um modelo de uso mais sóbrio: o usuário tem ferramentas de controle, mas a responsabilidade pelo que digita no serviço não desaparece.
O que isso significa
Na prática, a OpenAI tenta levar a conversa sobre privacidade do nível das promessas genéricas para um conjunto de regras e chaves concretas. Para os usuários, isso é útil: ficou mais claro quais dados podem participar do treinamento, como desativar esse cenário e em que um chat comum difere do Temporary Chat. Para o mercado, é um sinal de que a confiança em produtos de IA depende cada vez mais não só da qualidade do modelo, mas também da transparência no tratamento de informações pessoais.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
O que se sabe sobre De onde vêm os dados?
No post, a OpenAI divide as fontes de dados em várias categorias. Para treinar os modelos que sustentam o ChatGPT, a empresa usa informações publicamente disponíveis na internet, dados de parcerias e material fornecido ou gerado por usuários, contratados e pesquisadores. A ideia é que o modelo absorva padrões gerais, fatos e relações entre temas, e não memorize histórias pessoais individuais. Segundo a OpenAI, é justamente esse conjunto amplo de fontes que ajuda a tornar as respostas mais úteis, estáveis e seguras. A empresa esclarece ainda um detalhe importante: no caso de
Como o conteúdo pessoal é removido?
Antes de os dados entrarem no treinamento, a OpenAI os passa por um conjunto de mecanismos de proteção que devem reduzir o volume de informação pessoal nos conjuntos de dados. O principal é o Privacy Filter, ferramenta para encontrar e mascarar dados pessoais em texto. Segundo a empresa, o filtro é aplicado em várias etapas do processo, inclusive em conjuntos de dados públicos e em conversas de usuários, quando a pessoa tem a configuração Improve the model for everyone ativada. A OpenAI também afirma ter tornado o Privacy Filter gratuito para outros desenvolvedores, para qu
O que se sabe sobre Quais configurações existem?
A parte mais prática do material é a lista de chaves que o usuário pode ajustar para decidir quantos dados entrega ao sistema. A OpenAI enfatiza que o controle sobre as conversas não está escondido na documentação, mas colocado direto na interface do ChatGPT. Ou seja, não se trata apenas de princípios da empresa, mas de ações bem práticas: dá para desativar a participação de chats novos no treinamento, remover a memória ou passar para um modo temporário separado para pedidos mais sensíveis. Em Settings -> Data Controls é possível desativar a opção Improve the model for ever
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.