OpenAI Privacy Filter: como montar um pipeline de produção para encontrar e mascarar PII
Um guia do OpenAI Privacy Filter mostra passo a passo como montar um pipeline que encontra e edita dados pessoais em textos. A base é um modelo de classificação de tokens que detecta nomes, e-mails, telefones, endereços e segredos. Depois, funções auxiliares transformam isso em um processo de produção com mascaramento automático e saída previsível para logs, tickets, formulários e documentos internos. O guia é voltado a equipes que lidam com texto não estruturado, em que um vazamento de PII rapidamente deixa de ser erro técnico e vira problema jurídico.
Processado por IA de MarkTechPost; editado por Hamidun News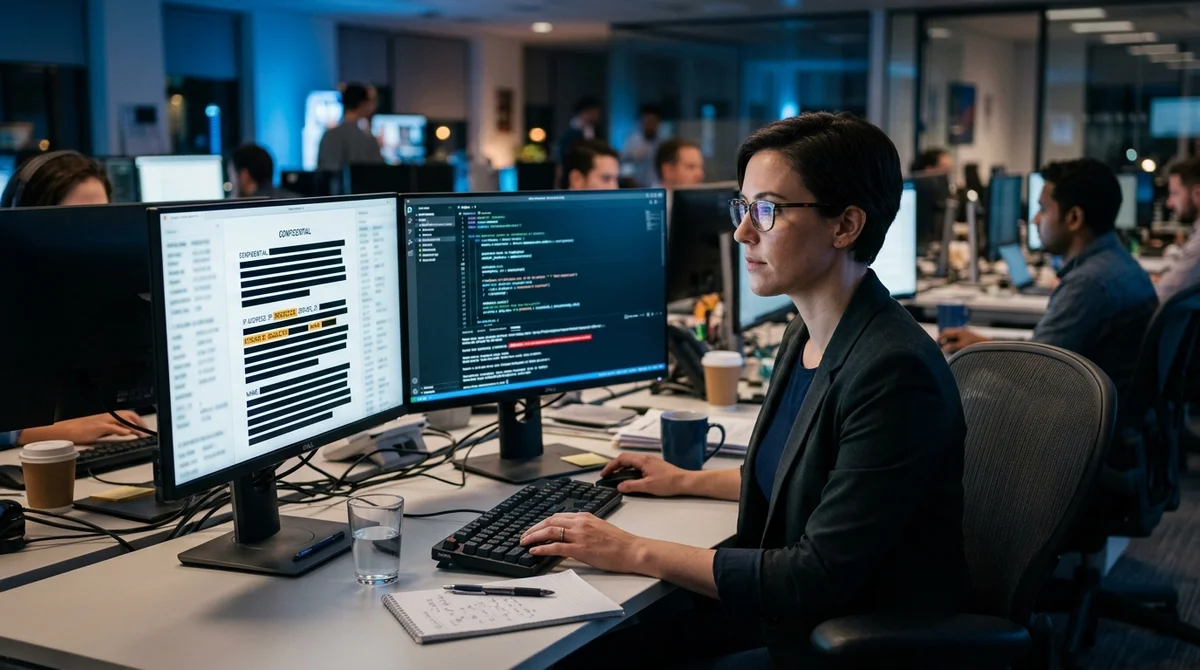
O OpenAI Privacy Filter foi destrinchado em formato de guia prático: da configuração do ambiente a um pipeline pronto que encontra e oculta dados pessoais no texto. O material é útil para quem trabalha com logs, solicitações, documentos de suporte e quaisquer dados em que um vazamento de PII rapidamente deixa de ser erro técnico e vira problema jurídico.
Como o filtro funciona
No centro do exemplo está um modelo de classificação de tokens que percorre o texto e marca trechos parecidos com dados sensíveis. O guia o usa como camada básica para verificar automaticamente documentos não estruturados: e-mails, anotações, chamados de usuários e registros internos. Em vez de busca manual, o sistema destaca de imediato entidades específicas e devolve as categorias a que pertencem.
Isso permite não só enxergar o risco, mas também decidir por código o que fazer com cada trecho encontrado: ocultar, substituir, apagar ou enviar para uma revisão adicional.
Depois de carregar o modelo, os autores passam ao código de apoio, sem o qual um filtro desses raramente chega à produção. São necessárias funções que normalizem o texto de entrada, reúnam as entidades encontradas em uma lista única, tratem corretamente as sobreposições e depois apliquem a edição à string original.
Outra tarefa é não quebrar o texto após a substituição. Se os trechos forem cortados de forma ingênua, é possível danificar o formato, deslocar os índices e perder a legibilidade. Por isso o pipeline é construído como uma sequência de etapas: detecção, pós-processamento, mascaramento e entrega da versão já limpa do documento.
Que dados ele procura
Segundo a descrição, neste exemplo o OpenAI Privacy Filter está configurado para várias das categorias mais comuns de PII e segredos. Esse conjunto cobre cenários básicos de suporte, CRM, bases de conhecimento internas e qualquer sistema em que funcionários copiam para o texto dados pessoais de usuários ou chaves de acesso de serviço. São as entidades que mais vazam em texto não estruturado sem que a equipe perceba, e só aparecem na hora de enviar os dados para análise, busca ou um LLM externo.
- Nomes e sobrenomes
- Endereços de e-mail
- Números de telefone
- Endereços postais
- Segredos: senhas, tokens, chaves de API e outras strings sensíveis
O ponto prático é que tipos diferentes de dados exigem políticas de tratamento diferentes. Um telefone pode ser mascarado parcialmente, um e-mail trocado por um placeholder, um endereço removido por completo, e os segredos é melhor limpar de imediato, sem possibilidade de recuperação. Por isso o pipeline importa mais do que uma chamada isolada ao modelo: depois da detecção começa a lógica de negócio. A própria equipe decide quais categorias bloquear de forma rígida, quais registrar para auditoria e quais enviar a uma pessoa para revisão manual, se a confiança do modelo não for alta o bastante.
Da demo para a produção
O principal valor deste tutorial é mostrar não um modelo isolado, mas um modelo de serviço que funciona. Em um produto real, a PII quase nunca vive em um único campo limpo. Ela cai em tickets de suporte, transcrições de chamadas, campos de texto livre, exportações de sistemas externos e até em prompts que a empresa envia a outros LLMs. Se não houver um filtro antes, é possível vazar sem querer telefones de clientes, endereços residenciais ou chaves internas. Esse risco é especialmente visível em empresas que incorporam IA aos processos rapidamente, sem uma camada de privacidade dedicada.
Outro ponto importante é a repetibilidade. Um pipeline de produção não serve para uma demo bonita, mas para processar de forma estável grandes volumes de texto. Isso significa que o sistema precisa de etapas claras, um formato de resultado previsível e a possibilidade de ser integrado a um ETL, uma API ou uma fila de tarefas. Na prática, esse filtro pode ser colocado antes da indexação de documentos, antes do envio de dados a modelos externos, antes da análise de grandes massas de texto e antes da publicação de materiais internos. Quanto mais cedo a edição de PII entra, menor a chance de que dados sensíveis sigam adiante na cadeia.
O que isso significa
A filtragem de PII deixa de ser um opcional e passa a ser uma camada obrigatória de qualquer infraestrutura de IA que trabalhe com texto de usuários. O guia do OpenAI Privacy Filter é útil porque mostra não uma ideia abstrata de privacidade, mas um caminho claro: encontrar as entidades sensíveis, aplicar regras de edição e só então repassar os dados ao restante do sistema.
- 1 de nov. de 2026Modelos locais perdem para Opus e Codex: 0,21 ponto no MacBook contra 1,00 do Codex
- 1 de nov. de 2026Kimi marca 96,2% em teste de análise em base 1C e vira reserva caso o Claude seja bloqueado
- 1 de nov. de 2026OpenAI reescreve as regras de comportamento do GPT: cinco valores e uma cadeia de prioridades
- 1 de nov. de 2026Google admite que o AI Mode reduz a receita da Busca; ações caem 15%
Perguntas frequentes sobre a notícia
Como o filtro funciona?
No centro do exemplo está um modelo de classificação de tokens que percorre o texto e marca trechos parecidos com dados sensíveis. O guia o usa como camada básica para verificar automaticamente documentos não estruturados: e-mails, anotações, chamados de usuários e registros internos. Em vez de busca manual, o sistema destaca de imediato entidades específicas e devolve as categorias a que pertencem. Isso permite não só enxergar o risco, mas também decidir por código o que fazer com cada trecho encontrado: ocultar, substituir, apagar ou enviar para uma revisão adicional. Dep
O que se sabe sobre Que dados ele procura?
Segundo a descrição, neste exemplo o OpenAI Privacy Filter está configurado para várias das categorias mais comuns de PII e segredos. Esse conjunto cobre cenários básicos de suporte, CRM, bases de conhecimento internas e qualquer sistema em que funcionários copiam para o texto dados pessoais de usuários ou chaves de acesso de serviço. São as entidades que mais vazam em texto não estruturado sem que a equipe perceba, e só aparecem na hora de enviar os dados para análise, busca ou um LLM externo. Nomes e sobrenomes Endereços de e-mail Números de telefone Endereços postais Seg
O que se sabe sobre Da demo para a produção?
O principal valor deste tutorial é mostrar não um modelo isolado, mas um modelo de serviço que funciona. Em um produto real, a PII quase nunca vive em um único campo limpo. Ela cai em tickets de suporte, transcrições de chamadas, campos de texto livre, exportações de sistemas externos e até em prompts que a empresa envia a outros LLMs. Se não houver um filtro antes, é possível vazar sem querer telefones de clientes, endereços residenciais ou chaves internas. Esse risco é especialmente visível em empresas que incorporam IA aos processos rapidamente, sem uma camada de privaci
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
O essencial da IA — uma vez por semana
Sete histórias que realmente importaram, escolhidas a dedo. Sem ruído nem releases.
Pronto! Verifique seu e-mail para a confirmação.