MELT-1 : comment Metabolic AI teste la survie des agents
Habr a publié un article sur MELT-1, un benchmark qui ne mesure pas le MMLU, mais combien de temps un agent AI survit sous drift de distribution. Metabolic AI a affiché un résultat 1600× meilleur que Llama-7B INT8 sur la tâche de manipulation. Le benchmark est ouvert : scénarios, oracle, code.
Traité par IA depuis Habr AI ; édité par Hamidun News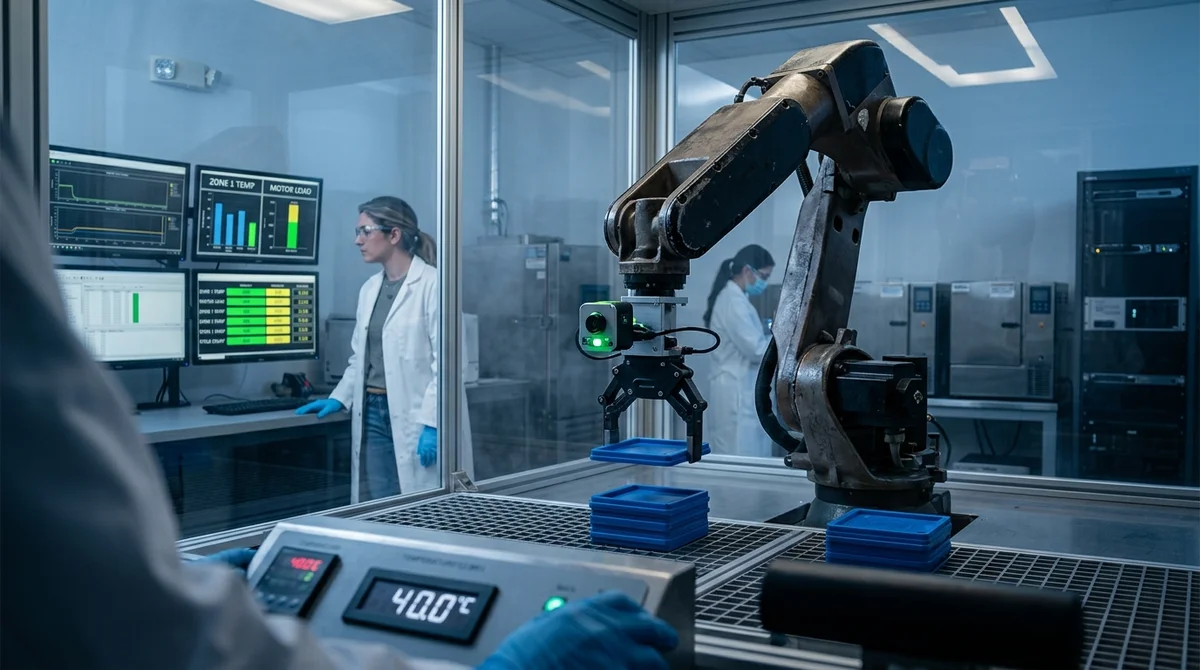
MELT-1 — ce n'est pas MMLU et ce n'est pas MMLU Pro. C'est un nouveau benchmark ouvert pour tester des agents IA dans des conditions réelles : non pas "ce que sait le modèle", mais "combien d'heures survivra-t-il quand tout change autour de lui".
Trois axes au lieu d'un nombre
Les benchmarks conventionnels (MMLU, ARC, GPQA) supposent des conditions idéales : questions statiques, distribution de données stable. MELT-1 mesure trois choses à la fois :
- Économie du calcul : combien coûte l'entretien d'un agent en conditions opérationnelles ($/1M de solutions réussies)
- Survie sous dérive : combien d'heures l'agent fonctionne sans réentraînement avant de commencer à faire des erreurs
- Latence sous stress : temps p99 du capteur à l'actionneur à 40°C sur 30 jours consécutifs d'inférence, 5 graines, deux profils de température.
Ce n'est pas un test de laboratoire — c'est un scénario dans lequel un vrai robot doit fonctionner jour et nuit, été et hiver.
Résultats : différence de 1600×
Sur une manipulation en boucle fermée (robot saisit et empile des objets), Metabolic AI — une architecture sans transformer — a surpassé Llama-class 7B INT8 par 9,4× en coût et par 8,5× en survie sous dérive. Composite : 1600×.
Ce n'est pas parce que Llama est mauvais. C'est parce que les transformers 7B sont conçus pour la récupération statique de connaissances, et non pour un agent incarné qu'il faut maintenir actif 24/7.
«
Les transformers meurent après 11 heures sous dérive », écrivent les auteurs.
L'ouverture comme norme
L'architecture Metabolic AI est fermée (brevet en cours d'examen), mais le benchmark est entièrement ouvert : harnais, scènes de test, oracle, scripts de sensibilité, codeur VAE de dérive pour la reproduction. Méthodologie en PDF avec section sur les menaces à la validité. Les chercheurs invitent d'autres à exécuter leurs agents et à placer les résultats côte à côte.
C'est ainsi que la science de l'apprentissage profond devrait être menée : propriété intellectuelle fermée, benchmarks ouverts, reproductibilité par le code.
Qu'est-ce que cela signifie
MELT-1 pourrait devenir une nouvelle norme pour la robotique et l'IA incarnée. MMLU montre si un modèle est « intelligent ». MELT-1 montre s'il est « viable ».
- 31 oct. 2026La passerelle LLM open source KTMS 1.0 branche ses propres GPU au cloud et résiste aux pannes
- 31 oct. 2026Un modèle vidéo de 22 milliards de paramètres tourne sur une RTX 3080 avec 10 Go de mémoire
- 29 oct. 2026Conflit de savoirs dans le RAG : pourquoi il faut une probabilité de justesse du contexte, pas un algorithme rigide
- 29 oct. 2026Liquid AI lance LFM3 : six modèles multimodaux de 2B avec un contexte de 256K
Questions clés sur cet article
Que sait-on sur Trois axes au lieu d'un nombre ?
Les benchmarks conventionnels (MMLU, ARC, GPQA) supposent des conditions idéales : questions statiques, distribution de données stable. MELT-1 mesure trois choses à la fois : Économie du calcul : combien coûte l'entretien d'un agent en conditions opérationnelles ($/1M de solutions réussies) Survie sous dérive : combien d'heures l'agent fonctionne sans réentraînement avant de commencer à faire des erreurs Latence sous stress : temps p99 du capteur à l'actionneur à 40°C sur 30 jours consécutifs d'inférence, 5 graines, deux profils de température. Ce n'est pas un test de labor
Que sait-on sur Résultats : différence de 1600× ?
Sur une manipulation en boucle fermée (robot saisit et empile des objets), Metabolic AI — une architecture sans transformer — a surpassé Llama-class 7B INT8 par 9,4× en coût et par 8,5× en survie sous dérive. Composite : 1600×. Ce n'est pas parce que Llama est mauvais. C'est parce que les transformers 7B sont conçus pour la récupération statique de connaissances, et non pour un agent incarné qu'il faut maintenir actif 24/7. « Les transformers meurent après 11 heures sous dérive », écrivent les auteurs.
Que sait-on sur L'ouverture comme norme ?
L'architecture Metabolic AI est fermée (brevet en cours d'examen), mais le benchmark est entièrement ouvert : harnais, scènes de test, oracle, scripts de sensibilité, codeur VAE de dérive pour la reproduction. Méthodologie en PDF avec section sur les menaces à la validité. Les chercheurs invitent d'autres à exécuter leurs agents et à placer les résultats côte à côte. C'est ainsi que la science de l'apprentissage profond devrait être menée : propriété intellectuelle fermée, benchmarks ouverts, reproductibilité par le code.
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.