NVIDIA dévoile Nemotron OCR v2 : un OCR multilingue entraîné sur 12,2 millions de documents synthétiques
NVIDIA a détaillé Nemotron OCR v2, un modèle d'OCR multilingue entraîné principalement sur 12,2 millions de documents synthétiques. Le pari ne porte pas sur une nouvelle architecture, mais sur des données à grande échelle : un seul moteur lit l'anglais, le russe, le japonais, le coréen et le chinois, et traite jusqu'à 34,7 pages par seconde sur une A100. Environ 680 000 images réelles ont aussi été ajoutées à l'entraînement.
Traité par IA depuis Hugging Face Blog ; édité par Hamidun News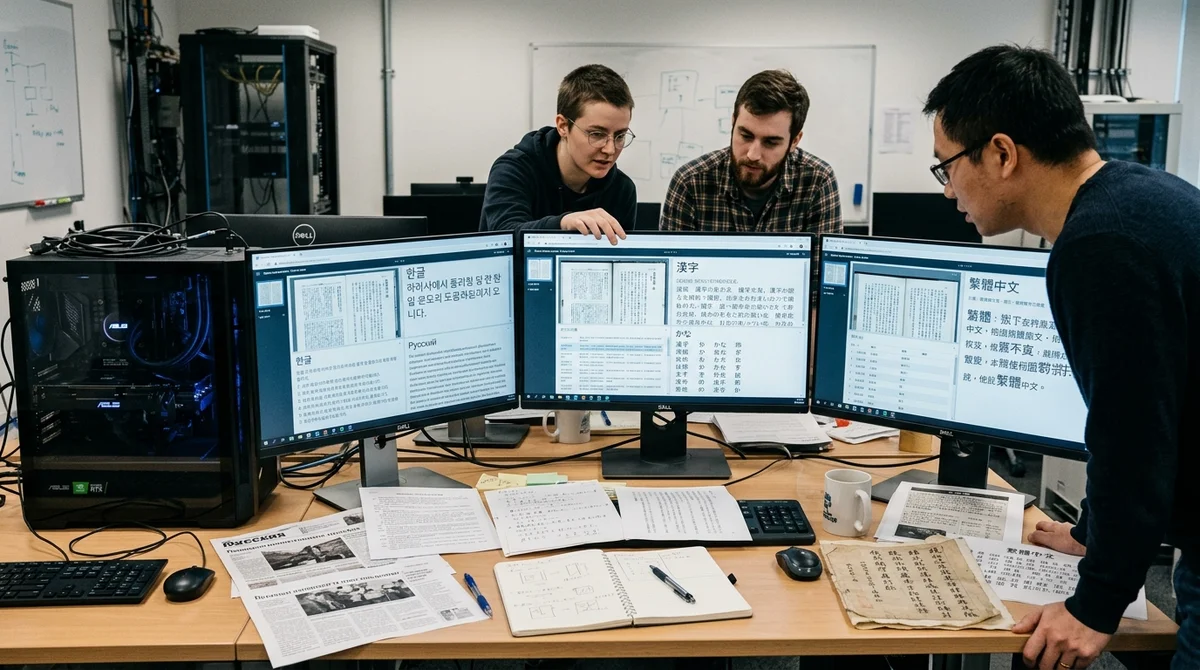
NVIDIA a montré comment elle a construit Nemotron OCR v2, un système d'OCR multilingue dont le principal bond vient non pas d'astuces architecturales, mais de données synthétiques à grande échelle. L'entreprise a constitué un jeu de 12,26 millions de documents générés artificiellement et s'en est servie pour entraîner un modèle qui lit plusieurs langues avec un seul moteur et atteint jusqu'à 34,7 pages par seconde sur une seule A100.
Priorité aux données
La version précédente, Nemotron OCR v1, fonctionnait bien en anglais, mais échouait dans les autres langues. Le benchmark SynthDoG a montré que les valeurs de Normalized Edit Distance pour le japonais, le coréen, le russe et le chinois étaient trop élevées : par endroits, le résultat ressemblait à peine au texte d'origine. L'équipe a même étendu le jeu de caractères de 855 à 14 244 pour couvrir le cyrillique et les écritures CJK, mais le gain est resté modeste. Le modèle pouvait en théorie produire les signes voulus, mais il les voyait presque jamais à l'entraînement.
«
Le goulot d'étranglement, c'étaient les données, pas l'architecture. »
C'est ce qui a marqué le tournant du projet. Annoter à la main des millions de documents avec des boîtes au niveau du mot, de la ligne et du paragraphe aurait coûté beaucoup trop cher, et le scraping de PDF sur le web donne une couche de texte bruitée et de nombreuses erreurs. NVIDIA a donc choisi une autre voie : générer les documents par programme et connaître à l'avance les coordonnées exactes, les transcriptions et l'ordre de lecture de chaque fragment.
Comment le corpus a été construit
Pour les textes, NVIDIA a utilisé mOSCAR, un vaste corpus web multilingue de 163 sous-ensembles linguistiques. Cela a permis de s'appuyer non sur des listes de dictionnaire ni sur du texte automatique, mais sur des phrases plus réalistes, avec une distribution naturelle des mots et des caractères.
Comme moteur de rendu, l'entreprise a retenu SynthDoG, issu du projet Donut, et l'a profondément remanié. En sortie, on obtient non seulement des images de pages, mais une annotation hiérarchique complète au niveau du mot, de la ligne et du paragraphe, plus un graphe de relations qui définit l'ordre de lecture.
Plusieurs ajouts importants rapprochent les données synthétiques des documents réels :
- des mises en page à modèles multiples : colonnes, tableaux, texte vertical, tables des matières, diapositives et pages de style Word
- une annotation non seulement par boîtes, mais aussi par hiérarchie des éléments et liens entre les lignes
- le passage à la reconnaissance par lignes pour le japonais, le coréen et le chinois, où les frontières des mots sont souvent ambiguës
- un large éventail de polices libres, de 165 à 1 258 par langue, dont les familles Google Fonts et Noto
- des augmentations agressives : ombres, contours, bruit, flou, distorsions, variations de luminosité et de fonds
Le jeu final compte 12 258 146 exemples répartis en six catégories linguistiques : anglais, japonais, coréen, russe, chinois simplifié et chinois traditionnel. Le modèle multilingue lui-même fonctionne comme une pile unique pour l'anglais, le russe, le japonais, le coréen et le chinois, sans étape distincte de détection de la langue. La logique d'extension est également simple : si une nouvelle langue dispose d'un corpus de texte et de polices adaptées, le pipeline peut être étendu sans annotation manuelle et sans réécriture de l'architecture.
Vitesse et compromis
Nemotron OCR v2 a été entraîné non seulement sur des données synthétiques, mais aussi sur environ 680 000 images réelles. L'architecture comprend trois parties : un détecteur de texte fondé sur RegNetX-8GF, un module de reconnaissance basé sur un Transformer et un module relationnel qui comprend quelles lignes et quels blocs sont liés entre eux. L'idée clé est qu'un lourd backbone convolutif parcourt la page une seule fois, puis que ses caractéristiques sont réutilisées par tous les autres composants. Ainsi, le système ne dépense pas de calcul supplémentaire pour chaque étape du pipeline séparément.
Sur le benchmark synthétique, l'amélioration paraît très forte. Pour le russe, le NED est passé de 0,564 avec Nemotron OCR v1 à 0,043 avec la v2 ; pour le japonais, de 0,723 à 0,046 ; pour le coréen, de 0,923 à 0,047 ; pour le chinois simplifié, de 0,784 à 0,035. Selon NVIDIA, la version multilingue unique a devancé sur ce jeu jusqu'aux variantes spécialisées par langue de PaddleOCR.
Mais sur l'OmniDocBench réel, le tableau est plus nuancé : Nemotron OCR v2 atteint 34,7 pages par seconde contre 1,2 pour PaddleOCR v5, soit un gain de vitesse de plus de 28 fois, mais il reste en retrait des meilleurs concurrents en précision sur certains sous-ensembles. Le produit fait ici clairement un choix d'équilibre en faveur de la vitesse de traitement plutôt que de la qualité maximale à tout prix.
Ce que cela signifie
Nemotron OCR v2 est un bon signal pour le marché de l'IA documentaire : les données synthétiques ne relèvent plus de l'effet de démonstration, mais constituent un moyen concret de lancer rapidement des modèles d'OCR multilingues et de les étendre à de nouvelles écritures. Pour les entreprises, cela ouvre une voie moins coûteuse vers la reconnaissance de documents, surtout là où la vitesse, l'universalité et le contrôle de l'annotation comptent plus qu'un record absolu sur chaque benchmark.
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
Questions clés sur cet article
Que sait-on sur Priorité aux données ?
La version précédente, Nemotron OCR v1, fonctionnait bien en anglais, mais échouait dans les autres langues. Le benchmark SynthDoG a montré que les valeurs de Normalized Edit Distance pour le japonais, le coréen, le russe et le chinois étaient trop élevées : par endroits, le résultat ressemblait à peine au texte d'origine. L'équipe a même étendu le jeu de caractères de 855 à 14 244 pour couvrir le cyrillique et les écritures CJK, mais le gain est resté modeste. Le modèle pouvait en théorie produire les signes voulus, mais il les voyait presque jamais à l'entraînement. « Le
Comment le corpus a été construit?
Pour les textes, NVIDIA a utilisé mOSCAR, un vaste corpus web multilingue de 163 sous-ensembles linguistiques. Cela a permis de s'appuyer non sur des listes de dictionnaire ni sur du texte automatique, mais sur des phrases plus réalistes, avec une distribution naturelle des mots et des caractères. Comme moteur de rendu, l'entreprise a retenu SynthDoG, issu du projet Donut, et l'a profondément remanié. En sortie, on obtient non seulement des images de pages, mais une annotation hiérarchique complète au niveau du mot, de la ligne et du paragraphe, plus un graphe de relations
Que sait-on sur Vitesse et compromis ?
Nemotron OCR v2 a été entraîné non seulement sur des données synthétiques, mais aussi sur environ 680 000 images réelles. L'architecture comprend trois parties : un détecteur de texte fondé sur RegNetX-8GF, un module de reconnaissance basé sur un Transformer et un module relationnel qui comprend quelles lignes et quels blocs sont liés entre eux. L'idée clé est qu'un lourd backbone convolutif parcourt la page une seule fois, puis que ses caractéristiques sont réutilisées par tous les autres composants. Ainsi, le système ne dépense pas de calcul supplémentaire pour chaque éta
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.