KDnuggets publie un guide d'analyse locale d'appels avec Whisper, BERTopic et Streamlit
KDnuggets a montré comment construire un analyseur local d'appels clients sans API cloud. L'ensemble repose sur Whisper pour la transcription audio, RoBERTa de Hugging Face pour le sentiment et les émotions, BERTopic pour les thèmes et Streamlit pour le tableau de bord. Le projet tourne sur sa propre machine et exige Python 3.9+, FFmpeg et environ 1,5–2 Go pour les modèles.
Traité par IA depuis KDnuggets ; édité par Hamidun News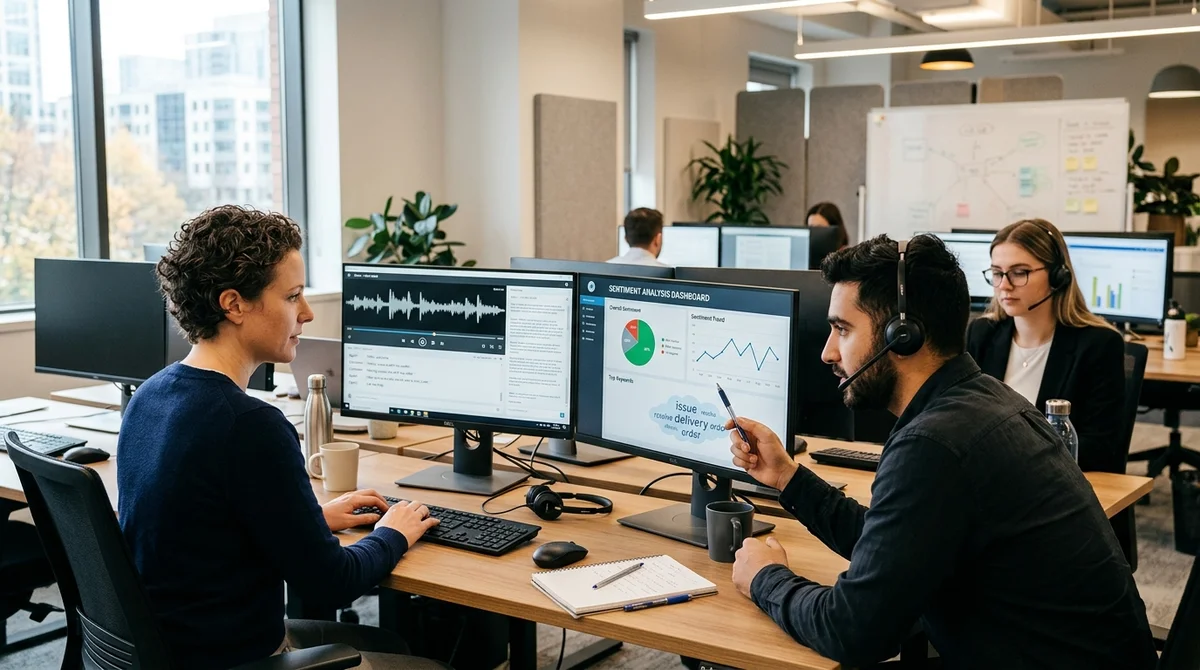
Le 17 avril 2026, KDnuggets a publié un décryptage pas à pas d'un outil open source d'analyse d'appels clients. Le projet assemble un pipeline local : Whisper transcrit l'audio, des modèles de Transformers détectent le sentiment et les émotions, et BERTopic repère les thèmes récurrents sans envoyer les enregistrements à des API externes.
Comment fonctionne la stack
L'article s'articule autour d'un schéma modulaire simple, reproductible sur une machine ordinaire. D'abord, Whisper convertit l'enregistrement de l'appel en texte et le découpe en segments horodatés. L'auteur utilise la version base ou small du modèle, un compromis entre vitesse et qualité.
Ensuite, la transcription est envoyée au modèle cardiffnlp/twitter-roberta-base-sentiment-latest, qui calcule les probabilités de positive, neutral et negative, puis produit une étiquette finale et un score compound allant de moins un à plus un. BERTopic regroupe alors les conversations par sens et en extrait les thèmes clés, comme les problèmes de facturation, de livraison ou de support technique.
L'auteur explique par ailleurs pourquoi le thème et le sentiment répondent à des questions différentes. Le sentiment dit si l'expérience a été bonne ou mauvaise, tandis que les émotions révèlent ce que ressent précisément le client : agacement, urgence, satisfaction. Pour les thèmes, l'outil combine sentence-transformers, UMAP, HDBSCAN et c-TF-IDF.
Un détail pratique important : l'extraction de thèmes ne fonctionne pas correctement sur un seul appel, mais sur un ensemble d'au moins cinq à dix transcriptions, où des motifs récurrents apparaissent déjà.
Pourquoi un déploiement local
L'idée centrale de l'article n'est pas de produire une énième démo de NLP, mais de présenter un scénario d'entreprise utile, sans dépendance aux API cloud. Pour les centres d'appels, tout se joue sur la confidentialité, le coût et les exigences de conservation des données. Après le premier téléchargement des modèles, qui pèse environ 1,5 Go, le système peut fonctionner hors ligne. Pour démarrer, il faut Python 3.9+, FFmpeg pour traiter l'audio et environ 2 Go d'espace disque : le ticket d'entrée est donc assez bas, même pour une petite équipe.
«
Le principal avantage, c'est que tout fonctionne en local et que les données sensibles des clients ne quittent pas votre machine. »
L'article y voit un argument qui touche non seulement la sécurité, mais aussi la prévisibilité des coûts. Pas de facturation à chaque appel d'API, pas de limites imposées par un fournisseur, et aucun risque de devoir confier un nouvel enregistrement client à une infrastructure externe.
L'auteur compare aussi les transformers à des méthodes plus anciennes fondées sur des dictionnaires, comme VADER : les modèles simples peuvent se tromper sur les phrases comportant une négation, alors qu'un transformer comprend mieux le contexte de la langue parlée, ce qui compte surtout pour les vraies réclamations et les formulations ambiguës.
Ce que montre le tableau de bord
La dernière couche du projet est une interface Streamlit avec des graphiques Plotly, destinée non à l'ingénieur ML, mais à un responsable ou un analyste. Elle permet de charger plusieurs fichiers mp3 ou wav, d'attendre le traitement et de consulter aussitôt une synthèse des appels. Pour gagner en rapidité, le projet met en cache les ressources afin que les modèles lourds ne se rechargent pas à chaque action dans l'interface.
Plusieurs modes de lancement sont prévus : une démo sans audio, l'analyse d'un seul fichier, le traitement par lots d'un répertoire et le tableau de bord complet dans le navigateur.
- Chargement de fichiers audio et traitement par lots
- Transcription avec mise en évidence du sentiment
- Chronologie des émotions pour les longues conversations
- Visualisation des thèmes et répartition des appels par clusters
- Accès direct à une conversation précise
En somme, c'est un socle prêt à l'emploi pour des services de support internes, l'analyse produit et le contrôle qualité des opérateurs. Une équipe peut récupérer le dépôt, changer les données d'entrée, affiner ou remplacer les modèles, et obtenir rapidement un outil opérationnel plutôt qu'un notebook abstrait. C'est ce qui fait la valeur de l'article : il ne débat pas de l'avenir des systèmes agentiques, mais présente un scénario concret et reproductible où une stack open source résout déjà un problème métier.
Ce que cela signifie
De telles publications montrent à quelle vitesse les outils d'IA passent de l'expérimentation à la pratique des équipes opérationnelles. Si l'analyse d'appels exigeait souvent un service SaaS et un traitement externe des données, il est désormais possible de bâtir un système de base en local, de façon transparente et sans gros budgets d'API.
- 1 nov. 2026Le juge d'EditAgent (Adobe) retient une retouche valable dans 81,3% des cas, contre 74,8% pour EditScore
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026La couche de protection MoneyGate n'a laissé passer aucune des 42 demandes frauduleuses adressées à des IA locales
- 1 nov. 2026Le tokenizer BERT de Hugging Face accéléré d'un facteur 50 en évitant le travail inutile sur l'ASCII
Questions clés sur cet article
Comment fonctionne la stack?
L'article s'articule autour d'un schéma modulaire simple, reproductible sur une machine ordinaire. D'abord, Whisper convertit l'enregistrement de l'appel en texte et le découpe en segments horodatés. L'auteur utilise la version base ou small du modèle, un compromis entre vitesse et qualité. Ensuite, la transcription est envoyée au modèle cardiffnlp/twitter-roberta-base-sentiment-latest, qui calcule les probabilités de positive, neutral et negative, puis produit une étiquette finale et un score compound allant de moins un à plus un. BERTopic regroupe alors les conversations
Pourquoi un déploiement local?
L'idée centrale de l'article n'est pas de produire une énième démo de NLP, mais de présenter un scénario d'entreprise utile, sans dépendance aux API cloud. Pour les centres d'appels, tout se joue sur la confidentialité, le coût et les exigences de conservation des données. Après le premier téléchargement des modèles, qui pèse environ 1,5 Go, le système peut fonctionner hors ligne. Pour démarrer, il faut Python 3.9+, FFmpeg pour traiter l'audio et environ 2 Go d'espace disque : le ticket d'entrée est donc assez bas, même pour une petite équipe. « Le principal avantage, c'est
Que sait-on sur Ce que montre le tableau de bord ?
La dernière couche du projet est une interface Streamlit avec des graphiques Plotly, destinée non à l'ingénieur ML, mais à un responsable ou un analyste. Elle permet de charger plusieurs fichiers mp3 ou wav, d'attendre le traitement et de consulter aussitôt une synthèse des appels. Pour gagner en rapidité, le projet met en cache les ressources afin que les modèles lourds ne se rechargent pas à chaque action dans l'interface. Plusieurs modes de lancement sont prévus : une démo sans audio, l'analyse d'un seul fichier, le traitement par lots d'un répertoire et le tableau de bo
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.