Comment BERTopic et un LLM local aident Rostelecom à analyser d'immenses corpus de textes
Un développeur NLP de Rostelecom a présenté un pipeline BERTopic qui automatise entièrement l'analyse de grands volumes de textes : avis, demandes au support, commentaires et réseaux sociaux. L'amélioration clé est un modèle de langage local intégré, qui génère des noms de thèmes interprétables sans envoyer de données vers le cloud, ce qui préserve la confidentialité. En pratique, la méthode ramène le travail manuel de plusieurs semaines à quelques heures.
Traité par IA depuis Habr AI ; édité par Hamidun News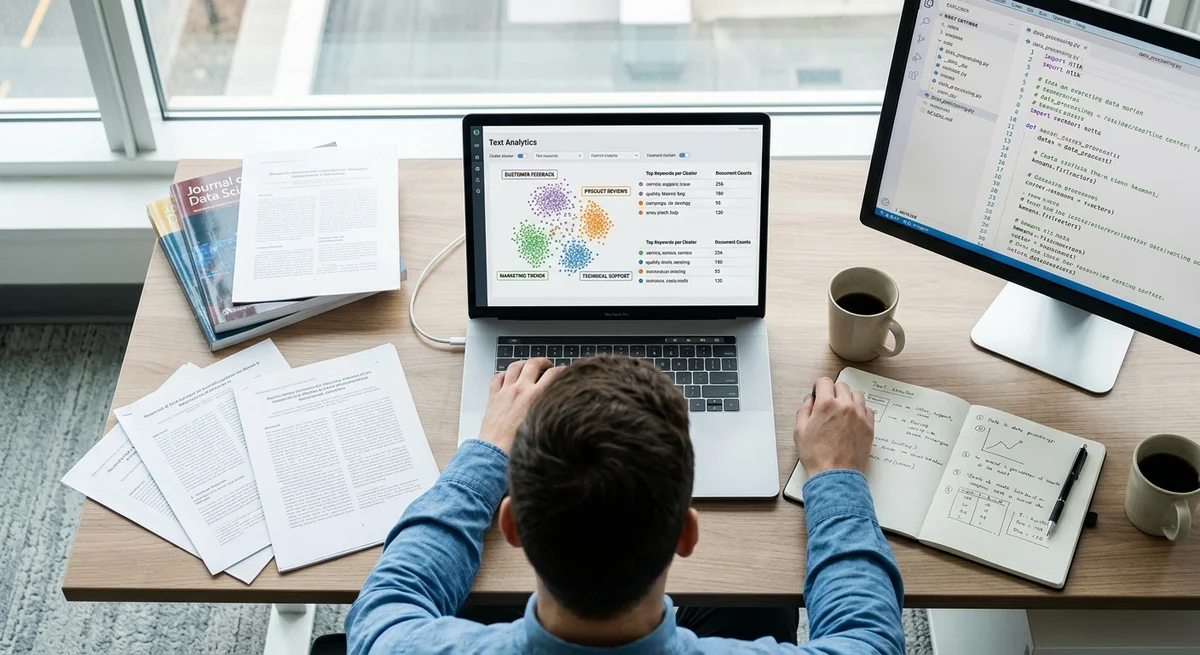
L'automatisation de l'analyse de textes est l'une des tâches les plus fastidieuses et les plus sous-estimées du NLP. Quand une entreprise reçoit des dizaines de milliers d'avis, de demandes au support ou de commentaires par jour, la catégorisation manuelle n'est pas seulement impossible, elle n'a aussi aucun sens du point de vue du ROI. Anton, ingénieur NLP chez Rostelecom, propose une solution : un pipeline fondé sur BERTopic avec un LLM local intégré pour obtenir des noms de thèmes interprétables.
Pourquoi automatiser l'analyse de textes
Pour n'importe quelle entreprise, les grands volumes de textes sont une mine d'or de données non structurées. Les avis recèlent des plaintes sur des bugs et des défauts précis, les demandes au support révèlent des problèmes systémiques et des points faibles, et les commentaires des réseaux sociaux contiennent des idées de nouvelles fonctionnalités et de nouveaux produits. Mais même une petite équipe d'analystes ne peut pas tout dépouiller à la main en un jour ni en une semaine.
L'approche classique consiste à lire chaque texte manuellement, à en saisir le sens et à le ranger dans une catégorie. À partir de 10 000 textes, cela devient économiquement non rentable, pénible pour le spécialiste et long. S'y ajoute la subjectivité : un analyste classe une plainte dans « problèmes de réseau », un autre dans « qualité du service », un troisième dans « divers ». La cohérence se perd et les conclusions deviennent peu fiables.
Comment BERTopic résout le problème du clustering
BERTopic est un framework qui combine plusieurs techniques d'apprentissage automatique pour détecter automatiquement des thèmes dans les textes. Le processus fonctionne ainsi :
- Embeddings (BERT) : chaque texte est converti en un vecteur de nombres (embedding), où les textes sémantiquement proches se retrouvent côte à côte dans un espace multidimensionnel. Pour le russe, on peut utiliser ruBERT ou d'autres modèles.
- Clustering (HDBSCAN) : un algorithme rapide repère les regroupements naturels de textes dans cet espace, sans qu'il soit nécessaire de connaître le nombre de thèmes à l'avance.
- Interprétation : BERTopic génère le nom de chaque cluster à partir de TF-IDF, c'est-à-dire des mots les plus significatifs du groupe.
Le résultat ? Du chaos de 50 000 textes émergent, par exemple, 15 thèmes nets et naturels : « problèmes d'internet », « questions de facturation », « bugs de l'application mobile », « demandes d'avantages », etc.
Mais il y a un hic. L'interprétation standard de BERTopic produit souvent des noms étranges comme « абонент_услуга_номер » ou « бага_баг_ошибка » (en gros « abonné_service_numéro » et « défaut_bug_erreur »), difficiles à expliquer au métier. C'est là qu'intervient le modèle de langage.
Intégrer un LLM local pour l'interprétation
Au lieu de sélectionner mécaniquement des mots du cluster, un modèle de langage local (par exemple Mistral 7B ou Llama 2) lit les mots les plus importants et les documents les plus représentatifs du cluster, puis génère une description complète en russe : « Les clients se plaignent de la lenteur d'internet en zone rurale, surtout le week-end ».
« Intégrer un LLM local protège la confidentialité des données : toutes les données courantes restent dans l'entreprise, sans envoi à OpenAI, à l'API Claude ou à d'autres services cloud.
C'est critique pour les entreprises qui manipulent des informations sensibles », souligne Anton.
Par ailleurs, le modèle local est plus rapide que les requêtes d'API et totalement indépendant des quotas, des limites et du coût par token traité. Le pipeline fonctionne sans internet, ce qui réduit la latence et renforce la fiabilité du système.
Résultat pratique et passage à l'échelle
Le pipeline de Rostelecom permet de réaliser en quelques heures ce qui prenait auparavant plusieurs semaines de travail manuel :
1. Charger un ensemble de textes dans BERTopic (des milliers, voire des dizaines de milliers d'enregistrements) 2. Obtenir des clusters prêts à l'emploi, avec des descriptions de thèmes générées par le LLM dans un langage compréhensible par le métier 3. Exporter les résultats vers Excel, CSV ou une base de données pour que les analystes et les product managers poursuivent le travail
Il est aussi réutilisable : un nouveau lot est arrivé au support ? Le pipeline se réentraîne en quelques minutes et fournit de nouveau un résultat structuré.
Ce que cela signifie pour l'industrie du NLP
Les outils de NLP quittent le laboratoire et les articles scientifiques pour entrer en production réelle. Quand un seul ingénieur peut assembler en une journée un pipeline complet qui exigeait auparavant deux à trois semaines de travail manuel et l'expertise d'une équipe entière, le NLP devient un outil pratique, et non plus une expérience scientifique réservée aux grandes entreprises informatiques.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Pourquoi automatiser l'analyse de textes?
Pour n'importe quelle entreprise, les grands volumes de textes sont une mine d'or de données non structurées. Les avis recèlent des plaintes sur des bugs et des défauts précis, les demandes au support révèlent des problèmes systémiques et des points faibles, et les commentaires des réseaux sociaux contiennent des idées de nouvelles fonctionnalités et de nouveaux produits. Mais même une petite équipe d'analystes ne peut pas tout dépouiller à la main en un jour ni en une semaine. L'approche classique consiste à lire chaque texte manuellement, à en saisir le sens et à le range
Comment BERTopic résout le problème du clustering?
BERTopic est un framework qui combine plusieurs techniques d'apprentissage automatique pour détecter automatiquement des thèmes dans les textes. Le processus fonctionne ainsi : Embeddings (BERT) : chaque texte est converti en un vecteur de nombres (embedding), où les textes sémantiquement proches se retrouvent côte à côte dans un espace multidimensionnel. Pour le russe, on peut utiliser ruBERT ou d'autres modèles. Clustering (HDBSCAN) : un algorithme rapide repère les regroupements naturels de textes dans cet espace, sans qu'il soit nécessaire de connaître le nombre de thèm
Que sait-on sur Intégrer un LLM local pour l'interprétation ?
Au lieu de sélectionner mécaniquement des mots du cluster, un modèle de langage local (par exemple Mistral 7B ou Llama 2) lit les mots les plus importants et les documents les plus représentatifs du cluster, puis génère une description complète en russe : « Les clients se plaignent de la lenteur d'internet en zone rurale, surtout le week-end ». « Intégrer un LLM local protège la confidentialité des données : toutes les données courantes restent dans l'entreprise, sans envoi à OpenAI, à l'API Claude ou à d'autres services cloud. C'est critique pour les entreprises qui manipu
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.