Une pile open source de 6 modèles et 9 agents montre comment monter une équipe d'IA sur un seul serveur
Un serveur GPU, six modèles open source et neuf agents : voilà de quoi est faite une équipe d'IA autonome qui conçoit, écrit, teste et déploie elle-même de nouveaux agents. Plutôt qu'un modèle universel, les rôles sont répartis selon les points forts : raisonnement pour l'orchestrateur, génération de code pour le constructeur, usage d'outils pour le critique. L'économie principale vient du partage d'instances : 9 agents tournent avec seulement 3 à 4 modèles. L'auteur décrit aussi trois options de déploiement, d'une RTX 4090 à un cluster de A100.
Traité par IA depuis Habr AI ; édité par Hamidun News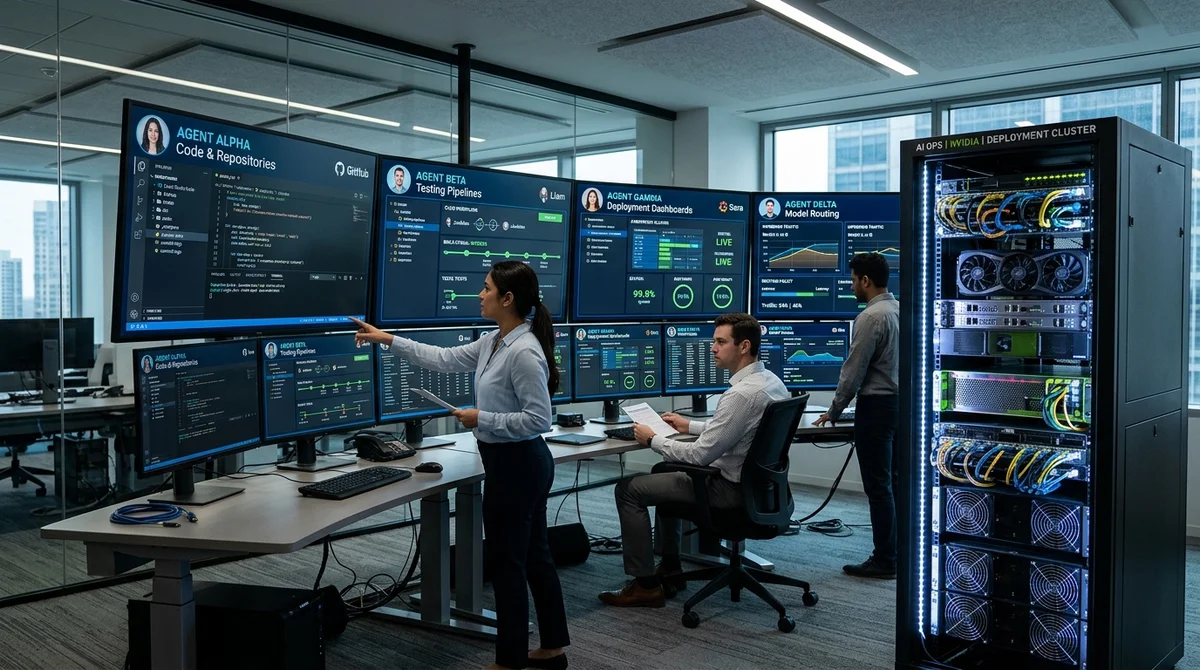
Une équipe autonome de neuf agents d'IA peut concevoir, écrire, tester et déployer de nouveaux agents sans intervention humaine. Elle ne nécessite pas un ensemble d'API fermées : le schéma repose sur six modèles open source et, dans sa version de base, tient sur un seul serveur GPU.
Comment l'équipe est organisée
Au lieu d'un modèle « universel » unique, l'auteur a bâti une chaîne de neuf rôles. Certains agents s'occupent de la définition de la tâche et de l'architecture ; d'autres, de l'écriture du code, du contrôle qualité, des tests et de la mise en production. Le résultat n'est pas un gros assistant, mais une petite organisation d'ingénierie où chaque membre accomplit une portion étroite du travail.
Cette approche limite le chaos : l'agent n'a pas à planifier le système, écrire des modules, lancer des tests et évaluer ses propres erreurs en même temps. L'idée centrale est que l'autonomie ne vient pas de la magie, mais du découpage du processus en étapes. Si l'agent ne comprend que son périmètre et reçoit en entrée une tâche déjà structurée, les exigences envers le modèle deviennent plus claires. L'orchestrateur doit savoir raisonner et garder le contexte, le constructeur doit générer du code de façon stable, et le critique doit repérer les problèmes dans l'usage des outils et les scénarios d'exécution. Le gain ne vient donc pas d'un supermodèle, mais de l'assemblage précis des rôles dans un pipeline opérationnel.
Rôles et benchmarks
L'auteur rejette explicitement l'idée d'un « meilleur modèle en général ». Les rôles sont choisis d'après ce que confirment les benchmarks. Pour l'orchestrateur, le raisonnement compte : la référence est un score GPQA de 88,4 %. Pour le constructeur, la génération de code est critique, et c'est HumanEval qui sert de repère, avec 92,7 %. Pour le critique, la compréhension de l'usage des outils et du comportement des agents dans les tâches prime ; on retient donc tau-bench, avec un résultat de 87,4 %. C'est cette spécialisation qui explique l'emploi de six modèles open source différents plutôt que d'un modèle de classe GPT pour tous les cas.
- Orchestrateur : raisonnement solide, priorisation et décomposition des tâches
- Constructeur : génération de code et traitement rapide des modifications d'ingénierie
- Critique : vérification de l'usage des outils, de la qualité des solutions et des points faibles du pipeline
- Autres rôles : tests, déploiement et étapes de service, où l'on peut réutiliser des instances partagées
Neuf agents ne signifient pas neuf modèles complets en mémoire simultanément. Une astuce pratique est le partage d'instances : plusieurs rôles se servent du même modèle si leurs charges et profils de tâches sont proches. Ainsi, un système de neuf agents peut fonctionner avec seulement trois ou quatre instances de modèle. Cela réduit fortement la consommation de VRAM, simplifie la maintenance et rapproche l'architecture de la production réelle, plutôt que d'une démonstration à budget illimité.
Matériel et lancement
Le volet infrastructure mérite une attention particulière. L'auteur décrit trois configurations de déploiement : d'une seule RTX 4090 avec 24 Go de mémoire à un cluster de A100 totalisant 211 Go. Entre ces extrêmes, on peut choisir l'équilibre entre vitesse, qualité et parallélisme. Pour réduire les coûts, on recourt à la quantification, à une infrastructure d'inférence soignée et à un tableau de bord interactif qui aide à suivre les rôles, la charge et l'avancement des tâches. Autrement dit, il ne s'agit pas seulement de choisir des modèles, mais aussi de leur offrir un véritable environnement d'exploitation.
La conclusion pratique est simple : l'IA agentique open source cesse d'être un jouet de laboratoire. Si ces schémas étaient jusqu'ici associés soit à des API coûteuses, soit à des clusters lourds, celui-ci montre une voie de démarrage plus terre à terre. Une petite équipe peut commencer avec un serveur, vérifier la viabilité du pipeline, puis le faire monter en charge à mesure que les tâches augmentent. Le coût ressemble désormais à un choix d'ingénierie, et non à une barrière qui écarte d'emblée la plupart des équipes.
Ce que cela signifie
Le marché s'éloigne de l'idée d'un modèle « magique » pour aller vers des systèmes orientés rôles, où la bonne composition compte plus qu'un nom retentissant dans une API. Pour les entreprises, c'est un signal : on peut dès maintenant assembler des équipes d'IA autonomes à partir de composants open source, à condition de les traiter comme une infrastructure et un processus, et non comme une simple fenêtre de chat.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026TensorFold 1.2.0 augmente de 44,2% le débit de Qwen3.8-27B sur M3 Ultra à 16 flux
- 1 nov. 2026Le juge d'EditAgent (Adobe) retient une retouche valable dans 81,3% des cas, contre 74,8% pour EditScore
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
Questions clés sur cet article
Comment l'équipe est organisée?
Au lieu d'un modèle « universel » unique, l'auteur a bâti une chaîne de neuf rôles. Certains agents s'occupent de la définition de la tâche et de l'architecture ; d'autres, de l'écriture du code, du contrôle qualité, des tests et de la mise en production. Le résultat n'est pas un gros assistant, mais une petite organisation d'ingénierie où chaque membre accomplit une portion étroite du travail. Cette approche limite le chaos : l'agent n'a pas à planifier le système, écrire des modules, lancer des tests et évaluer ses propres erreurs en même temps. L'idée centrale est que l'
Que sait-on sur Rôles et benchmarks ?
L'auteur rejette explicitement l'idée d'un « meilleur modèle en général ». Les rôles sont choisis d'après ce que confirment les benchmarks. Pour l'orchestrateur, le raisonnement compte : la référence est un score GPQA de 88,4 %. Pour le constructeur, la génération de code est critique, et c'est HumanEval qui sert de repère, avec 92,7 %. Pour le critique, la compréhension de l'usage des outils et du comportement des agents dans les tâches prime ; on retient donc tau-bench, avec un résultat de 87,4 %. C'est cette spécialisation qui explique l'emploi de six modèles open source
Que sait-on sur Matériel et lancement ?
Le volet infrastructure mérite une attention particulière. L'auteur décrit trois configurations de déploiement : d'une seule RTX 4090 avec 24 Go de mémoire à un cluster de A100 totalisant 211 Go. Entre ces extrêmes, on peut choisir l'équilibre entre vitesse, qualité et parallélisme. Pour réduire les coûts, on recourt à la quantification, à une infrastructure d'inférence soignée et à un tableau de bord interactif qui aide à suivre les rôles, la charge et l'avancement des tâches. Autrement dit, il ne s'agit pas seulement de choisir des modèles, mais aussi de leur offrir un vé
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.