Les LLM dans le développement : les 4 approches des équipes et ce qui les distingue
Les LLM dans le développement ne forment plus un scénario unique, mais quatre modes de travail distincts. Tout dépend de deux choses : la quantité de code que l'équipe délègue réellement au modèle, et la manière dont elle vérifie ensuite le résultat, à l'œil ou via des tests, des types et des spécifications. C'est cette combinaison qui détermine si l'IA accélère un produit ou génère des bugs coûteux.
Traité par IA depuis Habr AI ; édité par Hamidun News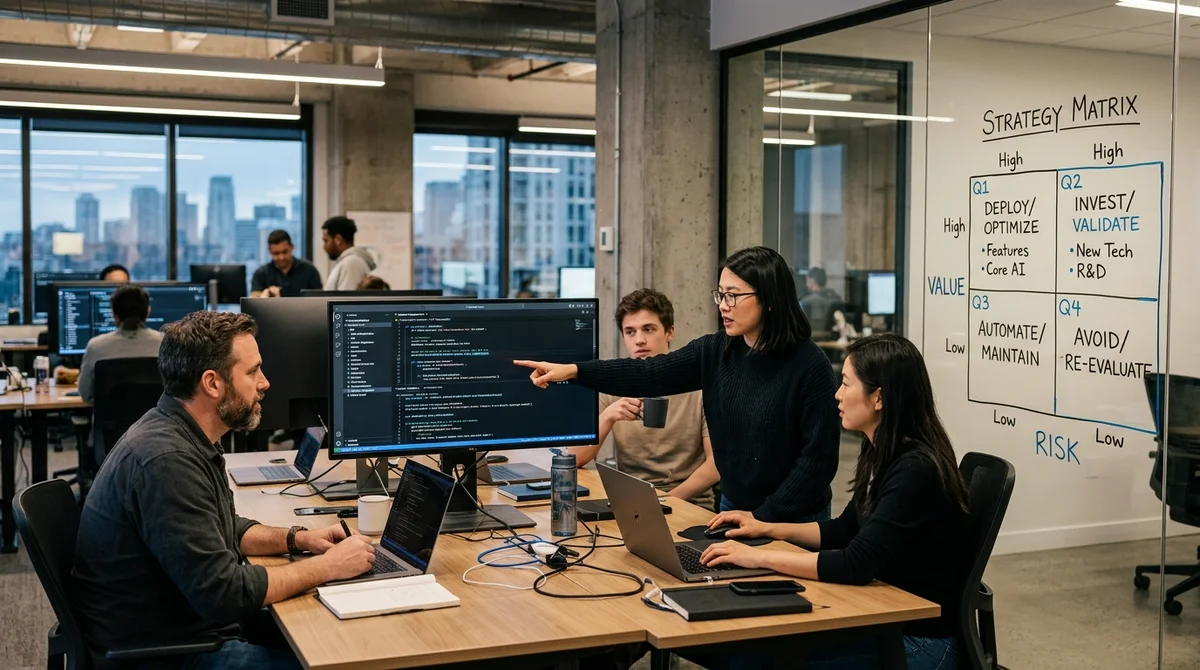
Les LLM ne sont plus un simple outil d'autocomplétion intelligent : ils sont devenus un véritable outil de développement. Mais l'expression « coder avec l'IA » recouvre des pratiques très différentes, des suggestions ponctuelles jusqu'à la délégation quasi totale du code au modèle.
Les deux axes principaux
Pour ne pas ranger ces scénarios dans une seule catégorie, il est utile de regarder deux paramètres. Le premier : l'implication de la personne dans le code lui-même. L'écrit-elle à la main, le lit-elle, le corrige-t-elle et le relit-elle, ou confie-t-elle surtout la tâche au modèle pour recevoir des fragments ou des modules entiers ? Le second : la façon dont l'équipe vérifie le résultat, au feeling et en cliquant à la main, ou via des mécanismes formels comme les tests, les types et les spécifications.
À l'intersection de ces axes se dessine une matrice 2×2 simple. Elle est utile parce qu'elle écarte le faux débat sur le caractère « bon » ou « mauvais » de l'usage de l'IA en développement. En pratique, la question n'est pas idéologique, mais celle du mode de travail. Un même outil peut être un accélérateur sûr dans un processus et une source de chaos dans un autre, si l'équipe ne sait pas qui répond du code ni ce qui atteste de sa justesse.
Quatre modes de travail
De ce schéma découlent quatre approches pratiques, et chacune paraît normale à sa façon pour une équipe. Elles diffèrent non seulement par le degré de confiance accordé au modèle, mais aussi par la discipline d'ingénierie requise après la génération. Dans certains cas, le LLM reste un assistant commode aux côtés du développeur ; dans d'autres, il devient un exécutant presque autonome. C'est ce qui explique que les débats sur l'utilité de l'IA passent souvent à côté du sujet : on compare des processus qui ne sont pas les mêmes.
- Code manuel + vérification informelle. Le développeur écrit l'essentiel lui-même, et le LLM aide pour l'autocomplétion, le refactoring et les petits morceaux. La vérification consiste en un lancement rapide et un examen visuel.
- Code manuel + vérification formelle. L'IA reste un assistant, mais chaque modification passe par les tests, le typage, les linters et la revue de code. C'est le mode le plus prévisible pour une équipe produit.
- Code délégué + vérification informelle. On confie au modèle des fonctions, des pages ou des services entiers, et l'humain regarde si « ça a l'air de marcher ». La vitesse est élevée, mais le risque de défauts cachés l'est encore plus.
- Code délégué + vérification formelle. L'option la plus ambitieuse : le LLM génère de grandes parties du système, et la qualité repose sur une bonne batterie de tests, des contrats et des contraintes strictes de l'environnement.
La principale différence entre ces modes n'est pas le volume de texte généré, mais le coût de l'erreur et la rapidité avec laquelle on la détecte. Tant que le modèle aide sur des points locaux, l'humain parvient généralement à repérer les anomalies en lisant le code. Mais quand on lui confie de gros blocs de responsabilité, sans validation formelle le projet accumule vite des bugs, de la logique dupliquée et des dépendances peu évidentes. Plus l'autonomie du modèle est grande, plus la vérification superficielle coûte cher.
Pourquoi le choix compte
Beaucoup d'équipes confondent la vitesse du premier résultat avec la vitesse du développement dans son ensemble. La vérification informelle donne bien une impression d'avancer : l'écran s'ouvre, le bouton répond, donc tout est prêt. Mais cette approche détecte mal les régressions, les cas limites et les erreurs d'architecture. Cela se voit surtout quand le LLM écrit avec assurance du code dans un style inhabituel pour l'équipe, ou ajoute des solutions d'apparence plausible qui s'écartent des règles internes du projet.
D'où la conclusion pratique : plus on avance vers la délégation, plus la couche de vérification automatique doit être solide. Sans elle, l'IA ne réduit pas le travail, elle le déplace dans le temps : les problèmes émergent plus tard, quand le code est déjà intégré au produit. Si les tests, les types et les spécifications sont bien en place, on peut utiliser le modèle bien plus hardiment : pas seulement pour des suggestions, mais pour des implémentations préliminaires de tâches entières.
Ce que cela signifie
Il n'existe pas de manière universelle de « coder avec un LLM ». Plutôt que de débattre de la magie de l'IA, les équipes ont intérêt à choisir honnêtement leur mode : où l'humain doit lire et corriger le code et où l'on peut déléguer, ce qui compte comme une vérification suffisante et ce qui n'en est pas une. C'est cette combinaison, et non le volume des promesses, qui décide si le LLM sera un accélérateur de développement ou une fabrique d'erreurs coûteuses.
Questions clés sur cet article
Que sait-on sur Les deux axes principaux ?
Pour ne pas ranger ces scénarios dans une seule catégorie, il est utile de regarder deux paramètres. Le premier : l'implication de la personne dans le code lui-même. L'écrit-elle à la main, le lit-elle, le corrige-t-elle et le relit-elle, ou confie-t-elle surtout la tâche au modèle pour recevoir des fragments ou des modules entiers ? Le second : la façon dont l'équipe vérifie le résultat, au feeling et en cliquant à la main, ou via des mécanismes formels comme les tests, les types et les spécifications. À l'intersection de ces axes se dessine une matrice 2×2 simple. Elle es
Que sait-on sur Quatre modes de travail ?
De ce schéma découlent quatre approches pratiques, et chacune paraît normale à sa façon pour une équipe. Elles diffèrent non seulement par le degré de confiance accordé au modèle, mais aussi par la discipline d'ingénierie requise après la génération. Dans certains cas, le LLM reste un assistant commode aux côtés du développeur ; dans d'autres, il devient un exécutant presque autonome. C'est ce qui explique que les débats sur l'utilité de l'IA passent souvent à côté du sujet : on compare des processus qui ne sont pas les mêmes. Code manuel + vérification informelle. Le dével
Pourquoi le choix compte?
Beaucoup d'équipes confondent la vitesse du premier résultat avec la vitesse du développement dans son ensemble. La vérification informelle donne bien une impression d'avancer : l'écran s'ouvre, le bouton répond, donc tout est prêt. Mais cette approche détecte mal les régressions, les cas limites et les erreurs d'architecture. Cela se voit surtout quand le LLM écrit avec assurance du code dans un style inhabituel pour l'équipe, ou ajoute des solutions d'apparence plausible qui s'écartent des règles internes du projet. D'où la conclusion pratique : plus on avance vers la dél
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.