Habr AI montre comment une architecture de réflexes pour agents LLM supprime la latence jusqu'à 60 fps
Habr AI montre comment résoudre le principal problème des agents IA dans les jeux, les assistants et la robotique : une latence de 1 à 3 secondes. L'équipe a scindé le système en deux : une boucle réflexe rapide et une boucle LLM plus lente, dédiée au reasoning. Résultat : l'agent peut réagir en quelques millisecondes, modifier son comportement à la volée et apprendre en cours de session. Il préserve aussi l'impression d'une interaction vivante, même dans une scène dynamique.
Traité par IA depuis Habr AI ; édité par Hamidun News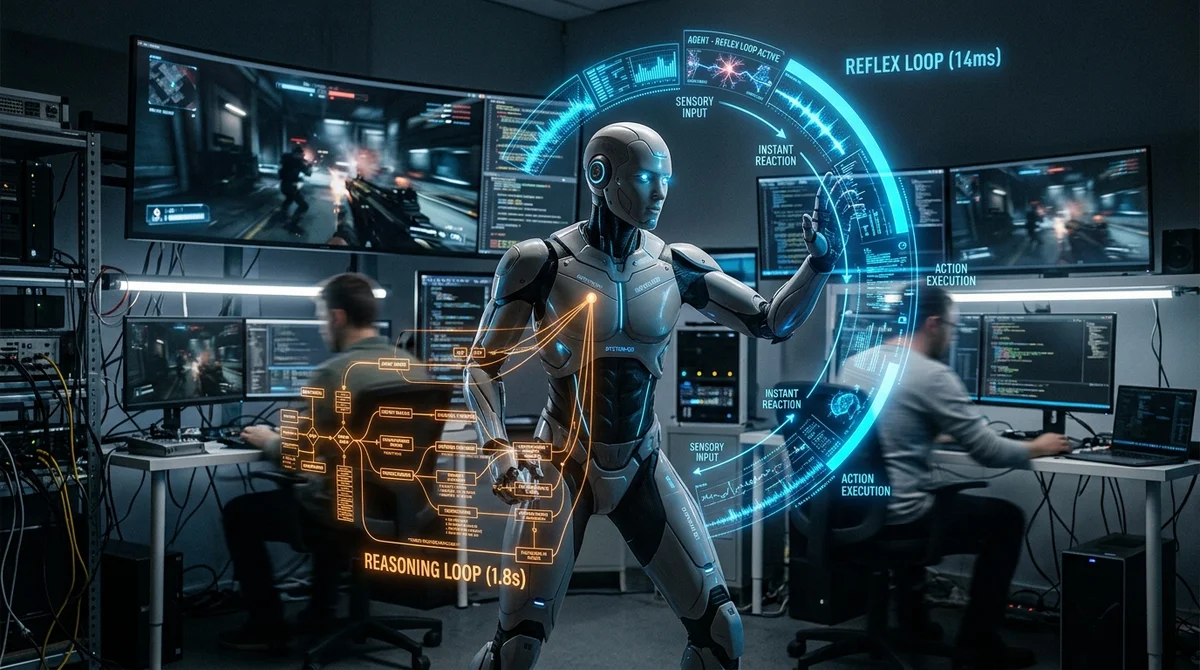
Habr AI a publié l'analyse d'une architecture qui dote les agents LLM d'une « moelle épinière » : une couche de réflexes rapides placée au-dessus d'un reasoning plus lent. Le but est d'éliminer la pause habituelle de 1 à 3 secondes et de faire réagir les PNJ de jeux vidéo, les assistants vocaux et les robots de manière quasi instantanée.
Où la vitesse décroche
Tous ceux qui ont tenté d'intégrer un grand modèle de langage dans un environnement interactif connaissent le problème. L'agent doit recevoir l'audio, assembler le contexte, envoyer la requête, attendre la réponse du modèle, puis la convertir en animation ou en action. Tout cela prend beaucoup trop de temps. Dans un chat, ce délai reste tolérable. Dans un jeu, un robot ou une interface vivante, c'est un échec d'UX : l'utilisateur ne perçoit pas de l'intelligence, mais un blocage. C'est pourquoi même un modèle puissant donne souvent l'impression d'être « intelligent, mais lent ».
Les auteurs comparent ce type d'intégration au fait de monter un moteur de navette spatiale sur une charrette : la puissance de calcul est là, mais elle ne se traduit pas en comportement réel. Avec leur prototype, l'attention du public s'est portée sur l'habillage visuel plutôt que sur le moteur lui-même. Au lieu de discuter de l'inférence, l'équipe a reçu des critiques sur la sortie de débogage brute et la qualité des images. Le débat a donc porté sur le rendu, alors que la vraie nouvelle était ailleurs : le système tentait déjà de tenir le rythme du temps réel.
« Trop tôt pour montrer des "vrais 60 FPS".
Ce n'est qu'un kaléidoscope d'images désordonnées, du flou et des doigts tordus. »
Système 1 et 2
La solution est une Dual-Process Architecture, qui sépare l'agent en une boucle rapide et une boucle lente. La première couche fonctionne comme un système réflexe : elle surveille les événements et déclenche des réactions immédiates, sans attendre la fin du raisonnement du modèle. La seconde couche reste confiée au LLM, qui prend en charge les tâches plus coûteuses : interpréter un contexte complexe, planifier, choisir les répliques, réorganiser le comportement. L'agent peut ainsi réagir d'abord, puis « réfléchir » ensuite, comme le fait un humain dans le monde réel.
Dans cette approche, l'essentiel est de ne pas faire du LLM le seul centre d'exécution. Le reasoning lent excelle quand il faut de la profondeur, mais convient mal aux mouvements, aux micro-gestes, aux rotations rapides de caméra, aux réactions aux collisions ou aux réponses vocales courtes. L'architecture à deux vitesses lève ce conflit : l'interface et le corps de l'agent vivent à l'échelle de la milliseconde, tandis que le sens et la stratégie relèvent d'un cycle plus long. C'est ce découplage qui permet de ne pas perdre d'images et de ne pas faire attendre l'utilisateur à chaque geste ou réplique.
Selon les auteurs, ce schéma offre aussi deux avantages difficiles à obtenir dans un pipeline monolithique : la personnalité peut être modifiée à la volée, et de nouveaux schémas de comportement peuvent être intégrés en cours de fonctionnement. C'est particulièrement important pour les PNJ, les assistants et la robotique, où l'agent ne doit pas seulement répondre, mais s'adapter en continu à son environnement. Dans un schéma classique, ces changements exigent une nouvelle requête au modèle et se heurtent de nouveau à la latence.
L'effet pratique de l'approche
Sortir les réflexes de la lourde boucle LLM ne change pas seulement la latence, mais aussi la sensation de « vie » du système. L'utilisateur n'attend plus que l'intelligence termine un passage complet dans la chaîne : il voit un comportement continu. Pour les équipes produit, c'est un changement important : la qualité d'un agent ne se juge plus à la beauté d'une image de démo, mais à sa capacité à tenir naturellement le rythme de l'interaction. Dans un produit interactif, cela compte souvent davantage qu'un texte parfait, car le sentiment de présence se brise avant même que l'utilisateur ait pu apprécier la profondeur de la réponse.
- Réactions instantanées aux événements, aux sons, aux obstacles et aux commandes
- Articulation fluide entre génération, animation et contrôle
- Changement rapide de rôle, de caractère ou de style de réponse
- Apprentissage et ajustement du comportement sans redémarrage complet de l'agent
En substance, l'équipe propose de voir le LLM non comme le cerveau unique du système, mais comme l'une de ses couches. Cela change la perspective d'ingénierie : au lieu de lutter sans fin contre la latence réseau et une inférence lourde, on peut concevoir un moteur dédié au temps réel. Certes, la visualisation du prototype peut être brute. Mais si la couche réflexe tient déjà la cadence, le polissage des graphismes, des mains et des images peut attendre l'itération suivante.
Ce que cela signifie
Cette histoire illustre bien la direction prise par les agents IA : des systèmes hybrides, où les réflexes rapides sont séparés du reasoning lent. Pour ceux qui développent des jeux, des assistants vocaux ou de l'embodied AI, c'est une étape presque obligatoire : sans elle, même le meilleur LLM paraîtra lent et maladroit.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Microsoft publie Mage-VL-Cowork, un modèle de 4B qui résout 66,0% des tâches d'OSWorld-Verified
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
Questions clés sur cet article
Que sait-on sur Où la vitesse décroche ?
Tous ceux qui ont tenté d'intégrer un grand modèle de langage dans un environnement interactif connaissent le problème. L'agent doit recevoir l'audio, assembler le contexte, envoyer la requête, attendre la réponse du modèle, puis la convertir en animation ou en action. Tout cela prend beaucoup trop de temps. Dans un chat, ce délai reste tolérable. Dans un jeu, un robot ou une interface vivante, c'est un échec d'UX : l'utilisateur ne perçoit pas de l'intelligence, mais un blocage. C'est pourquoi même un modèle puissant donne souvent l'impression d'être « intelligent, mais le
Que sait-on sur Système 1 et 2 ?
La solution est une Dual-Process Architecture, qui sépare l'agent en une boucle rapide et une boucle lente. La première couche fonctionne comme un système réflexe : elle surveille les événements et déclenche des réactions immédiates, sans attendre la fin du raisonnement du modèle. La seconde couche reste confiée au LLM, qui prend en charge les tâches plus coûteuses : interpréter un contexte complexe, planifier, choisir les répliques, réorganiser le comportement. L'agent peut ainsi réagir d'abord, puis « réfléchir » ensuite, comme le fait un humain dans le monde réel. Dans c
Que sait-on sur L'effet pratique de l'approche ?
Sortir les réflexes de la lourde boucle LLM ne change pas seulement la latence, mais aussi la sensation de « vie » du système. L'utilisateur n'attend plus que l'intelligence termine un passage complet dans la chaîne : il voit un comportement continu. Pour les équipes produit, c'est un changement important : la qualité d'un agent ne se juge plus à la beauté d'une image de démo, mais à sa capacité à tenir naturellement le rythme de l'interaction. Dans un produit interactif, cela compte souvent davantage qu'un texte parfait, car le sentiment de présence se brise avant même que
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.