AWS détaille le lancement du reinforcement fine-tuning sur Amazon Bedrock via des API compatibles OpenAI
AWS a publié une analyse technique du reinforcement fine-tuning sur Amazon Bedrock via des API compatibles OpenAI. Le scénario : configurer une clé Bedrock et `OPENAI_BASE_URL`, charger un jeu de données JSONL, déployer une fonction de récompense dans Lambda et lancer l'entraînement. Dans l'exemple, le job parcourt 67 étapes. Une fois terminé, le modèle affiné peut être appelé immédiatement via Chat Completions ou la Responses API, sans endpoint, déploiement ni hébergement distincts.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News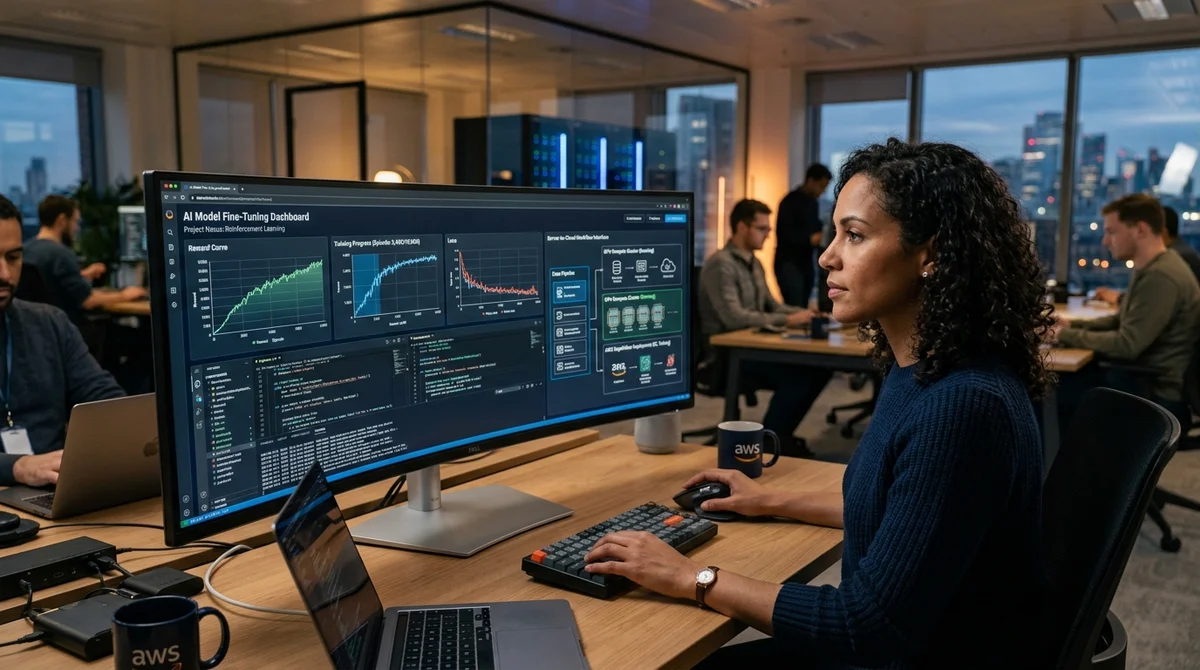
AWS a publié un guide détaillé pour lancer du reinforcement fine-tuning sur Amazon Bedrock via des API compatibles OpenAI. En substance, l'entreprise propose un parcours familier aux développeurs : le même SDK OpenAI, mais avec Bedrock comme plateforme d'entraînement, d'évaluation et d'inférence.
Comment fonctionne le processus
Le reinforcement fine-tuning (RFT) s'utilise lorsque montrer au modèle les bonnes réponses, comme dans le supervised fine-tuning classique, ne suffit pas. Ici, le modèle génère plusieurs réponses à un même prompt, puis une fonction de récompense distincte attribue à chacune une note numérique. Amazon Bedrock exploite ce signal et exécute lui-même la boucle d'optimisation avec l'algorithme GRPO. Pour une équipe, cela signifie qu'il n'est pas nécessaire de monter une lourde infrastructure de reinforcement learning : le service prend en charge l'orchestration, le parallélisme, les checkpoints et les métriques.
Dans le walkthrough pratique, AWS montre qu'elle a rendu le point d'entrée aussi proche que possible de la pile OpenAI habituelle. Le développeur n'a qu'à pointer `OPENAI_BASE_URL` vers l'endpoint régional Bedrock Mantle et à fournir l'`OPENAI_API_KEY` générée pour Bedrock. Il peut ensuite utiliser les mêmes appels : `client.files.create()`, `client.fine_tuning.jobs.create()` et `client.chat.completions.create()`. Autrement dit, l'obstacle n'est pas un nouveau SDK, mais la qualité avec laquelle on a formalisé le critère de qualité de la réponse.
Données et fonction de récompense
Dans son exemple, AWS utilise le jeu de données GSM8K, composé de problèmes de mathématiques de niveau primaire. Les données sont chargées via la Files API au format JSONL : chaque ligne contient un bloc `messages` et, pour les tâches vérifiables, un `reference_answer`. Ce format permet non seulement d'envoyer la question au modèle, mais aussi de conserver une réponse de référence ou une règle de vérification. Le walkthrough montre aussi que le prompt peut être structuré à l'avance pour que la réponse finale soit facile à extraire automatiquement, par exemple dans un format spécial comme `\boxed{}` ou après un marqueur `####`.
Le maillon clé de tout le dispositif est la fonction de récompense dans AWS Lambda. Dans la démonstration, elle reçoit les trajectoires, repère la dernière réponse de l'assistant, extrait la bonne réponse de `reference_answer` et renvoie un score de 0 à 1. Pour les mathématiques, il s'agit d'une simple vérification binaire, mais la logique ne se limite pas à ces cas. AWS souligne qu'on peut intégrer ses propres règles dans Lambda et, pour les tâches moins formalisables, recourir à une approche de model-as-a-judge. Un point important pour les entreprises : pendant le processus, les données ne quittent pas l'environnement protégé d'AWS et ne servent pas à entraîner les modèles de Bedrock.
Entraînement et lancement
Le lancement de l'entraînement est assez compact : `fine_tuning.jobs.create()` reçoit le modèle de base, le fichier d'entraînement, le type de méthode `reinforcement`, l'ARN de l'évaluateur Lambda et un ensemble d'hyperparamètres. L'exemple utilise `openai.gpt-oss-20b`, une époque, `batch_size=4` et `learning_rate_multiplier=1.0`, même si la documentation recommande, par souci de stabilité, de commencer avec une valeur inférieure à un. Bedrock crée ensuite le job, compte les étapes et enregistre des checkpoints intermédiaires, utilisables pour évaluer la qualité avant la fin de l'entraînement.
Pendant l'entraînement, AWS conseille de surveiller non seulement le statut du job, mais aussi les événements accompagnés de métriques. Dans l'exemple, le job sur un sous-ensemble de GSM8K parcourt 67 étapes, et la courbe de récompense passe d'environ 0.56 à une plage de 0.85–0.97 dès le milieu de l'entraînement. Parallèlement, les réponses raccourcissent, ce que les auteurs interprètent comme le signe que le modèle a appris à résoudre les problèmes plus précisément et sans bavardage inutile.
- `critic_rewards_mean` : le signal principal ; s'il augmente, le modèle apprend
- `actor_entropy` : indique si la diversité des réponses s'effondre en mode collapse
- `actor_grad_norm` : aide à repérer une instabilité lorsque les gradients se mettent à fluctuer brutalement
- `response_length_mean` : utile contre le reward hacking, lorsque le modèle se met à gonfler ses réponses pour obtenir une meilleure note
Une fois le job terminé, il n'est pas nécessaire de déployer le modèle séparément. Il suffit de récupérer `fine_tuned_model` dans les détails de la tâche et de l'appeler aussitôt via la Chat Completions API ou la Responses API, y compris en streaming. C'est le principal avantage pratique du dispositif : l'entraînement et l'inférence restent dans un même paysage d'API. La documentation de Bedrock précise par ailleurs que la voie compatible OpenAI pour le fine-tuning est pour l'instant disponible pour `openai.gpt-oss-20b` et `qwen.qwen3-32b` dans la région `us-west-2`.
« Aucun endpoint ni hébergement distinct ».
Ce que cela signifie
AWS cherche clairement à faire du reinforcement fine-tuning non plus une curiosité de recherche, mais un outil d'ingénierie ordinaire. Si une équipe dispose déjà de code pour le SDK OpenAI et d'une logique de récompense claire, l'entrée dans le RFT devient nettement plus simple : on peut commencer avec 100–200 exemples, vérifier les métriques, comparer les checkpoints et déterminer si l'ajustement donnera un modèle moins cher et plus rapide pour une tâche précise. C'est particulièrement intéressant pour les mathématiques, le code et les autres scénarios où la qualité de la réponse peut être vérifiée automatiquement.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Comment fonctionne le processus?
Le reinforcement fine-tuning (RFT) s'utilise lorsque montrer au modèle les bonnes réponses, comme dans le supervised fine-tuning classique, ne suffit pas. Ici, le modèle génère plusieurs réponses à un même prompt, puis une fonction de récompense distincte attribue à chacune une note numérique. Amazon Bedrock exploite ce signal et exécute lui-même la boucle d'optimisation avec l'algorithme GRPO. Pour une équipe, cela signifie qu'il n'est pas nécessaire de monter une lourde infrastructure de reinforcement learning : le service prend en charge l'orchestration, le parallélisme,
Que sait-on sur Données et fonction de récompense ?
Dans son exemple, AWS utilise le jeu de données GSM8K, composé de problèmes de mathématiques de niveau primaire. Les données sont chargées via la Files API au format JSONL : chaque ligne contient un bloc `messages` et, pour les tâches vérifiables, un `reference_answer`. Ce format permet non seulement d'envoyer la question au modèle, mais aussi de conserver une réponse de référence ou une règle de vérification. Le walkthrough montre aussi que le prompt peut être structuré à l'avance pour que la réponse finale soit facile à extraire automatiquement, par exemple dans un format
Que sait-on sur Entraînement et lancement ?
Le lancement de l'entraînement est assez compact : `fine_tuning.jobs.create()` reçoit le modèle de base, le fichier d'entraînement, le type de méthode `reinforcement`, l'ARN de l'évaluateur Lambda et un ensemble d'hyperparamètres. L'exemple utilise `openai.gpt-oss-20b`, une époque, `batch_size=4` et `learning_rate_multiplier=1.0`, même si la documentation recommande, par souci de stabilité, de commencer avec une valeur inférieure à un. Bedrock crée ensuite le job, compte les étapes et enregistre des checkpoints intermédiaires, utilisables pour évaluer la qualité avant la fi
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.