Advanced Payment Solutions lance en pilote un souffleur IA pour appels sans équipe ML
Advanced Payment Solutions présente un cas rare sur le marché : son assistant vocal IA pour appels n'a pas été conçu par des ingénieurs ML, mais par 12 développeurs backend. En six mois, l'équipe a mené le produit jusqu'au pilote, renoncé au fine-tuning et à une base vectorielle lourde, basculé la génération sur un Qwen 8B local et atteint une latence d'environ deux secondes, suffisante pour souffler des conseils au gestionnaire en pleine conversation. Le pilote donne déjà des signaux qualitatifs d'utilité, mais il n'existe pas encore de conclusions statistiquement significatives sur la conversion ni sur les KPI. Selon l'entreprise, il faut pour cela passer à l'échelle et intégrer le produit sans couture au CRM.
Traité par IA depuis Habr AI ; édité par Hamidun News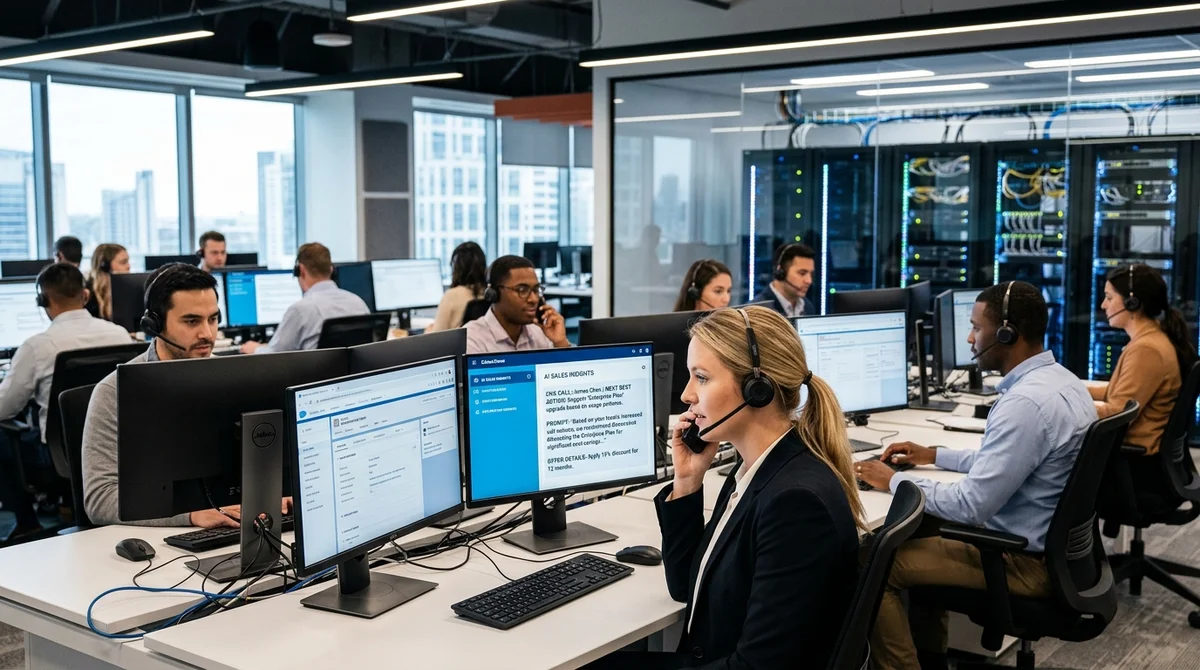
Advanced Payment Solutions a raconté comment elle a lancé en pilote un assistant vocal IA pour appels sans disposer d'équipe ML en interne. En six mois, 12 développeurs backend ont assemblé un système qui suggère en temps réel au gestionnaire comment répondre au client, avec une latence d'environ deux secondes.
Comment le MVP a été construit
En interne, le projet s'appelle « Suflyor » (« Souffleur »). Sa mission : écouter une conversation déjà transcrite, comprendre de quel produit il s'agit, repérer l'objection du client et afficher aussitôt au gestionnaire une suggestion textuelle. La pile finale repose sur Python, FastAPI et PostgreSQL, tandis que la classification et la génération sont confiées à des classificateurs BERT et à un Qwen 8B local. Pour l'entreprise, c'est un moyen d'alléger la charge des mentors et d'amener plus vite les nouveaux employés à leurs KPI, surtout quand l'écosystème compte plus de 35 produits et que le gestionnaire doit garder en tête trop de scénarios.
La contrainte clé était stricte : le système n'a que 1,5–2 secondes pour répondre, faute de quoi la suggestion perd son sens en pleine conversation.
L'équipe est vite arrivée à un prototype fonctionnel. Pendant les trois premières semaines, les développeurs ont pris des transcriptions textuelles d'appels, entraîné deux classificateurs BERT sur environ 1,5 mille dialogues, assemblé de simples bases de connaissances avec des scripts et relié le tout par des prompts à un modèle GPT dans le cloud. L'interface a été réalisée en une journée avec Django. Cette preuve de concept était lente, avec une latence de 10–15 secondes, mais elle a suffi à convaincre le métier et à obtenir le feu vert pour le MVP. Le travail d'ingénierie a ensuite commencé : réduire la latence, stabiliser le système, réaliser les intégrations.
Pourquoi tout a été simplifié
Au départ, l'équipe, comme cela arrive souvent dans les projets d'IA, a conçu un système trop ambitieux : un pipeline audio maison, plusieurs classificateurs complexes, le fine-tuning d'un grand modèle de langage, une base vectorielle et même une boucle d'auto-apprentissage. Mais il est vite apparu que cette voie repousserait le lancement de 12–18 mois et ferait fortement grimper le risque d'échec. Plutôt que de chercher l'architecture « parfaite », les développeurs ont méthodiquement retiré tout ce dont la première version pouvait se passer.
«
Nous n'avons pas lutté contre les problèmes, nous avons repensé le système pour qu'ils n'y apparaissent pas. »
- Ils ont abandonné le fine-tuning au profit du RAG, pour ne pas passer des mois sur l'annotation et réduire le risque d'hallucinations.
- Ils n'ont pas écrit leur propre transcription et ont repris des segments de texte prêts à l'emploi de Voximplant.
- Ils ont simplifié le classificateur d'objections : au lieu de plus de 15 classes, ils ont gardé un schéma binaire « objection / pas d'objection ».
- Ils n'ont pas déployé de base vectorielle lourde pour quelques mégaoctets de données et ont chargé des fichiers JSON structurés directement en mémoire.
- Ils ont quitté les API cloud pour un Qwen 8B local sur un serveur GPU, afin de tenir la latence et de ne pas faire sortir de données sensibles du périmètre.
Cet ensemble de compromis s'est révélé décisif. Les modèles cloud répondaient en 7–20 secondes, et Qwen 32B, bien que plus précis, ne tenait pas non plus dans le budget de temps. Le Qwen 8B, plus compact, s'est avéré assez bon pour les suggestions au gestionnaire et a stabilisé la latence autour de deux secondes. Parallèlement, le déploiement local a réglé les questions de sécurité de l'information : les transcriptions des conversations n'ont pas à être envoyées à des services externes, il n'a donc pas fallu construire une couche distincte de masquage des données personnelles ni la payer en latence supplémentaire.
Ce qu'a montré le pilote
Le problème le plus sous-estimé n'a pas été les modèles, mais les données. L'équipe a pris 200 appels, les a répartis entre 12 participants et s'est vite heurtée à l'annotation manuelle : pour classer correctement les objections, il ne suffit pas d'isoler une phrase, il faut comprendre le contexte de la conversation et la logique de vente. Les développeurs ont donc reformulé le problème lui-même. Au lieu de chercher à « apprendre à l'IA à penser comme un expert », ils se sont concentrés sur un objectif plus étroit : repérer à temps le moment où le gestionnaire a besoin d'aide, puis récupérer le bon script et générer la suggestion.
À l'issue du pilote, le système affichait une latence moyenne d'environ deux secondes, ne montant à trois que dans 2–3% des cas. La classification des services a atteint une précision supérieure à 70%, et la reconnaissance vocale, à partir de 92% selon la qualité de la liaison.
L'équipe écrit que le pilote a déjà eu un effet qualitatif : les premiers signaux apparaissent sur le confort d'usage, l'allègement de la charge des mentors et l'utilité globale pour les opérateurs. Mais il n'y a pas encore de conclusions statistiquement significatives sur la conversion et les KPI : le produit doit pour cela passer à l'échelle et s'intégrer sans couture directement dans le CRM.
Ce que cela signifie
Ce cas montre qu'un produit d'IA interne n'exige pas toujours une équipe ML constituée dès le départ. Si une entreprise dispose de solides ingénieurs backend, d'un problème métier clair et d'un accès aux processus, un MVP peut être assemblé plus vite en simplifiant radicalement l'architecture et en renonçant aux composants « intelligents » superflus. L'enseignement principal ne tient pas au choix d'un modèle précis, mais à la discipline : résoudre d'abord le problème du métier, vérifier ensuite les contraintes de vitesse et de sécurité, et ne complexifier la pile qu'après.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026TensorFold 1.2.0 augmente de 44,2% le débit de Qwen3.8-27B sur M3 Ultra à 16 flux
- 1 nov. 2026Le juge d'EditAgent (Adobe) retient une retouche valable dans 81,3% des cas, contre 74,8% pour EditScore
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
Questions clés sur cet article
Comment le MVP a été construit?
En interne, le projet s'appelle « Suflyor » (« Souffleur »). Sa mission : écouter une conversation déjà transcrite, comprendre de quel produit il s'agit, repérer l'objection du client et afficher aussitôt au gestionnaire une suggestion textuelle. La pile finale repose sur Python, FastAPI et PostgreSQL, tandis que la classification et la génération sont confiées à des classificateurs BERT et à un Qwen 8B local. Pour l'entreprise, c'est un moyen d'alléger la charge des mentors et d'amener plus vite les nouveaux employés à leurs KPI, surtout quand l'écosystème compte plus de 3
Pourquoi tout a été simplifié?
Au départ, l'équipe, comme cela arrive souvent dans les projets d'IA, a conçu un système trop ambitieux : un pipeline audio maison, plusieurs classificateurs complexes, le fine-tuning d'un grand modèle de langage, une base vectorielle et même une boucle d'auto-apprentissage. Mais il est vite apparu que cette voie repousserait le lancement de 12–18 mois et ferait fortement grimper le risque d'échec. Plutôt que de chercher l'architecture « parfaite », les développeurs ont méthodiquement retiré tout ce dont la première version pouvait se passer. « Nous n'avons pas lutté contre
Que sait-on sur Ce qu'a montré le pilote ?
Le problème le plus sous-estimé n'a pas été les modèles, mais les données. L'équipe a pris 200 appels, les a répartis entre 12 participants et s'est vite heurtée à l'annotation manuelle : pour classer correctement les objections, il ne suffit pas d'isoler une phrase, il faut comprendre le contexte de la conversation et la logique de vente. Les développeurs ont donc reformulé le problème lui-même. Au lieu de chercher à « apprendre à l'IA à penser comme un expert », ils se sont concentrés sur un objectif plus étroit : repérer à temps le moment où le gestionnaire a besoin d'ai
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.