Pourquoi LoRA déraille en production et comment RS-LoRA sauve le fine-tuning des modèles
LoRA fonctionne bien quand un modèle doit seulement changer de ton, de format ou de persona, mais elle peine dès qu'il faut lui ajouter des faits nouveaux. Un rang faible tronque un signal de grande dimension, et augmenter simplement le rang affaiblit l'apprentissage. RS-LoRA propose un correctif simple : utiliser alpha/√r au lieu de alpha/r, ce qui préserve la stabilité aux rangs élevés.
Traité par IA depuis MarkTechPost ; édité par Hamidun News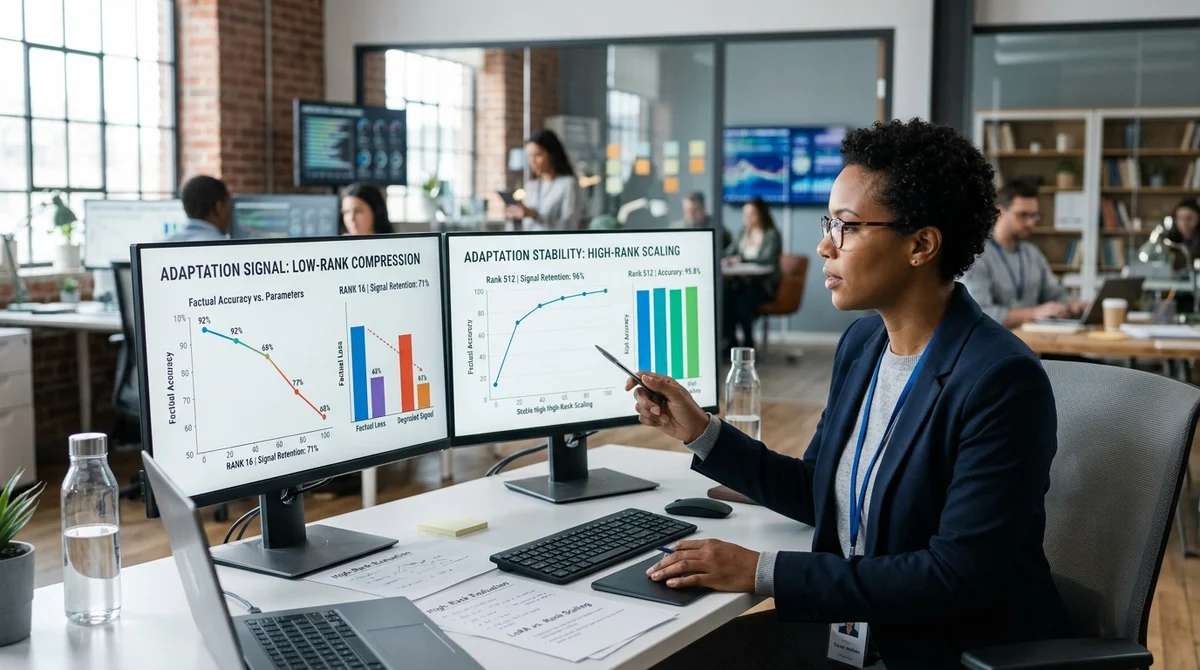
LoRA est depuis longtemps le standard du fine-tuning économique des grands modèles, mais en production elle repose sur une hypothèse cachée : que toutes les mises à jour de poids se ressemblent. En pratique, ce n'est pas le cas. Les changements qui gouvernent le style sont réellement compacts, tandis que les mises à jour qui ajoutent des faits nouveaux et une expertise métier se répartissent sur de nombreuses dimensions, et c'est là que la LoRA classique commence à perdre de l'information.
La popularité de LoRA s'explique : la méthode permet d'affiner un modèle sans recalculer tous ses paramètres, grâce à de petites matrices de rang faible. Cela fonctionne bien quand il faut changer le ton, le format de réponse, le personnage ou les tics de langage d'un assistant. L'article le démontre sur une matrice de poids simplifiée de 64×64 : dans une mise à jour de style, quelques valeurs singulières dominent nettement, si bien qu'une approximation de rang 4 ou 8 conserve presque tout le signal.
Dans leur simulation, le rang 4 couvre déjà plus de 99 % de la variation utile. Un chatbot apprend donc facilement un nouveau style de communication, un gabarit de réponse ou une manière voulue, sans réentraîner lourdement tout le modèle.
Les problèmes commencent quand il faut enseigner du contenu plutôt que de la forme : faits médicaux, catalogues de produits, règlements internes, statistiques ou règles sectorielles. Ces mises à jour se comportent comme des mises à jour de rang élevé : l'information est diluée dans de multiples directions au lieu d'être concentrée dans quelques composantes dominantes. Dans l'expérience de l'article, le rang 8 ne retient qu'environ 28 % du signal réel.
D'où un effet bien connu en production : le modèle paraît sûr de lui, emploie la bonne terminologie et la structure générale de la réponse, mais confond des chiffres, omet des détails ou livre une conclusion incomplète. Pour les assistants d'entreprise, l'analytique, le support et les scénarios fondés sur la connaissance, ce n'est pas un défaut cosmétique mais un risque pour la qualité.
La différence clé apparaît dans le spectre des valeurs singulières. Les tâches de style présentent un coude net : après quelques composantes, les dimensions supplémentaires n'apportent presque rien. Les faits ont une longue traîne, où chaque composante supplémentaire apporte une part de la connaissance utile.
Quand LoRA tronque brutalement une telle mise à jour à un rang faible, elle coupe précisément cette traîne. De l'extérieur, le système peut quand même sembler amélioré, car le format, le ton et la structure sont plus soignés, mais la précision factuelle progresse bien moins que ne le laissent croire les tests superficiels. Cela explique pourquoi des démos aux réponses soignées et au bon style ne garantissent pas un comportement fiable sur des données de travail réelles.
La réaction logique d'un ingénieur est d'augmenter le rang. Mais la LoRA standard cache un second problème : la mise à l'échelle alpha/r. Plus le rang est élevé, plus le coefficient se contracte et plus le signal d'apprentissage s'affaiblit.
Dans l'exemple avec alpha = 16, l'échelle passe de 16 au rang 1 à 0,25 au rang 64. Il en résulte un paradoxe : on ajoute de la capacité pour que le modèle représente une mise à jour plus complexe, mais on réduit en même temps l'influence réelle de cette mise à jour sur les poids. L'optimiseur doit compenser par des pas plus agressifs, ce qui fait que l'entraînement converge moins bien ou devient instable.
C'est pourquoi le conseil d'augmenter le rang ne règle souvent pas le problème en production, et ne fait parfois que le masquer.
RS-LoRA propose un correctif minimal mais important : utiliser alpha/√r au lieu de alpha/r. Formellement, c'est presque le remplacement d'un seul symbole, mais l'effet est considérable en pratique. Au rang 64, l'échelle reste à 2,0 au lieu de 0,25, si bien que l'adaptation de rang élevé conserve une amplitude significative et ne tue pas le signal.
L'article le montre sans lourdes boucles d'entraînement ni frameworks, uniquement avec NumPy, la SVD et une comparaison des erreurs de reconstruction. L'argument n'en est que plus limpide : les tâches de style de rang faible restent bien traitées par la LoRA classique, tandis que les tâches d'ajout de connaissances exigent soit RS-LoRA, soit une stratégie d'adaptation fondamentalement différente.
La conclusion pour les équipes qui déploient des LLM affinés en production est assez directe : la configuration de l'adaptateur doit se choisir non seulement selon le budget et la vitesse, mais aussi selon le type de mise à jour. Si l'on change le ton, le personnage ou le format de réponse, la LoRA standard de rang faible suffit généralement. Si l'on injecte des faits nouveaux, des données de référence, des règles ou une expertise métier, un rang faible peut créer l'illusion d'un apprentissage réussi tout en perdant discrètement une part substantielle de l'information. Dans ces cas, RS-LoRA ne ressemble plus à une optimisation fine, mais à une exigence de fiabilité du modèle en exploitation réelle.
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.