Databricks et Infosys : pourquoi les données freinent l'adoption de l'intelligence artificielle
Le principal obstacle à l'IA en entreprise est plus banal que les modèles eux-mêmes : les données. Les entreprises veulent passer des chatbots à l'automatisation des processus et aux agents d'IA, mais il leur faut pour cela des entrepôts unifiés, des droits d'accès clairs, un contrôle de l'origine des données et un lien entre systèmes analytiques et transactionnels. Sans cette base, les pilotes font bonne figure, mais le passage à l'échelle se heurte vite au chaos et aux risques.
Traité par IA depuis MIT Technology Review ; édité par Hamidun News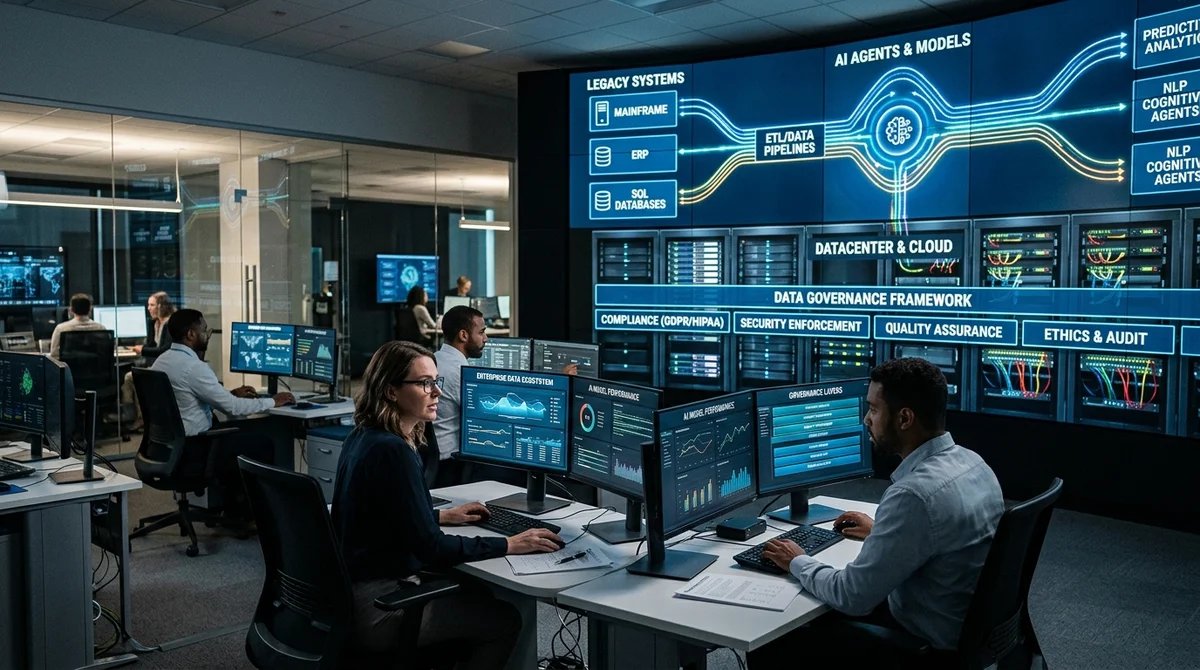
Les entreprises parlent de plus en plus d'intelligence artificielle au niveau du conseil d'administration, mais le déploiement réel de l'IA dans le business est plus souvent freiné non par les modèles ni par la puissance de calcul, mais par l'état des données de l'entreprise. Les services grand public ont habitué le marché à des effets immédiats, mais au sein des grandes organisations, on découvre vite une réalité plus prosaïque : sans infrastructure de données unifiée, gouvernée et exploitable en production, l'IA reste une belle démonstration, et non un outil de travail.
Le problème central tient à ce que les données d'une entreprise vivent généralement dans des couches trop différentes. Une partie se trouve dans des data marts analytiques et des data lakes, une autre dans des systèmes transactionnels comme les CRM, les ERP et les applications internes, et une autre encore est éparpillée entre fichiers, e-mails, bases de connaissances, tickets et services cloud. Pour le reporting classique, ce paysage reste tolérable.
Mais lorsque l'entreprise veut donner au modèle un accès aux données en temps réel, intégrer l'IA aux processus ou lancer des agents qui ne se contentent pas de répondre aux questions mais passent à l'action, la fragmentation devient une contrainte directe. Un modèle peut être puissant, mais s'il ne voit pas le contexte actuel, ne comprend pas l'origine des données et ne fonctionne pas dans le cadre de droits d'accès précis, le résultat est instable et risqué.
C'est pourquoi le débat sur l'IA d'entreprise glisse de plus en plus des modèles vers l'architecture. L'une des thèses clés : les entreprises n'ont pas besoin d'un assemblage d'outils d'IA disparates, mais d'une nouvelle data stack, où les données sont stockées dans des formats ouverts, décrites par des métadonnées, accessibles via des politiques unifiées et utilisables à la fois pour l'analytique et pour des scénarios opérationnels. D'où l'intérêt pour les architectures qui rapprochent les mondes OLAP et OLTP : d'un côté, les entreprises ont besoin de profondeur analytique, d'historique et d'échelle ; de l'autre, de faible latence, de transactionnalité et de capacité à agir vite.
Dans cette approche, Databricks met en avant Lakebase comme une couche Postgres serverless pour les charges d'IA opérationnelles, et Unity Catalog comme une couche unique de contrôle d'accès, de traçabilité des données et de gouvernance pour les données et les actifs d'IA. L'essentiel n'est pas dans les produits eux-mêmes, mais dans la tendance : le business a besoin d'une fondation sur laquelle l'IA puisse tourner en production, et pas seulement en pilote.
La mesure de l'effet est une question à part. Au début, les entreprises se contentent souvent de métriques flatteuses, comme le nombre de requêtes au chatbot ou le pourcentage de salariés ayant ouvert des copilotes. Mais à mesure que l'adoption mûrit, cela ne suffit plus.
Si l'IA doit automatiser des processus, raccourcir le cycle d'une opération, augmenter la conversion ou créer de nouvelles sources de revenus, il faut l'évaluer comme un véritable système métier. Le débat sur la nouvelle data stack inclut donc aussi la mesure de la valeur : l'effet de l'IA doit être relié non à un effet « waouh », mais à des résultats concrets pour l'entreprise. C'est d'autant plus important avec le passage à l'IA agentique, où le modèle gagne en autonomie, et où les exigences en matière d'observabilité, de journalisation, de qualité des données et de politique d'accès deviennent bien plus strictes.
L'évolution de l'IA d'entreprise paraît assez claire. D'abord, les entreprises adoptent des outils de productivité individuels : assistants de recherche, de synthèse, d'écriture de code ou de préparation de documents. Elles passent ensuite à l'automatisation des processus : traitement des demandes, routage des tâches, support interne, scénarios financiers et opérationnels.
Et c'est seulement après que s'ouvre la troisième étape : le lancement de nouveaux produits et de nouvelles lignes d'activité conçus dès l'origine autour de l'IA. À chaque étape, les exigences sur les données augmentent. Ce qui suffisait encore pour un copilote personnel ne fonctionne plus pour un processus qui exige de la précision, un journal complet des actions et la possibilité d'exécuter des opérations en toute sécurité au nom de l'entreprise.
D'où la conclusion principale : la prochaine bataille de l'IA d'entreprise ne porte pas sur la meilleure interface d'accès à un modèle, mais sur la refonte des données pour un usage par les machines. Les gagnants ne seront pas les entreprises qui ont branché le dernier chatbot le plus vite, mais celles qui auront réussi à rendre leurs données unifiées, gouvernées et compatibles avec les scénarios agentiques. Pour le business, cela signifie une vérité désagréable mais utile : le chemin vers l'IA à grande échelle ne commence pas par le choix d'un modèle, mais par la reconstruction de la data stack.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.