AWS montre comment synchroniser automatiquement les bases de connaissances Amazon Bedrock via S3
AWS a décrit une solution serverless qui synchronise automatiquement les documents stockés dans S3 avec Amazon Bedrock Knowledge Bases. Le dispositif capte les événements du stockage, place les tâches en file d'attente via SQS et ne lance les ingestion jobs que dans la limite des quotas du service. Résultat : la base de connaissances se met à jour quasiment en temps réel, sans supervision manuelle ni charge inutile sur l'API.
Traité par IA depuis AWS Machine Learning Blog ; édité par Hamidun News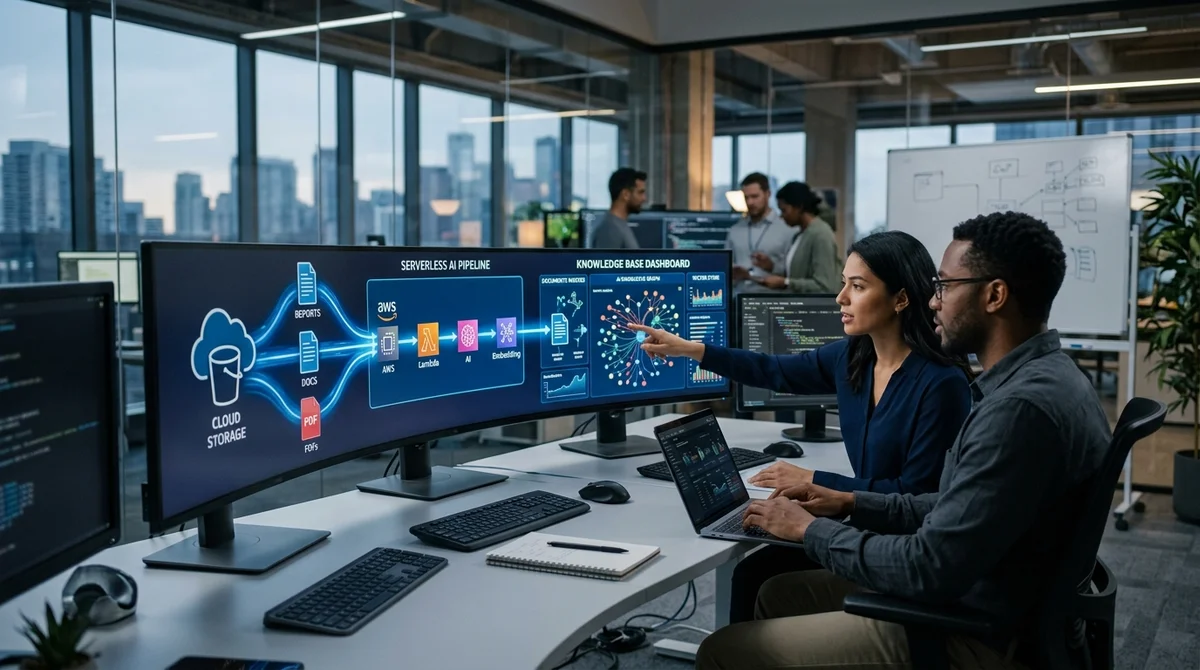
AWS propose une méthode concrète pour mettre à jour automatiquement les bases de connaissances Amazon Bedrock, sans lancer manuellement une tâche d'ingestion après chaque modification du stockage. Le principe : relier les événements Amazon S3 à un pipeline serverless qui détecte lui-même les fichiers nouveaux ou modifiés, déclenche la synchronisation et reste dans les limites de Bedrock. Pour les équipes qui construisent des services RAG sur des documents d'entreprise, cela règle l'un des problèmes opérationnels les plus courants : la base de connaissances ne prend plus de retard sur les données sources et se met à jour de façon prévisible, plutôt que selon un planning ou sur commande manuelle.
Les Knowledge Bases d'Amazon Bedrock servent à connecter les modèles génératifs aux données internes de l'entreprise : procédures, articles, PDF, tableaux et autres documents. Mais le modèle ne découvre pas seul les nouveaux fichiers : une fois les données chargées dans S3, il faut encore les réindexer via un ingestion job. Fait à la main, ce processus ne tient pas à l'échelle : les documents arrivent à des moments différents, les mises à jour sont irrégulières, et l'équipe finit par jongler entre la console AWS, des scripts et des files de synchronisation.
La solution décrite par AWS repose sur une architecture événementielle. Lorsqu'un nouveau fichier apparaît dans S3, qu'un objet existant est modifié ou qu'un autre événement pertinent survient, le système l'enregistre et déclenche un ingestion job pour la base de connaissances concernée. L'approche serverless compte ici pour deux raisons.
D'abord, nul besoin de maintenir un service tournant en permanence uniquement pour surveiller les changements. Ensuite, la logique s'adapte facilement à un flux de mises à jour imprévisible : quand les événements sont rares, l'infrastructure ne consomme presque rien, et quand ils se multiplient, le pipeline continue de fonctionner en mode automatique. L'accent porte non pas seulement sur le déclenchement automatique, mais sur le respect des quotas de service d'Amazon Bedrock.
Le détail est important : un schéma naïf, où chaque événement lance immédiatement sa propre tâche, peut vite se heurter aux limites de l'API, surtout si des centaines de fichiers arrivent simultanément dans le bucket ou si une archive documentaire est mise à jour en masse. La synchronisation doit donc savoir doser la charge, éviter les ingestion jobs superflus et ne pas transformer une automatisation utile en source d'erreurs et d'appels répétés. Autre atout : un monitoring complet, qui permet à l'équipe de voir facilement quelles tâches ont été lancées, où des retards sont apparus et si des modifications de données passent à la trappe.
Pour les équipes produit et ingénierie, ce n'est pas un simple détail d'infrastructure. Dans les systèmes RAG, la qualité des réponses dépend directement de la fraîcheur du contexte fourni au modèle. Si la base de connaissances se met à jour avec retard, l'utilisateur peut tomber sur des prix périmés, d'anciens règlements, des descriptions de processus obsolètes ou des documents manquants.
La synchronisation automatique réduit cet écart entre la source de données et la réponse du modèle. Elle simplifie aussi l'exploitation : au lieu de relancer manuellement les mises à jour après chaque export, l'équipe dispose d'un processus reproductible, à la logique claire, avec maîtrise de la charge et observabilité. Il est révélateur qu'AWS mise précisément sur un schéma serverless et event-driven, plutôt que sur une intégration lourde avec traitement continu en arrière-plan.
Pour beaucoup d'entreprises, c'est la voie la plus simple pour déployer une recherche générative sur des stockages S3 existants : les données restent dans leur environnement habituel, et la mise à jour de l'index devient une réaction à un événement. Cette approche est particulièrement utile là où les documents changent souvent : support, base de connaissances interne, analytique, conformité et documentation produit. La conclusion est simple : à mesure que Bedrock sert de plus en plus de socle aux assistants d'entreprise et à la recherche documentaire, la synchronisation manuelle des données devient le maillon faible.
AWS propose de fait un modèle pour automatiser ce processus sans perdre la maîtrise des quotas ni de l'état du pipeline. Pour les entreprises, cela signifie des réponses de modèles plus à jour, moins de routine manuelle et un fonctionnement plus prévisible de la base de connaissances en production.
- 2 nov. 2026Les steering vectors améliorent le SFT et la distillation des LLM sur trois seeds
- 2 nov. 2026Anthropic doit augmenter son chiffre d'affaires de 32 % par an pour couvrir 850 milliards de dollars de contrats
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
- 31 oct. 2026Worldwide Express confie ses factures litigieuses à des agents IA et réduit sa dette de 75%
Ship AI Faster with Founders, Engineers & Weekly Architecture Reviews
Inside Vibe Club (hamidun.com/club) — weekly live masterminds with Zhemal Khamidun, Tech Radar, full LMS access, and 370+ production Claude Code skills.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.