Fin de l'IA chère : Google et NVIDIA font chuter le coût de l'inférence
Le principal obstacle au développement de l'intelligence artificielle n'a jamais été le coût d'entraînement des modèles, mais celui de leur exploitation quotidienne. Lors de la Google Cloud Next, Google et NVIDIA ont présenté une solution commune capable de bouleverser l'économie du cloud. Les nouvelles instances A5X, qui reposent sur les systèmes monolithiques en rack NVIDIA Vera Rubin NVL72, promettent de réduire par dix le coût de l'inférence. Selon les deux entreprises, ce résultat découle d'une intégration matérielle et logicielle d'une profondeur inédite. Une telle baisse des coûts devrait inévitablement rendre l'IA multimodale avancée accessible aux services grand public.
Traité par IA depuis AI News ; édité par Hamidun News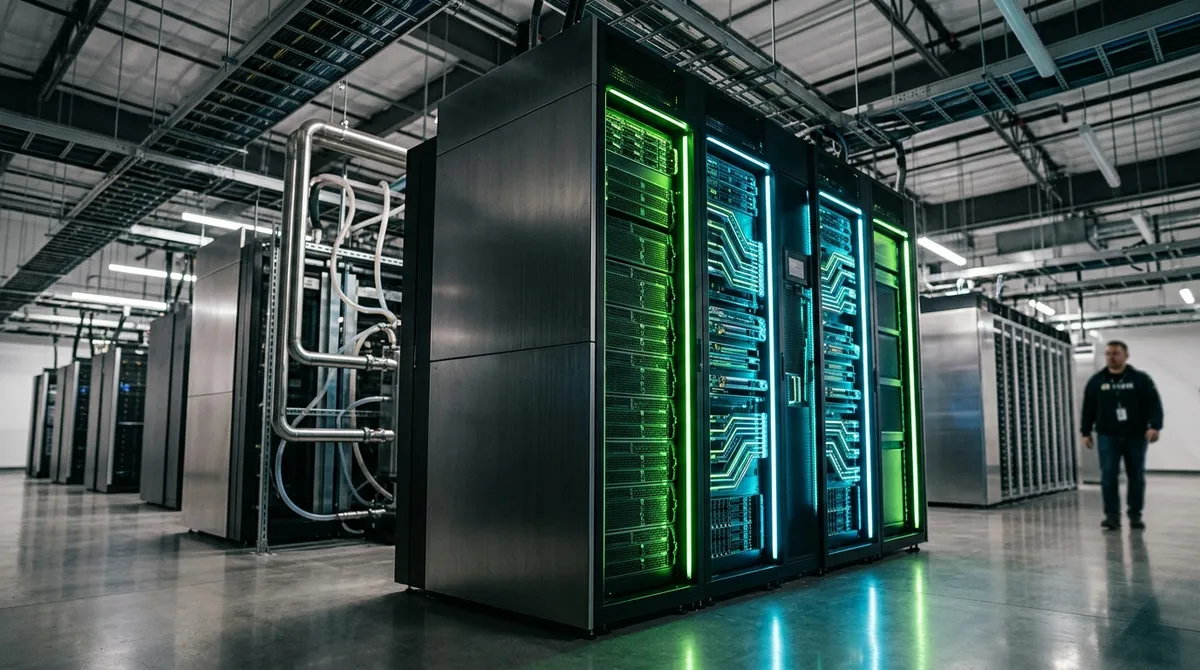
Pendant longtemps, l'industrie de l'intelligence artificielle est restée prisonnière de sa propre ambition, masquant des problèmes économiques de fond derrière des annonces fracassantes. L'attention du public se porte traditionnellement sur les coûts colossaux de l'entraînement initial des nouveaux modèles de langage, mais le véritable trou noir financier se cache dans leur exploitation quotidienne. Générer des réponses à des millions de requêtes d'utilisateurs chaque jour, ce que le secteur appelle l'inférence, exige le fonctionnement ininterrompu de clusters immenses et extrêmement gourmands en énergie.
Ce facteur a jusqu'ici rendu économiquement irréaliste, pour l'écrasante majorité des entreprises, le déploiement massif d'une IA multimodale réellement de pointe. Lors de la Google Cloud Next, qui vient de se tenir, les géants Google et NVIDIA ont annoncé la fin de cette ère de pénurie d'infrastructure en présentant une nouvelle architecture commune qui promet de diviser par dix le coût de l'inférence.
Cette avancée repose sur les nouvelles instances de calcul A5X, proposées en « bare metal » (sur serveur physique dédié). Renoncer à la virtualisation classique élimine toute perte de performance liée aux couches logicielles intermédiaires et met toute la puissance de calcul directement au service des algorithmes. Ces instances s'appuient sur la monumentale architecture NVIDIA Vera Rubin, changement de génération très attendu qui succède à Blackwell.
L'élément central de la nouvelle infrastructure est le système en rack NVL72. À la différence de l'approche modulaire traditionnelle, où des GPU individuels sont regroupés dans des serveurs standard avec les goulots d'étranglement inévitables dans le transfert des données, le NVL72 est un système de calcul monolithique de la taille d'une armoire entière. Dans ce rack, soixante-douze processeurs graphiques de nouvelle génération fonctionnent comme un seul supercalculateur géant, reliés par des interconnexions optiques ultrarapides.
Cette conception radicale des serveurs s'attaque au principal problème de l'inférence moderne : la bande passante mémoire. Même les plus gros modèles de langage, avec des centaines de milliards de paramètres, peuvent désormais être chargés en totalité dans la mémoire partagée du système. Le cluster n'a plus à déplacer en permanence, lentement et à grand coût énergétique, des blocs de données entre nœuds distincts.
La réduction annoncée d'un facteur dix du coût de génération des tokens ne tient pas seulement à la puissance brute de silicium des puces Rubin, mais aussi à un niveau inédit de co-conception approfondie du matériel et du logiciel. Fait notable : Google, qui possède ses propres processeurs tensoriels TPU très puissants, a poussé l'intégration avec NVIDIA aussi loin, reconnaissant la nécessité d'une approche hybride pour répondre à l'énorme demande des développeurs.
Les ingénieurs des deux entreprises ont littéralement réécrit la pile de base de gestion du calcul, en l'optimisant pour les besoins spécifiques de la génération de contenu à grande échelle. Les nouveaux algorithmes de répartition de la charge, au niveau logiciel, tiennent désormais compte de la topologie physique du rack Vera Rubin et réduisent au minimum les délais de signal, à l'échelle de la microseconde. Parallèlement, un refroidissement liquide avancé et de nouveaux contrôleurs d'alimentation intelligents ont permis de réduire radicalement la consommation électrique par mégaoctet de données généré. Pour les centres de données actuels, où la facture d'électricité dépasse souvent le coût des serveurs eux-mêmes, c'est un facteur de rentabilité critique.
Il est difficile de surestimer les conséquences de cette annonce pour le marché, car elle fait tomber une barrière fondamentale dans l'économie unitaire des services fondés sur l'intelligence artificielle. Jusqu'à présent, les développeurs indépendants comme les grandes entreprises devaient sans cesse faire des compromis. Ils étaient contraints de brider artificiellement les fonctionnalités de leurs produits en recourant à des modèles moins capables mais moins chers, ou d'imposer des limites strictes au nombre de requêtes pour ne pas se ruiner en factures de cloud. Une baisse des coûts d'un facteur dix signifie que des modèles économiques qui relevaient hier de la pure science-fiction, en raison du coût démesuré du calcul, deviennent aujourd'hui tout à fait rentables.
À court terme, la baisse du coût de l'inférence provoquera une révolution discrète mais grandiose de l'expérience utilisateur. Analyse vidéo complexe en temps réel, génération personnalisée de mondes en trois dimensions à la volée dans les jeux vidéo, agents d'IA intelligents travaillant en arrière-plan 24 heures sur 24 et analysant tout le flux d'informations entrant : tout cela pourrait devenir un standard grand public plutôt qu'un service premium coûteux. Pour les fournisseurs de cloud, l'alliance de Google et de NVIDIA place la barre d'efficacité à un niveau effrayant.
Les approches traditionnelles de construction des centres de données vieillissent à vive allure et laissent la place à des solutions hyperoptimisées à l'échelle de racks entiers. Ce partenariat marque un changement de paradigme majeur : l'industrie passe définitivement de la course à l'IA la plus intelligente à une course pragmatique pour la distribuer le moins cher, le plus vite et le plus efficacement possible à chaque utilisateur de la planète.
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Un journaliste de The Verge assemble un équivalent du Meta Muse Charm à $50 avec Claude Code
- 1 nov. 2026Test de 16 modèles sur 7 moteurs de recherche : Exa obtient en moyenne 10,5 points sur 14, SearXNG environ 3
- 1 nov. 2026L'agent vidéo StreamVibe de Google devance les autres modèles de 10,7 % sur le timing et la qualité des réponses
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.