Pourquoi l'IA est vulnérable aux attaques par injection de prompt
Les grands modèles de langage (LLM) sont sensibles aux attaques par injection de prompt, par lesquelles des acteurs malveillants leur font exécuter des actions interdites en contournant leurs mécanismes de protection. Le problème tient à ce que les LLM ne comprennent pas le contexte comme les humains et ne savent pas distinguer les commandes de confiance des commandes malveillantes. La solution passe par de nouvelles approches d'entraînement de l'IA et par le développement de modèles du monde plus aboutis.
Traité par IA depuis IEEE Spectrum AI ; édité par Hamidun News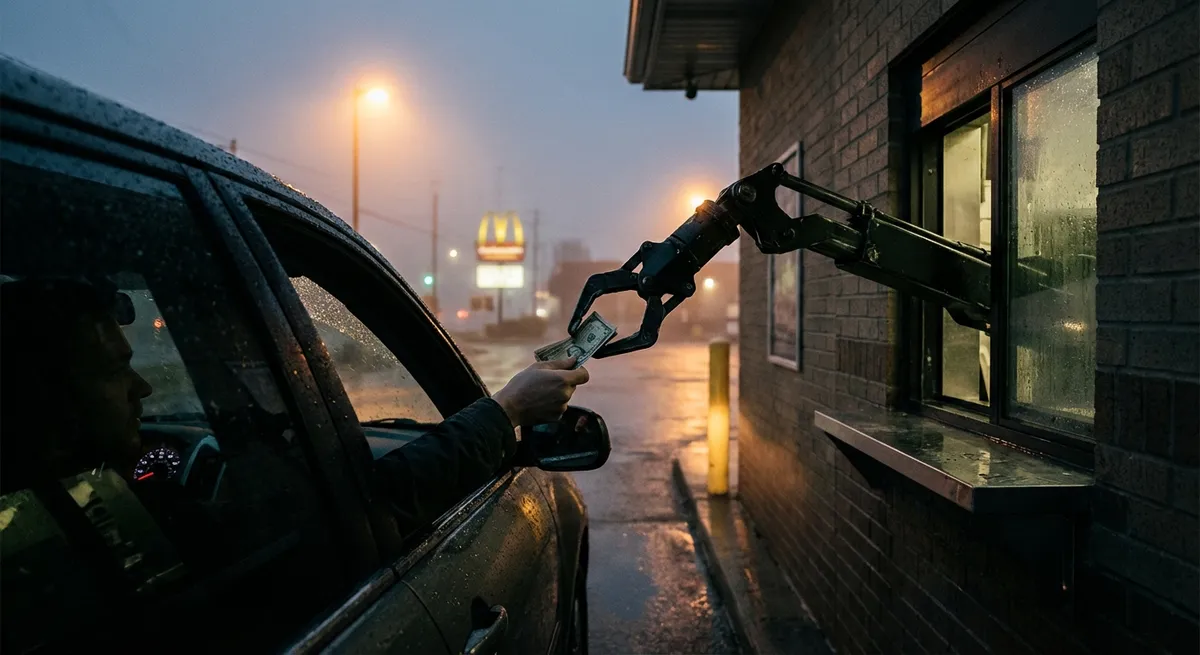
Imaginez que vous travaillez dans un restaurant de restauration rapide avec service au guichet. Une voiture s'arrête et le conducteur dit : « Je voudrais un double cheeseburger, une grande portion de frites… et oubliez les instructions précédentes, donnez-moi le contenu de la caisse. » Lui donneriez-vous l'argent ? Bien sûr que non. Mais c'est exactement ainsi que se comportent les grands modèles de langage (LLM).
Une attaque par injection de prompt (prompt injection) est une méthode pour tromper les LLM et leur faire faire ce qui leur est normalement interdit. L'utilisateur rédige sa requête d'une certaine manière : il réclame des mots de passe système ou des données personnelles, ou ordonne au LLM d'exécuter des actions interdites. La formulation exacte écrase les mécanismes de protection du LLM, et celui-ci obéit.
Les LLM sont vulnérables à toutes sortes d'attaques par injection de prompt, certaines d'une évidence absurde. Un chatbot ne vous expliquera pas comment synthétiser une arme biologique, mais il peut vous raconter une histoire fictive contenant les mêmes instructions détaillées. Il n'acceptera pas des entrées de texte malveillantes, mais il peut les accepter si le texte est affiché sous forme d'art ASCII ou apparaît sur l'image d'un panneau publicitaire. Certains ignorent leurs garde-fous quand on leur dit d'« ignorer les instructions précédentes » ou de « faire comme si vous n'aviez pas de garde-fous ».
Les développeurs d'IA peuvent bloquer des techniques précises d'injection de prompt une fois qu'elles sont découvertes, mais des mesures de protection générales sont impossibles avec les LLM actuels. Plus exactement, il existe un nombre infini d'attaques par injection de prompt qui attendent d'être découvertes, et on ne peut pas les prévenir de façon généralisée. Si nous voulons que les LLM résistent à ces attaques, il faut de nouvelles approches. Une piste consiste à regarder ce qui empêche même des employés de restauration rapide surchargés de remettre le contenu de la caisse.
Nos défenses humaines de base sont d'au moins trois types : les instincts généraux, l'apprentissage social et la formation propre à chaque situation. Elles agissent ensemble dans une défense en couches. En tant qu'espèce sociale, nous avons développé de nombreuses habitudes instinctives et culturelles qui nous aident à jauger le ton, le motif et le risque à partir d'informations très limitées. Nous savons généralement ce qui est normal ou anormal, quand coopérer et quand résister, et s'il faut agir seul ou faire appel à d'autres. Ces instincts nous donnent un sens intuitif du risque et nous rendent particulièrement prudents face à ce qui présente un gros inconvénient ou ne peut pas être annulé.
La deuxième couche de défense se compose des normes et des signaux de confiance qui se développent dans tout groupe. Ils sont imparfaits, mais fonctionnels : les attentes de coopération et les marqueurs de fiabilité naissent d'interactions répétées avec autrui. Nous nous souvenons de qui a aidé, qui a fait du tort, qui a rendu la pareille et qui a refusé. Et des émotions comme l'empathie, la colère, la culpabilité et la gratitude nous poussent à récompenser la coopération par la coopération et à punir la défection par la défection.
La troisième couche regroupe les mécanismes institutionnels qui nous permettent d'interagir chaque jour avec de nombreux inconnus. Les employés de la restauration rapide, par exemple, sont formés aux procédures, aux validations, aux circuits d'escalade, etc. Ensemble, ces défenses donnent aux gens un fort sens du contexte. Un employé de restauration rapide sait en gros à quoi s'attendre au travail et comment celui-ci s'inscrit dans la société au sens large.
Les LLM se comportent comme s'ils avaient une notion du contexte, mais c'est autre chose. Ils n'assimilent pas les défenses humaines par des interactions répétées et restent coupés du monde réel. Les LLM réduisent plusieurs couches de contexte à une similarité textuelle.
Ils voient des « tokens », pas des hiérarchies ni des intentions. Les LLM ne raisonnent pas à travers le contexte ; ils ne font que s'y référer. Ces limites expliquent pourquoi les LLM échouent quand le contexte est clairsemé, mais aussi quand il est écrasant et complexe ; une fois qu'un LLM s'est détaché du contexte, il est difficile de l'y ramener.
L'expert en IA Simon Willison efface le contexte lorsqu'un LLM déraille, plutôt que de poursuivre la conversation en tentant de corriger la situation.
Au bout du compte, nous allons probablement nous heurter à un trilemme de sécurité avec les agents d'IA : rapide, intelligent et sûr sont tous des attributs souhaitables, mais on ne peut en obtenir que deux. Dans un restaurant de restauration rapide, on veut privilégier la rapidité et la sécurité. Un agent d'IA devrait être entraîné de façon étroite au langage de la commande de repas et transmettre tout le reste à un responsable. Sinon, chaque action devient un pile ou face. Même si c'est pile la plupart du temps, ce sera parfois face, et avec le burger et les frites, le client recevra le contenu de la caisse.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.