Pourquoi les bots fondés sur des LLM protégés se font souvent pirater : analyse de 14 000 GPT
Les LLM de base sont protégés contre les attaques, mais les bots construits dessus sont vulnérables. Le coupable : la couche d'orchestration, avec ses system prompts, son RAG, ses outils et ses webhooks. L'analyse de 14 904 GPT personnalisés montre que cette architecture en couches devient le point faible face aux pirates.
Traité par IA depuis Habr AI ; édité par Hamidun News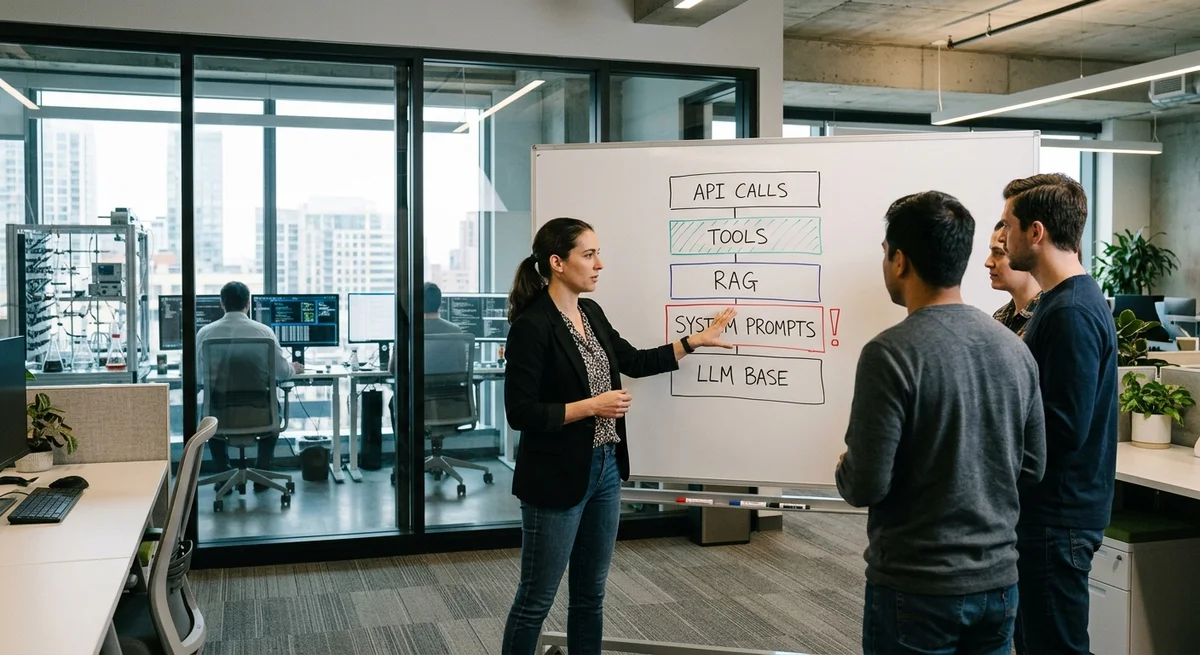
Un LLM de base sûr ne garantit pas un bot sûr. Un paradoxe ? Non, simplement une question d'architecture. Quand on prend un modèle protégé comme GPT ou Claude, qu'on l'enveloppe dans un system prompt et qu'on y ajoute du RAG, des outils et des API, une nouvelle surface d'attaque apparaît. On l'appelle la couche d'orchestration (orchestration layer), et c'est là que des bots sont piratés, alors même que le modèle est protégé.
Comment le modèle de base est protégé
Les LLM de base suivent un solide entraînement à la sécurité : leurs concepteurs leur apprennent à refuser les requêtes dangereuses. Les équipes d'OpenAI, d'Anthropic et d'autres passent des mois à faire comprendre au modèle quelles demandes ne sont pas sûres. S'y ajoute le RLHF (apprentissage par renforcement à partir de retours humains), qui aligne le modèle sur les préférences humaines concernant ce qui est éthique ou non. Résultat : si vous demandez directement à GPT de pirater un site ou de livrer des données personnelles, il refusera.
Où les problèmes commencent
Mais dès que vous enveloppez le modèle dans un bot, qu'il s'agisse d'un bot Telegram, d'une application web ou d'un agent IA, vous ajoutez toute une couche de composants, chacun potentiellement risqué :
- System prompts : des instructions données au bot, qui écrasent parfois l'entraînement du modèle et peuvent faire l'objet d'injections
- Mémoire de conversation : l'historique des requêtes, qui grossit et peut servir à une attaque contextuelle
- RAG (Retrieval-Augmented Generation) : des bases de données et documents externes qui peuvent être pollués par de fausses données
- Outils et appels de fonctions : un accès direct aux API, à la messagerie, aux bases de données et aux systèmes de paiement
- Logique de webhooks et services externes : des sources de données non fiables qui peuvent être compromises
Chaque couche ajoute un nouveau vecteur d'attaque. Un system prompt peut subir une injection via la saisie de l'utilisateur. La mémoire de conversation peut être encombrée de motifs de prompt injection. Le RAG peut renvoyer des données empoisonnées issues d'une source compromise. Les outils peuvent servir à contourner les restrictions du modèle.
Ce qu'a montré l'analyse
Des chercheurs d'arXiv ont analysé 14 904 GPT personnalisés, des agents publics créés par des utilisateurs sur la plateforme d'OpenAI. Résultat : l'immense majorité est vulnérable à des attaques élémentaires sur la couche d'orchestration. L'attaquant n'a pas besoin de pirater le modèle lui-même : il lui suffit d'injecter le system prompt ou d'empoisonner une source de RAG.
La plupart des vulnérabilités ne se trouvent pas dans le modèle, mais dans la manière dont on l'enveloppe.
Autrement dit, vous pouvez utiliser le LLM le plus sûr de la planète : une architecture inadaptée anéantira ses avantages. Les bots s'affaiblissent à l'échelle, car chaque nouveau composant ajoute de la complexité et de nouveaux points d'entrée.
Ce que cela signifie
Sécuriser un bot IA ne se limite pas au choix du modèle : c'est un chantier d'architecture global. Il faut protéger les system prompts contre les injections, valider les données d'entrée, contrôler les sources de RAG, limiter les droits des outils et journaliser toutes les actions. Faute de quoi, un beau LLM devient une belle faille de sécurité.
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2% à un test d'analytique sur une base 1C et devient une solution de secours en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
- 1 nov. 2026Google reconnaît que l'AI Mode réduit les revenus de la recherche, l'action chute de 15%
Questions clés sur cet article
Comment le modèle de base est protégé?
Les LLM de base suivent un solide entraînement à la sécurité : leurs concepteurs leur apprennent à refuser les requêtes dangereuses. Les équipes d'OpenAI, d'Anthropic et d'autres passent des mois à faire comprendre au modèle quelles demandes ne sont pas sûres. S'y ajoute le RLHF (apprentissage par renforcement à partir de retours humains), qui aligne le modèle sur les préférences humaines concernant ce qui est éthique ou non. Résultat : si vous demandez directement à GPT de pirater un site ou de livrer des données personnelles, il refusera.
Que sait-on sur Où les problèmes commencent ?
Mais dès que vous enveloppez le modèle dans un bot, qu'il s'agisse d'un bot Telegram, d'une application web ou d'un agent IA, vous ajoutez toute une couche de composants, chacun potentiellement risqué : System prompts : des instructions données au bot, qui écrasent parfois l'entraînement du modèle et peuvent faire l'objet d'injections Mémoire de conversation : l'historique des requêtes, qui grossit et peut servir à une attaque contextuelle RAG (Retrieval-Augmented Generation) : des bases de données et documents externes qui peuvent être pollués par de fausses données Outils
Que sait-on sur Ce qu'a montré l'analyse ?
Des chercheurs d'arXiv ont analysé 14 904 GPT personnalisés, des agents publics créés par des utilisateurs sur la plateforme d'OpenAI. Résultat : l'immense majorité est vulnérable à des attaques élémentaires sur la couche d'orchestration. L'attaquant n'a pas besoin de pirater le modèle lui-même : il lui suffit d'injecter le system prompt ou d'empoisonner une source de RAG. La plupart des vulnérabilités ne se trouvent pas dans le modèle, mais dans la manière dont on l'enveloppe. Autrement dit, vous pouvez utiliser le LLM le plus sûr de la planète : une architecture inadaptée
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.