TimeCopilot : construire un pipeline de prévision avec des modèles de fondation et une détection d'anomalies
TimeCopilot est un outil pour construire un pipeline de prévision de séries temporelles de bout en bout. Il prend en charge les modèles statistiques, les modèles de fondation et les modèles accélérés par GPU, la validation croisée glissante et les prévisions probabilistes avec intervalles de confiance. Un agent LLM intégré choisit seul le meilleur modèle pour la tâche et explique les prédictions en langage clair. Les anomalies sont signalées automatiquement.
Traité par IA depuis MarkTechPost ; édité par Hamidun News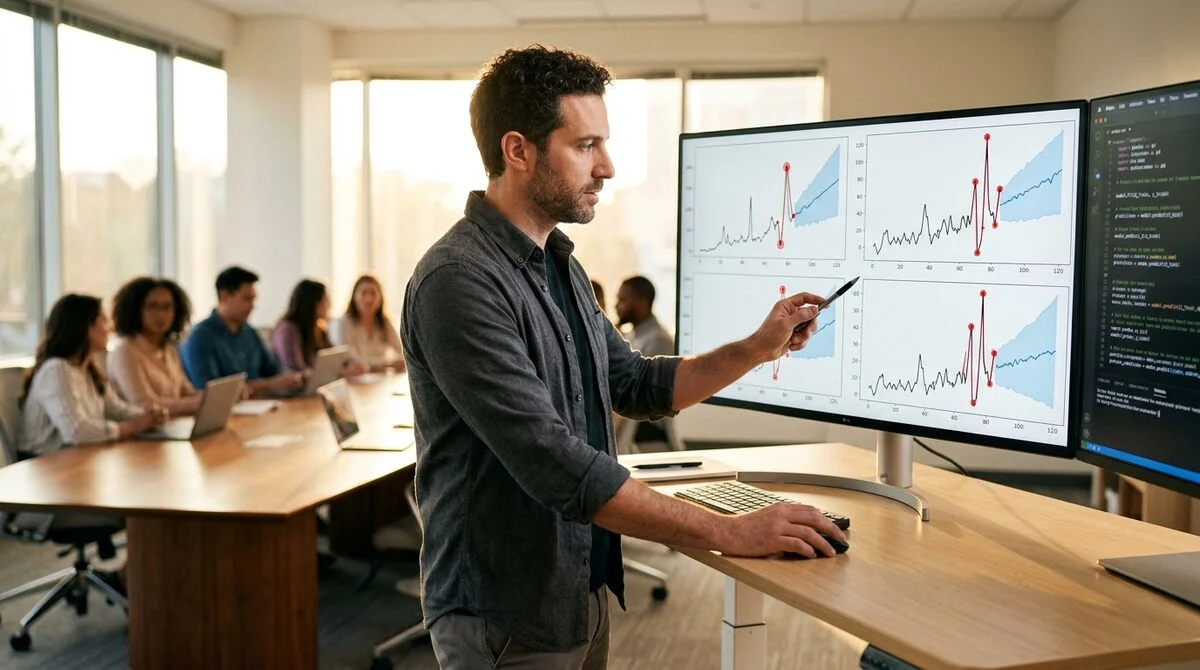
TimeCopilot est une bibliothèque Python pour construire un pipeline de prévision de séries temporelles de bout en bout. Elle réunit des méthodes statistiques classiques, des modèles de fondation préentraînés et un agent LLM optionnel qui choisit la meilleure approche et explique le résultat. La bibliothèque vise les analystes qui doivent comparer rapidement différentes approches sur des données réelles, sans perdre de temps à régler chaque modèle à la main.
Comment fonctionne le pipeline
Les auteurs présentent TimeCopilot sur deux jeux de données : un jeu réel sur le trafic de passagers des compagnies aériennes (un benchmark classique) et une série saisonnière synthétique dans laquelle des anomalies ont été insérées volontairement. Ce choix permet de tester honnêtement le système, y compris sur des données où l'on sait d'avance ce qui doit être détecté.
Le flux de travail comprend plusieurs étapes :
- Chargement et préparation de données de panel
- Entraînement des modèles par validation croisée glissante
- Évaluation selon plusieurs métriques : MAE, MAPE, RMSE
- Génération de prévisions probabilistes avec intervalles de confiance
- Détection d'anomalies avec visualisation
- Lancement d'un agent LLM pour choisir et expliquer le meilleur modèle
Trois classes de modèles
TimeCopilot prend en charge trois types de modèles, comparables au sein d'une même expérience.
Les modèles statistiques sont des méthodes classiques : ARIMA, ETS, Theta et d'autres. Ils sont faciles à interpréter, fonctionnent sur de petits jeux de données à saisonnalité marquée et ne nécessitent pas de GPU. Ils fournissent une baseline raisonnable pour presque n'importe quelle tâche.
Les modèles de fondation sont des architectures préentraînées pour les séries temporelles, formées sur de vastes corpus de données. Ils jouent pour les séquences numériques le rôle des modèles de langage : ils peuvent fonctionner out-of-the-box, sans réentraînement sur un jeu de données précis.
Les modèles accélérés par GPU sont des réseaux de neurones (par exemple N-BEATS, TiDE) destinés aux gros jeux de données et aux horizons de prévision longs. Ils sont optionnels et deviennent pertinents quand les méthodes statistiques ne suffisent plus.
L'évaluation repose sur une validation croisée glissante à fenêtre extensible : chaque modèle est entraîné sur le même historique puis testé sur l'horizon suivant. Cela révèle la vraie capacité de généralisation, et non un simple ajustement aux données d'entraînement.
Anomalies et incertitude
Au lieu d'une unique « ligne de prévision », TimeCopilot produit des prédictions probabilistes : une plage de valeurs associée à une probabilité donnée (80 % ou 95 %). Pour planifier les stocks, la charge ou le budget, c'est très utile : l'organisation voit simultanément les couloirs pessimiste et optimiste.
Un détecteur d'anomalies intégré fonctionne en parallèle de la prévision. Sur la série synthétique contenant des valeurs aberrantes artificielles, le système a correctement distingué le comportement normal du comportement atypique. Les indicateurs d'anomalie se superposent directement à la visualisation de la série, ce qui facilite l'audit et la communication des résultats au sein de l'équipe.
L'agent LLM explique son choix
La partie la plus inhabituelle est l'agent LLM optionnel. Une fois tous les modèles évalués, il examine les résultats de la validation croisée, choisit le meilleur modèle pour la série concernée et génère une explication textuelle de la raison pour laquelle ce modèle est plus précis que les autres.
«
Le modèle de fondation a surpassé ARIMA grâce à une saisonnalité non linéaire d'amplitude croissante » : l'agent produit ce type d'explication automatiquement.
C'est un pas vers un AutoML au résultat auditable : l'analyste reçoit non seulement une recommandation, mais aussi une justification qu'il peut intégrer à un rapport ou transmettre à un stakeholder sans interprétation supplémentaire.
Ce que cela change
TimeCopilot abaisse le seuil d'entrée de la prévision avancée : inutile de régler à la main des dizaines de modèles ni d'interpréter soi-même les métriques, car l'agent LLM prend une partie de ce travail en charge. Pour les équipes d'analyse qui travaillent sur des métriques métier, la demande ou des KPI opérationnels, c'est une base prête à l'emploi pour un pipeline prêt pour la production, avec une justification lisible de chaque décision.
- 2 nov. 2026DeepSeek ouvre le code d'un prototype de Super-agent : p95 du temps d'exécution de 15,7 min contre 29,5
- 2 nov. 2026Le créateur de Bun migre 750 000 lignes de Zig vers Rust en 11 jours avec Claude Code
- 2 nov. 2026Microsoft publie Mage-VL-Cowork, un modèle de 4B qui résout 66,0% des tâches d'OSWorld-Verified
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
Questions clés sur cet article
Comment fonctionne le pipeline?
Les auteurs présentent TimeCopilot sur deux jeux de données : un jeu réel sur le trafic de passagers des compagnies aériennes (un benchmark classique) et une série saisonnière synthétique dans laquelle des anomalies ont été insérées volontairement. Ce choix permet de tester honnêtement le système, y compris sur des données où l'on sait d'avance ce qui doit être détecté. Le flux de travail comprend plusieurs étapes : Chargement et préparation de données de panel Entraînement des modèles par validation croisée glissante Évaluation selon plusieurs métriques : MAE, MAPE, RMSE G
Que sait-on sur Trois classes de modèles ?
TimeCopilot prend en charge trois types de modèles, comparables au sein d'une même expérience. Les modèles statistiques sont des méthodes classiques : ARIMA, ETS, Theta et d'autres. Ils sont faciles à interpréter, fonctionnent sur de petits jeux de données à saisonnalité marquée et ne nécessitent pas de GPU. Ils fournissent une baseline raisonnable pour presque n'importe quelle tâche. Les modèles de fondation sont des architectures préentraînées pour les séries temporelles, formées sur de vastes corpus de données. Ils jouent pour les séquences numériques le rôle des modèles
Que sait-on sur Anomalies et incertitude ?
Au lieu d'une unique « ligne de prévision », TimeCopilot produit des prédictions probabilistes : une plage de valeurs associée à une probabilité donnée (80 % ou 95 %). Pour planifier les stocks, la charge ou le budget, c'est très utile : l'organisation voit simultanément les couloirs pessimiste et optimiste. Un détecteur d'anomalies intégré fonctionne en parallèle de la prévision. Sur la série synthétique contenant des valeurs aberrantes artificielles, le système a correctement distingué le comportement normal du comportement atypique. Les indicateurs d'anomalie se superpos
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.