Clustering de textes sans annotation : embeddings de LLM et HDBSCAN, selon Machine Learning Mastery
Les modèles de langage ne servent pas qu'à répondre dans un chat : ils transforment aussi le texte en vecteurs numériques qui permettent de repérer automatiquement des groupes thématiques. Machine Learning Mastery publie un guide pour combiner des embeddings de LLM avec l'algorithme HDBSCAN et regrouper des milliers de documents sans annotation. Le pipeline : embedding → UMAP (réduction de dimensionnalité) → HDBSCAN → étiquettes de thèmes automatiques.
Traité par IA depuis Machine Learning Mastery ; édité par Hamidun News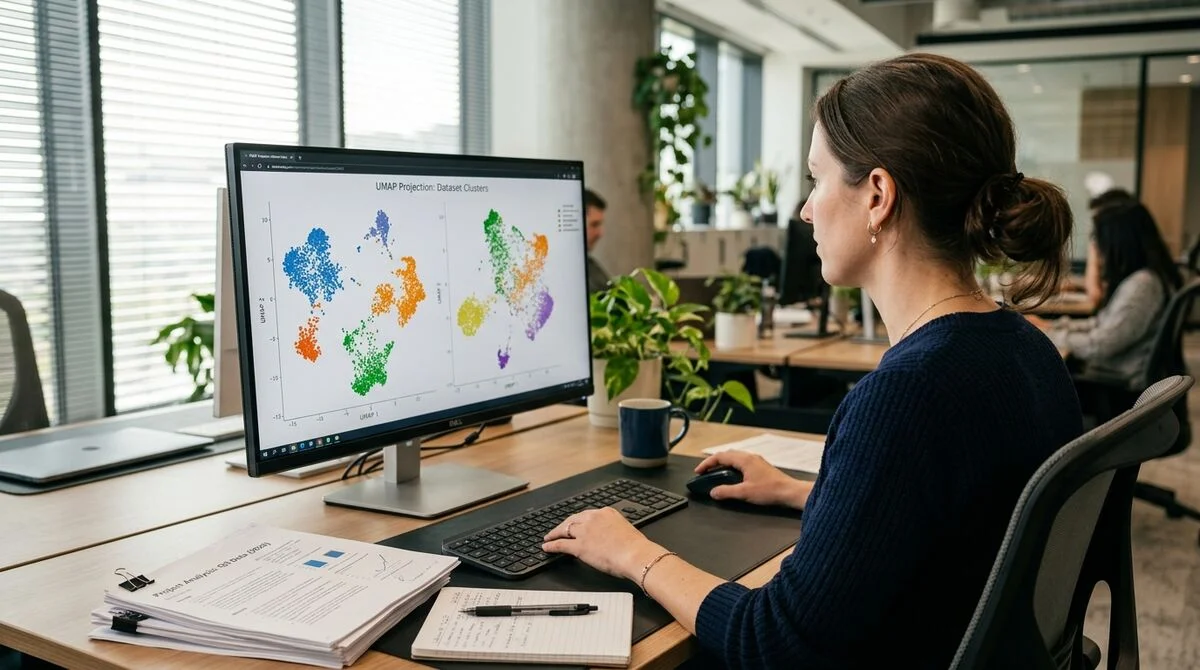
Les embeddings de LLM ont fait sortir les tâches sur texte non structuré bien au-delà des interfaces de chat. Machine Learning Mastery publie un guide pratique pour combiner les représentations vectorielles des modèles de langage avec l'algorithme HDBSCAN et trouver automatiquement des groupes thématiques dans des corpus de textes, sans annotation manuelle ni connaissance préalable de la structure des données.
Pourquoi les embeddings changent la donne
Les modèles de langage savent convertir du texte en vecteurs de grande dimension. Ce sont des représentations numériques dans lesquelles des fragments sémantiquement proches se retrouvent géométriquement voisins. « Le client est mécontent du prix » et « trop cher pour moi » seront voisins dans l'espace multidimensionnel, tandis que « problème de livraison » atterrira dans une tout autre région. C'est ce qui fait des embeddings une entrée idéale pour le clustering : le système tient compte du sens, pas de la coïncidence de mots-clés. Les dictionnaires de synonymes et les règles ne sont plus nécessaires.
Parmi les modèles courants pour produire des embeddings, on trouve `text-embedding-3-small` d'OpenAI, Cohere Embed v3 et les sentence-transformers open source, qui tournent en local sans frais d'API. Un embedding typique compte de 768 à 3072 dimensions, ce qui est trop pour un clustering direct. Avant HDBSCAN, on applique généralement UMAP, qui comprime l'espace à 5–50 dimensions. Sans cette étape, l'algorithme se heurte au « fléau de la dimension » : dans un espace de grande dimension, tous les points semblent à peu près équidistants, et les clusters ne se forment pas.
HDBSCAN face aux méthodes classiques
La plupart des cours de clustering commencent par K-means. Le problème : il impose de fixer à l'avance le nombre de clusters, ce qui est impossible quand la structure des données est inconnue. HDBSCAN (Hierarchical Density-Based Spatial Clustering of Applications with Noise) aborde la tâche autrement :
- Ne demande pas de fixer le nombre de clusters à l'avance
- Marque automatiquement les points de « bruit » : les textes qui n'entrent dans aucun groupe
- Gère correctement des clusters de tailles et de densités différentes
- Passe à l'échelle sur des dizaines de milliers de documents
- Fournit une hiérarchie de clusters au niveau de détail réglable
Le pipeline complet : embeddings → réduction de dimensionnalité via UMAP → HDBSCAN → étiquettes de clusters. L'ensemble du code tient en quelques dizaines de lignes de Python avec les bibliothèques `sentence-transformers`, `umap-learn` et `hdbscan`. Pour interpréter les thèmes trouvés, il suffit de renvoyer quelques exemples de chaque groupe à un LLM et de lui demander de proposer un nom. La boucle se referme du modèle de langage vers les statistiques, puis retour au modèle.
Une utilisation sans jeu d'entraînement
Le principal atout de cette combinaison est qu'elle n'exige aucune annotation. Pas besoin de s'accorder sur des catégories, d'embaucher des annotateurs ni de constituer un jeu d'entraînement. Un seul pipeline découvre la structure par lui-même.
« L'ère actuelle de l'IA générative se concentre sur les interfaces de chat, mais les capacités des modèles de langage vont bien au-delà », écrivent les auteurs de
Machine Learning Mastery.
Les cas d'usage typiques : regrouper des milliers de demandes de support, classer automatiquement des flux d'actualités, regrouper des avis sur un produit, analyser les questions ouvertes d'enquêtes, détecter des schémas anormaux dans des logs. Le résultat arrive en quelques minutes, sans annotation préalable.
L'approche est particulièrement utile avec des données qui évoluent vite : les nouveaux thèmes sont détectés automatiquement, sans qu'il faille ajouter des classes à la main dans un classifieur à chaque évolution du domaine.
Ce que cela signifie
L'association d'embeddings de LLM et de HDBSCAN offre un outil prêt à l'emploi pour structurer de grands jeux de données textuelles sans supervision. Des tâches qui exigeaient autrefois des semaines de travail manuel ou une annotation coûteuse se règlent désormais avec un petit script. Pour les équipes qui travaillent sur les retours utilisateurs, la veille médiatique ou l'analyse de contenu, c'est une économie de ressources directe, et la possibilité de tirer des enseignements de données qui dormaient jusque-là.
- 2 nov. 2026L'assistant Muse de Meta tient un dossier sur vos proches et obtient root par défaut sous Ubuntu
- 1 nov. 2026Les modèles locaux battus par Opus et Codex : 0,21 sur MacBook contre 1,00 pour Codex
- 1 nov. 2026Kimi obtient 96,2 % à un test d'analytique sur une base 1C et s'impose comme solution de repli en cas de blocage de Claude
- 1 nov. 2026OpenAI réécrit les règles de comportement de GPT : cinq valeurs et une chaîne de priorités
Questions clés sur cet article
Pourquoi les embeddings changent la donne?
Les modèles de langage savent convertir du texte en vecteurs de grande dimension. Ce sont des représentations numériques dans lesquelles des fragments sémantiquement proches se retrouvent géométriquement voisins. « Le client est mécontent du prix » et « trop cher pour moi » seront voisins dans l'espace multidimensionnel, tandis que « problème de livraison » atterrira dans une tout autre région. C'est ce qui fait des embeddings une entrée idéale pour le clustering : le système tient compte du sens, pas de la coïncidence de mots-clés. Les dictionnaires de synonymes et les règ
Que sait-on sur HDBSCAN face aux méthodes classiques ?
La plupart des cours de clustering commencent par K-means. Le problème : il impose de fixer à l'avance le nombre de clusters, ce qui est impossible quand la structure des données est inconnue. HDBSCAN (Hierarchical Density-Based Spatial Clustering of Applications with Noise) aborde la tâche autrement : Ne demande pas de fixer le nombre de clusters à l'avance Marque automatiquement les points de « bruit » : les textes qui n'entrent dans aucun groupe Gère correctement des clusters de tailles et de densités différentes Passe à l'échelle sur des dizaines de milliers de document
Que sait-on sur Une utilisation sans jeu d'entraînement ?
Le principal atout de cette combinaison est qu'elle n'exige aucune annotation. Pas besoin de s'accorder sur des catégories, d'embaucher des annotateurs ni de constituer un jeu d'entraînement. Un seul pipeline découvre la structure par lui-même. « L'ère actuelle de l'IA générative se concentre sur les interfaces de chat, mais les capacités des modèles de langage vont bien au-delà », écrivent les auteurs de Machine Learning Mastery. Les cas d'usage typiques : regrouper des milliers de demandes de support, classer automatiquement des flux d'actualités, regrouper des avis sur u
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.