Machine Learning Mastery explique comment bâtir un RAG à contexte long sans gaspiller de tokens
Machine Learning Mastery a publié un guide utile sur le RAG à contexte long. Même les modèles dotés de fenêtres de contexte immenses butent sur deux problèmes : l'effet Lost in the Middle et le coût élevé du traitement. L'article propose cinq techniques pratiques, du reranking et du context caching à la recherche hybride et à la query expansion, pour obtenir des réponses plus précises et un pipeline moins cher et plus rapide.
Traité par IA depuis Machine Learning Mastery ; édité par Hamidun News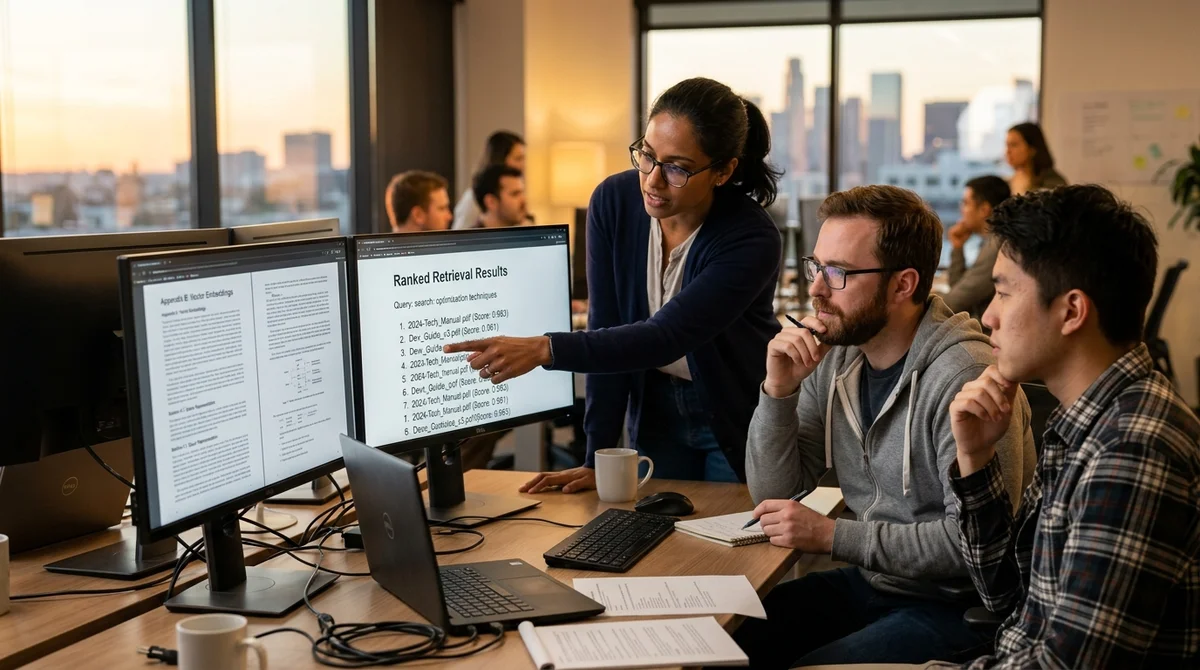
Le 15 avril 2026, Machine Learning Mastery a publié un guide pratique sur la manière de construire un RAG à contexte long sans gaspiller de tokens et sans dégrader la qualité des réponses. La conclusion principale de l'article est simple : même les modèles dotés de fenêtres de plusieurs centaines de milliers, voire de millions de tokens, n'enterrent pas le RAG, mais obligent à en repenser l'architecture.
Pourquoi un contexte long ne suffit pas
Il n'y a pas si longtemps, le conseil standard pour le RAG était de découper les documents en petits morceaux, de les transformer en embeddings et de récupérer les fragments les plus pertinents. Cela découlait des limites des LLM eux-mêmes : le contexte coûtait cher et s'épuisait vite. Les développeurs disposent désormais de modèles à fenêtre d'un million de tokens, et la tentation est évidente : charger tout simplement dans le prompt l'ensemble du règlement, toutes les instructions ou la base de connaissances entière.
En pratique, cette approche se heurte vite à deux problèmes. Le premier est l'effet Lost in the Middle : le modèle repère moins bien une information importante lorsqu'elle est noyée au milieu d'un long contexte. Le second est le coût : faire passer un énorme volume de texte dans le modèle à chaque requête est lent et cher.
Au final, le RAG à contexte long n'est plus un problème de type « comment faire entrer le plus de texte possible », mais « comment donner au modèle exactement le contexte auquel il prêtera réellement attention ».
Cinq techniques qui fonctionnent
Machine Learning Mastery ne propose pas une solution miracle, mais un ensemble de méthodes pratiques qui peuvent se combiner dans un même pipeline. L'idée est de ne pas se contenter de chercher des documents, mais de maîtriser l'ordre, le volume et la manière de fournir le contexte au modèle. C'est un changement notable par rapport à l'ancienne approche du RAG, où les morceaux trouvés après le retrieval partaient presque automatiquement dans le prompt, sans logique supplémentaire ni contrôle de qualité à chaque étape.
- Reranking après le retrieval : récupérer d'abord un ensemble élargi de candidats, puis les reclasser avec un modèle distinct.
- Context caching : charger une seule fois un gros document dans le cache, puis ne transmettre au modèle que la question et une référence à ce contexte.
- Dynamic chunking + metadata filters : découper les documents en blocs cohérents et les filtrer par section, date, page et autres métadonnées.
- Hybrid retrieval : combiner la recherche sémantique et la recherche exacte par mots-clés, afin de ne pas perdre les correspondances littérales dans les requêtes techniques.
- Query expansion : enrichir la question initiale de formulations supplémentaires si l'utilisateur l'a posée de façon trop générale ou trop familière.
La partie la plus intéressante n'est pas la liste elle-même, mais la façon dont les techniques s'articulent. Par exemple, l'article recommande de récupérer dans la base vectorielle non pas le top 5, mais, disons, le top 20 des candidats, de les passer dans un reranker, puis seulement ensuite de placer les meilleurs documents dans le prompt de façon stratégique : le plus pertinent au début, le deuxième en importance à la fin, les autres entre les deux. Le développeur ne lutte ainsi pas contre les limites de l'attention du modèle, il s'y adapte.
Comment le pipeline évolue
L'article montre bien que le RAG moderne pour contexte long se rapproche davantage de l'ingénierie de la recherche que du simple « retrieve-and-dump ». Si vous disposez d'une base de connaissances statique, comme un manuel volumineux ou un règlement interne, le context caching supprime le retraitement de centaines de milliers de tokens et réduit nettement la latence. C'est particulièrement utile pour les chatbots de support et les assistants internes, qui répondent sans cesse à partir du même corpus de documents.
Une autre couche importante concerne les métadonnées et la recherche hybride. Le retrieval sémantique comprend bien le sens, mais il peut passer à côté du nom exact d'un paramètre, d'un code d'erreur ou d'un numéro de section. La recherche par mots-clés, à l'inverse, s'accroche aux correspondances littérales. L'auteur conseille donc de combiner les deux canaux et de fusionner leurs résultats par rank fusion. Par-dessus s'ajoute un filtrage selon la structure du document : on écarte d'abord les sections, dates ou pages inutiles, et ce n'est qu'ensuite que l'on lance la similarity search. Cela réduit le bruit et rend le contexte final nettement plus propre.
Enfin, la query expansion aide lorsque l'utilisateur formule sa question autrement que l'information n'est rédigée dans les documents. Si quelqu'un demande « que faire si l'alarme incendie se déclenche », le système peut générer en plus des variantes comme « procédure d'évacuation », « point de rassemblement » ou « sortie de secours ». Le retrieval trouve ainsi non seulement les correspondances directes, mais aussi des instructions proches par le sens. C'est particulièrement précieux pour les connaissances d'entreprise, les documents de compliance et la documentation technique.
Ce que cela signifie
L'article de Machine Learning Mastery acte un changement important : les modèles à contexte long n'ont pas tué le RAG, ils l'ont fait mûrir. Ce ne sont plus les équipes qui chargent un maximum de texte dans le prompt qui l'emportent, mais celles qui savent classer, filtrer, mettre en cache et réutiliser le contexte avec discernement. Pour les équipes produit, cela signifie moins de dépenses en tokens, une latence plus basse et des réponses plus prévisibles sur de longs corpus de documents. C'est ce qui devient la nouvelle norme pour les assistants IA d'entreprise.
Questions clés sur cet article
Pourquoi un contexte long ne suffit pas?
Il n'y a pas si longtemps, le conseil standard pour le RAG était de découper les documents en petits morceaux, de les transformer en embeddings et de récupérer les fragments les plus pertinents. Cela découlait des limites des LLM eux-mêmes : le contexte coûtait cher et s'épuisait vite. Les développeurs disposent désormais de modèles à fenêtre d'un million de tokens, et la tentation est évidente : charger tout simplement dans le prompt l'ensemble du règlement, toutes les instructions ou la base de connaissances entière. En pratique, cette approche se heurte vite à deux probl
Que sait-on sur Cinq techniques qui fonctionnent ?
Machine Learning Mastery ne propose pas une solution miracle, mais un ensemble de méthodes pratiques qui peuvent se combiner dans un même pipeline. L'idée est de ne pas se contenter de chercher des documents, mais de maîtriser l'ordre, le volume et la manière de fournir le contexte au modèle. C'est un changement notable par rapport à l'ancienne approche du RAG, où les morceaux trouvés après le retrieval partaient presque automatiquement dans le prompt, sans logique supplémentaire ni contrôle de qualité à chaque étape. Reranking après le retrieval : récupérer d'abord un ense
Comment le pipeline évolue?
L'article montre bien que le RAG moderne pour contexte long se rapproche davantage de l'ingénierie de la recherche que du simple « retrieve-and-dump ». Si vous disposez d'une base de connaissances statique, comme un manuel volumineux ou un règlement interne, le context caching supprime le retraitement de centaines de milliers de tokens et réduit nettement la latence. C'est particulièrement utile pour les chatbots de support et les assistants internes, qui répondent sans cesse à partir du même corpus de documents. Une autre couche importante concerne les métadonnées et la re
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
L'essentiel de l'IA — une fois par semaine
Sept actus qui ont vraiment compté, choisies à la main. Sans bruit ni communiqués.
C'est fait ! Vérifiez votre boîte mail pour la confirmation.