Nvidia explica cómo funciona DLSS 5: le bastan un fotograma 2D y vectores de movimiento
Nvidia ha dado más detalles sobre cómo funciona DLSS 5. Según Jacob Freeman, el sistema no recibe una escena 3D completa, sino un fotograma 2D ya renderizado por el juego y vectores de movimiento. Esto explica por qué la calidad del escalado no depende solo del modelo, sino también de lo cuidadosamente que el juego transmita los datos sobre el movimiento de los objetos. Dicho de forma sencilla, DLSS no dibuja la imagen de la nada, sino que la reconstruye a partir de un conjunto de datos de entrada limitado pero estructurado.
Procesado por IA desde 3DNews AI; editado por Hamidun News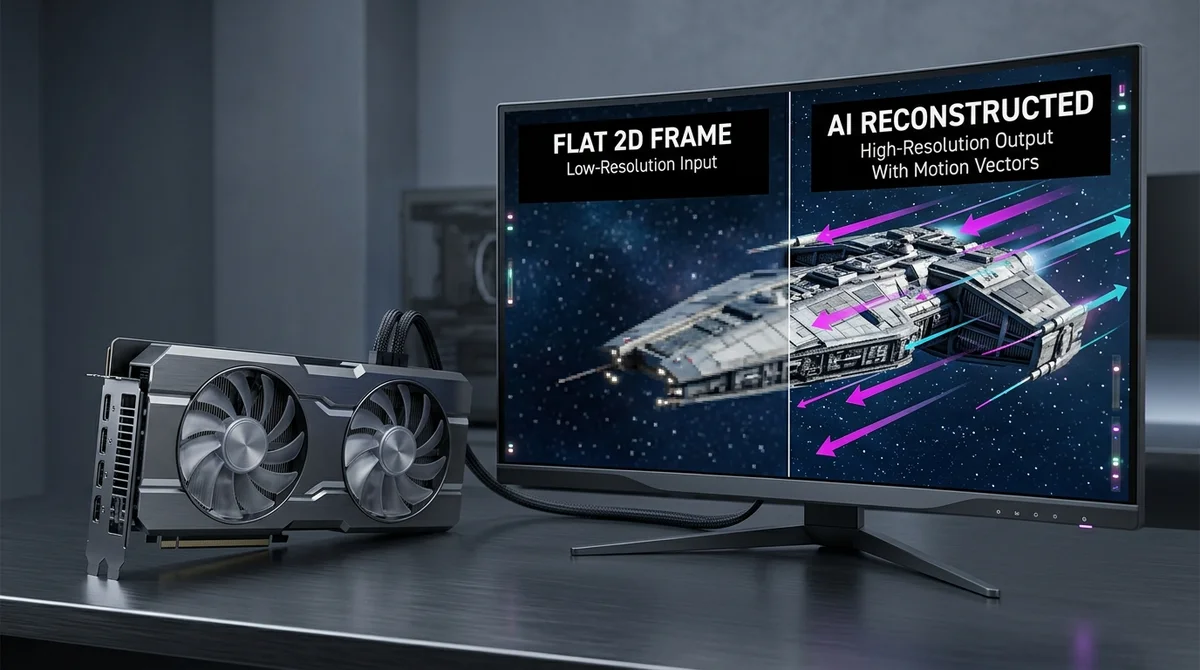
Nvidia ha abierto un poco la caja negra de DLSS 5. Según Jacob Freeman, el sistema no recibe una escena 3D completa. Como entrada, le llegan un fotograma 2D normal, ya renderizado por el juego, y los vectores de movimiento de los objetos.
Qué recibe DLSS
La aclaración importa en todos los debates sobre cómo "dibuja" exactamente el escalado con IA los píxeles que faltan. Mucha gente imagina DLSS como un modelo que ve todo el mundo del juego casi como lo ve el motor. En la práctica, el esquema es mucho más compacto. El juego renderiza primero un fotograma a una resolución más baja y luego se lo pasa a DLSS junto con un mapa de movimiento que indica cómo se desplazan los objetos y las distintas zonas de la imagen de un fotograma a otro. Sobre esa base, la red neuronal reconstruye una imagen más detallada.
Este enfoque explica por qué la tecnología puede mejorar de forma notable la nitidez sin recalcular la escena a resolución nativa. El modelo no necesita reconstruir desde cero la geometría del mundo ni acceder a todos los datos internos del motor. Funciona como un sistema de reconstrucción: busca patrones, compara el fotograma actual con el movimiento de los elementos y predice cómo debe verse el resultado final a mayor resolución. Por eso DLSS sigue ligado no solo a la propia red neuronal, sino también a lo cuidadosamente que el juego prepara los datos de partida.
«DLSS 5 recibe como entrada un fotograma 2D y vectores de movimiento».
Para qué sirven los vectores
Los vectores de movimiento son la pieza clave de este esquema. Indican hacia dónde y a qué velocidad se mueven los objetos entre fotogramas contiguos. Sin ellos, la IA tendría que adivinar casi a ciegas dónde debe quedar la mano de un personaje, hacia dónde se ha desplazado una sombra o cómo continuar una línea fina en un objeto que se mueve rápido. Cuanto más precisos son estos datos, más estable se ve la imagen en movimiento, ya sea cuando el jugador gira la cámara, conduce a gran velocidad o participa en un tiroteo con muchos efectos en pantalla.
En la práctica, esto aporta varias ventajas notables:
- mayor nitidez en los detalles pequeños sin un renderizado completo a resolución nativa
- menos parpadeo en líneas finas, cables, hierba y objetos lejanos
- una imagen más estable en movimiento, y no solo en una captura estática
- una mejora de rendimiento, porque el juego no tiene que calcular cada píxel a la máxima calidad
De ahí se deduce también la dependencia inversa: si el juego genera mal los vectores de movimiento, el resultado final también se resiente. Por eso la calidad de DLSS no la determina un único modelo "mágico" de Nvidia, sino la combinación de algoritmo, motor e implementación concreta en cada juego.
Dónde están los límites del método
La explicación de Nvidia es útil también porque marca los límites de las expectativas. DLSS 5 no "conoce" la escena como la conoce el propio motor del juego. No recibe un modelo tridimensional del mundo ya hecho y en su totalidad, así que en cualquier situación compleja se apoya en información incompleta, aunque muy útil.
De ahí los artefactos típicos que conocen los usuarios de las tecnologías de reconstrucción: difuminado de elementos pequeños, estelas en los bordes con contraste o inestabilidad en fotogramas con movimiento muy complejo, transparencias y muchos efectos pequeños.
Aun así, conviene no confundir reconstrucción con dibujar al azar. El sentido de DLSS es justamente que el sistema se apoya en datos reales del juego y no se limita a "fantasear" sobre la imagen. Pero la explicación de Freeman muestra que incluso la IA más potente depende aquí de la calidad del fotograma original y de la telemetría auxiliar. En otras palabras, DLSS 5 no es un botón de "hacerlo bonito a partir de la nada", sino un compromiso avanzado entre rendimiento y calidad visual.
Qué significa
Para jugadores y desarrolladores, es una señal útil: la principal fuerza de DLSS 5 no está en acceder a una supuesta magia 3D oculta, sino en saber restaurar la imagen con la mayor eficacia posible a partir de un conjunto limitado de datos. Cuanto mejor prepare el juego el fotograma y los vectores de movimiento, más convincente será el resultado. Eso significa que la carrera por la calidad de los gráficos con IA depende cada vez más no solo del modelo de Nvidia, sino también de la disciplina de los propios estudios al integrar la tecnología.
- 2 nov 2026Anthropic debe aumentar sus ingresos un 32% al año para cubrir contratos por $850 mil millones
- 2 nov 2026TensorFold 1.2.0 aumenta un 44,2% el rendimiento de Qwen3.8-27B en el M3 Ultra con 16 flujos
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Un autor de Habr ajusta YOLOv8l con radiografías dentales y lleva el mAP50 a 0,642
Preguntas frecuentes sobre la noticia
¿Qué se sabe sobre Qué recibe DLSS?
La aclaración importa en todos los debates sobre cómo "dibuja" exactamente el escalado con IA los píxeles que faltan. Mucha gente imagina DLSS como un modelo que ve todo el mundo del juego casi como lo ve el motor. En la práctica, el esquema es mucho más compacto. El juego renderiza primero un fotograma a una resolución más baja y luego se lo pasa a DLSS junto con un mapa de movimiento que indica cómo se desplazan los objetos y las distintas zonas de la imagen de un fotograma a otro. Sobre esa base, la red neuronal reconstruye una imagen más detallada. Este enfoque explica
¿Qué se sabe sobre Para qué sirven los vectores?
Los vectores de movimiento son la pieza clave de este esquema. Indican hacia dónde y a qué velocidad se mueven los objetos entre fotogramas contiguos. Sin ellos, la IA tendría que adivinar casi a ciegas dónde debe quedar la mano de un personaje, hacia dónde se ha desplazado una sombra o cómo continuar una línea fina en un objeto que se mueve rápido. Cuanto más precisos son estos datos, más estable se ve la imagen en movimiento, ya sea cuando el jugador gira la cámara, conduce a gran velocidad o participa en un tiroteo con muchos efectos en pantalla. En la práctica, esto apo
Dónde están los límites del método?
La explicación de Nvidia es útil también porque marca los límites de las expectativas. DLSS 5 no "conoce" la escena como la conoce el propio motor del juego. No recibe un modelo tridimensional del mundo ya hecho y en su totalidad, así que en cualquier situación compleja se apoya en información incompleta, aunque muy útil. De ahí los artefactos típicos que conocen los usuarios de las tecnologías de reconstrucción: difuminado de elementos pequeños, estelas en los bordes con contraste o inestabilidad en fotogramas con movimiento muy complejo, transparencias y muchos efectos pe
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.