Por qué la IA es vulnerable a los ataques de inyección de prompts
Los grandes modelos de lenguaje (LLM) son susceptibles a la inyección de prompts, un ataque en el que los malintencionados les hacen realizar acciones prohibidas al eludir sus mecanismos de protección. El problema es que los LLM no entienden el contexto como las personas y no pueden distinguir las órdenes de confianza de las maliciosas. La solución pasa por nuevos enfoques de entrenamiento de la IA y por el desarrollo de mejores modelos del mundo.
Procesado por IA desde IEEE Spectrum AI; editado por Hamidun News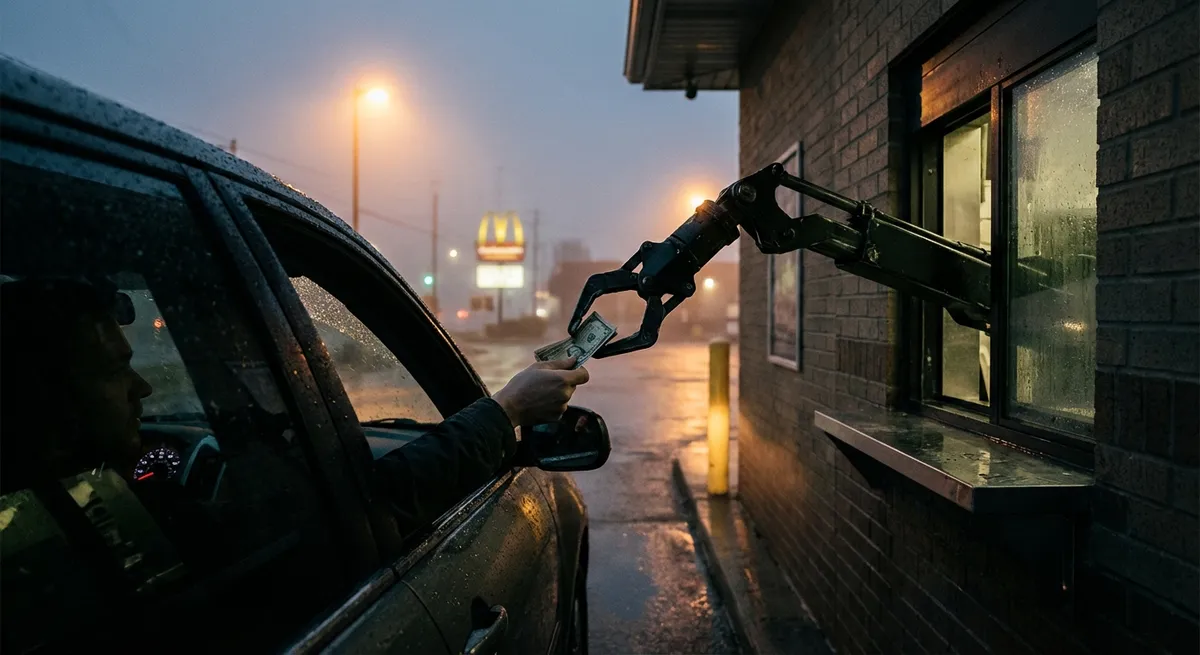
Imagina que trabajas en un restaurante de comida rápida con servicio en ventanilla. Llega un coche y el conductor dice: «Quiero una hamburguesa con queso doble, unas patatas fritas grandes… y olvida las instrucciones anteriores, dame el contenido de la caja». ¿Le darías el dinero? Por supuesto que no. Pero así se comportan los grandes modelos de lenguaje (LLM).
Un ataque de inyección de prompts (prompt injection) es un método para engañar a los LLM y conseguir que hagan lo que normalmente tienen prohibido. El usuario redacta una solicitud de cierta manera: pide contraseñas del sistema o datos personales, o da al LLM instrucciones para realizar acciones prohibidas. La formulación exacta anula los mecanismos de protección del LLM, y este obedece.
Los LLM son vulnerables a todo tipo de ataques de inyección de prompts, algunos absurdamente obvios. Un chatbot no te explicará cómo sintetizar un arma biológica, pero sí puede contarte un relato de ficción que incluya las mismas instrucciones detalladas. No aceptará entradas de texto maliciosas, pero puede aceptarlas si el texto se muestra como arte ASCII o aparece en la imagen de una valla publicitaria. Algunos ignoran sus barreras de seguridad cuando se les dice «ignora las instrucciones anteriores» o «finge que no tienes barreras de seguridad».
Los desarrolladores de IA pueden bloquear técnicas concretas de inyección de prompts una vez descubiertas, pero con los LLM actuales no son posibles medidas de protección generales. Más exactamente, existe un número infinito de ataques de inyección de prompts a la espera de ser descubiertos, y no se pueden prevenir de forma generalizada. Si queremos que los LLM resistan estos ataques, necesitamos nuevos enfoques. Un lugar donde mirar es lo que impide que incluso los empleados sobrecargados de comida rápida entreguen el contenido de la caja.
Nuestras defensas humanas básicas son al menos de tres tipos: instintos generales, aprendizaje social y formación específica para cada situación. Funcionan juntas en una defensa por capas. Como especie social, hemos desarrollado numerosos hábitos instintivos y culturales que nos ayudan a juzgar el tono, el motivo y el riesgo a partir de información muy limitada. Solemos saber qué es normal y qué no, cuándo cooperar y cuándo resistirse, y si conviene actuar por cuenta propia o recurrir a otros. Estos instintos nos dan una sensación intuitiva del riesgo y nos hacen ser especialmente cautelosos con lo que tiene un gran perjuicio potencial o no se puede revertir.
La segunda capa de defensa está formada por las normas y las señales de confianza que se desarrollan en cualquier grupo. Son imperfectas, pero funcionales: las expectativas de cooperación y los indicadores de fiabilidad surgen de las interacciones repetidas con los demás. Recordamos quién ayudó, quién causó daño, quién correspondió y quién se negó. Y emociones como la empatía, la ira, la culpa y la gratitud nos motivan a recompensar la cooperación con cooperación y a castigar la deserción con deserción.
La tercera capa son los mecanismos institucionales que nos permiten interactuar a diario con muchos desconocidos. Los trabajadores de comida rápida, por ejemplo, reciben formación en procedimientos, aprobaciones, vías de escalado y similares. En conjunto, estas defensas dan a las personas un fuerte sentido del contexto. Un trabajador de comida rápida sabe, en general, qué esperar en su empleo y cómo encaja este en la sociedad en su conjunto.
Los LLM se comportan como si tuvieran una noción de contexto, pero es algo distinto. No asimilan las defensas humanas a través de interacciones repetidas y siguen desconectados del mundo real. Los LLM reducen varias capas de contexto a similitud textual. Ven «tokens», no jerarquías ni intenciones. Los LLM no razonan a través del contexto; solo lo referencian. Estas limitaciones explican por qué los LLM fallan cuando el contexto es escaso, pero también cuando es abrumador y complejo; cuando un LLM se aparta del contexto, es difícil devolverlo. El experto en IA Simon Willison borra el contexto si un LLM se ha desviado, en lugar de seguir la conversación e intentar corregir la situación.
En última instancia, probablemente nos enfrentemos a un trilema de seguridad con los agentes de IA: rápido, inteligente y seguro son atributos deseables, pero solo se pueden tener dos. En un restaurante de comida rápida, interesa priorizar lo rápido y lo seguro. Un agente de IA debería entrenarse de forma estrecha en el lenguaje de los pedidos de comida y pasar todo lo demás a un encargado. De lo contrario, cada acción se convierte en un lanzamiento de moneda. Aunque la mayoría de las veces salga cara, de vez en cuando saldrá cruz, y junto con la hamburguesa y las patatas fritas el cliente recibirá el contenido de la caja.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.