Por qué los bots basados en LLM protegidos se hackean con frecuencia: análisis de 14.000 GPT
Los LLM base están protegidos contra ataques, pero los bots construidos sobre ellos son vulnerables. El culpable es la capa de orquestación: system prompts, RAG, herramientas y webhooks. El análisis de 14.904 GPT personalizados mostró que esta arquitectura por capas se convierte en el punto débil frente a los atacantes.
Procesado por IA desde Habr AI; editado por Hamidun News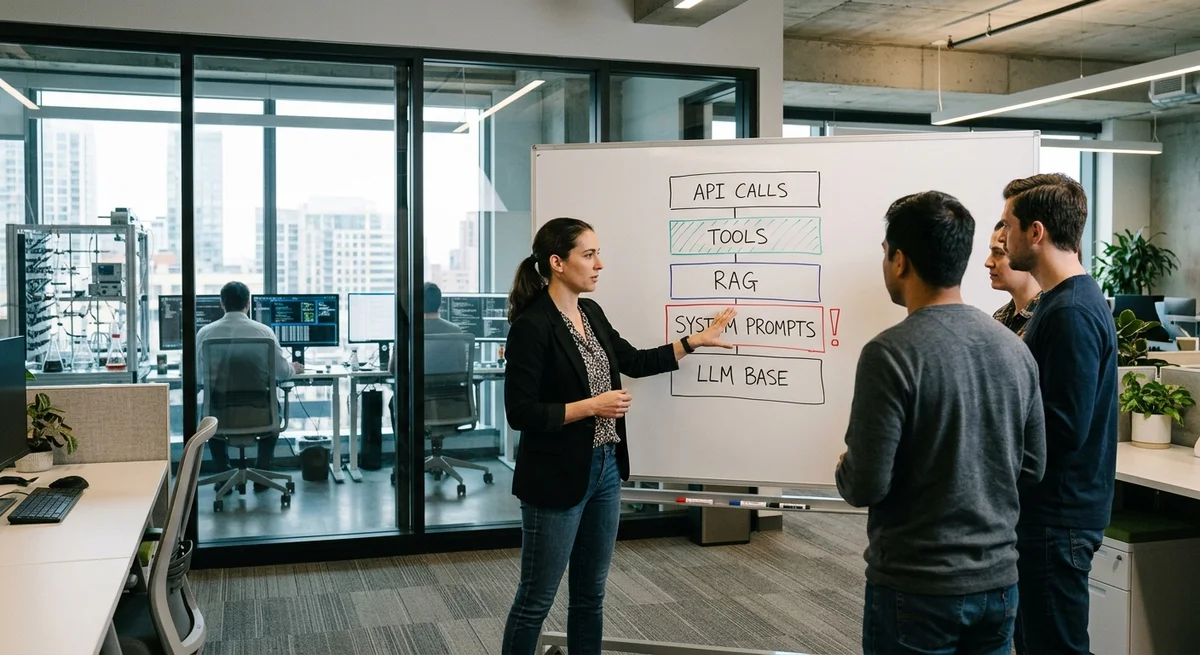
Un LLM base seguro no garantiza un bot seguro. ¿Una paradoja? No, es simplemente arquitectura. Cuando se toma un modelo protegido como GPT o Claude y se envuelve en un system prompt, y además se añaden RAG, herramientas y API, aparece una nueva superficie de ataque. Se la conoce como capa de orquestación (orchestration layer), y es ahí donde se hackean bots cuyo modelo sí está protegido.
Cómo se protege el modelo base
Los LLM base pasan por un entrenamiento de seguridad exigente: sus autores les enseñan a rechazar peticiones peligrosas. Los equipos de OpenAI, Anthropic y otras empresas dedican meses a que el modelo entienda qué solicitudes no son seguras. Además se aplica RLHF (aprendizaje por refuerzo a partir de retroalimentación humana), que alinea el modelo con las preferencias humanas sobre lo que es ético y lo que no. El resultado: si le pides directamente a GPT que hackee un sitio web o que entregue datos personales, se negará.
Dónde empiezan los problemas
Pero en cuanto envuelves el modelo en un bot, ya sea de Telegram, una aplicación web o un agente de IA, se añade toda una capa de componentes, cada uno potencialmente inseguro:
- System prompts: instrucciones al bot que a veces anulan el entrenamiento del modelo y pueden ser objeto de inyección
- Memoria de conversación: el historial de peticiones, que crece y puede usarse para un ataque contextual
- RAG (Retrieval-Augmented Generation): bases de datos y documentos externos que pueden contaminarse con datos falsos
- Herramientas y llamadas a funciones: acceso directo a API, correo, bases de datos y sistemas de pago
- Lógica de webhooks y servicios externos: fuentes de datos no confiables que pueden verse comprometidas
Cada capa añade un nuevo vector de ataque. Un system prompt puede sufrir una inyección a través de la entrada del usuario. La memoria de conversación puede saturarse de patrones de prompt injection. RAG puede devolver datos envenenados de una fuente comprometida. Las herramientas pueden usarse para eludir las restricciones del modelo.
Qué mostró el análisis
Investigadores publicados en arXiv analizaron 14.904 GPT personalizados, agentes públicos creados por usuarios en la plataforma de OpenAI. El resultado: la inmensa mayoría es vulnerable a ataques básicos contra la capa de orquestación. El atacante no necesita hackear el modelo; le basta con inyectar el system prompt o envenenar una fuente de RAG.
La mayoría de las vulnerabilidades no están en el modelo, sino en cómo se lo envuelve.
Es decir, puedes usar el LLM más seguro del planeta, pero una arquitectura incorrecta anulará sus ventajas. Los bots se debilitan al escalar, porque cada componente nuevo añade complejidad y nuevos puntos de entrada.
Qué significa esto
La seguridad de un bot de IA no consiste solo en elegir el modelo; es una tarea de arquitectura integral. Hay que proteger los system prompts frente a inyecciones, validar los datos de entrada, controlar las fuentes de RAG, limitar los permisos de las herramientas y registrar todas las acciones. De lo contrario, un LLM brillante se convierte en una brillante brecha de seguridad.
- 1 nov 2026Los modelos locales pierden ante Opus y Codex: 0,21 puntos en un MacBook frente a 1,00 de Codex
- 1 nov 2026Kimi logra un 96,2% en una prueba de analítica sobre una base de 1C y se perfila como plan B ante un bloqueo de Claude
- 1 nov 2026OpenAI reescribe las reglas de comportamiento de GPT: cinco valores y una cadena de prioridades
- 1 nov 2026Google admite que AI Mode reduce los ingresos de su buscador: las acciones caen un 15%
Preguntas frecuentes sobre la noticia
Cómo se protege el modelo base?
Los LLM base pasan por un entrenamiento de seguridad exigente: sus autores les enseñan a rechazar peticiones peligrosas. Los equipos de OpenAI, Anthropic y otras empresas dedican meses a que el modelo entienda qué solicitudes no son seguras. Además se aplica RLHF (aprendizaje por refuerzo a partir de retroalimentación humana), que alinea el modelo con las preferencias humanas sobre lo que es ético y lo que no. El resultado: si le pides directamente a GPT que hackee un sitio web o que entregue datos personales, se negará.
Dónde empiezan los problemas?
Pero en cuanto envuelves el modelo en un bot, ya sea de Telegram, una aplicación web o un agente de IA, se añade toda una capa de componentes, cada uno potencialmente inseguro: System prompts: instrucciones al bot que a veces anulan el entrenamiento del modelo y pueden ser objeto de inyección Memoria de conversación: el historial de peticiones, que crece y puede usarse para un ataque contextual RAG (Retrieval-Augmented Generation): bases de datos y documentos externos que pueden contaminarse con datos falsos Herramientas y llamadas a funciones: acceso directo a API, correo,
¿Qué se sabe sobre Qué mostró el análisis?
Investigadores publicados en arXiv analizaron 14.904 GPT personalizados, agentes públicos creados por usuarios en la plataforma de OpenAI. El resultado: la inmensa mayoría es vulnerable a ataques básicos contra la capa de orquestación. El atacante no necesita hackear el modelo; le basta con inyectar el system prompt o envenenar una fuente de RAG. La mayoría de las vulnerabilidades no están en el modelo, sino en cómo se lo envuelve. Es decir, puedes usar el LLM más seguro del planeta, pero una arquitectura incorrecta anulará sus ventajas. Los bots se debilitan al escalar, po
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
Lo esencial de la IA — una vez por semana
Siete historias que de verdad importaron, elegidas a mano. Sin ruido ni notas de prensa.
¡Listo! Revisa tu correo para la confirmación.