MarkTechPost
مصدر أخبار الذكاء الاصطناعي. تُختار المقالات وتُعدَّل من قِبَل تحرير Hamidun News.
أحدث المنشورات
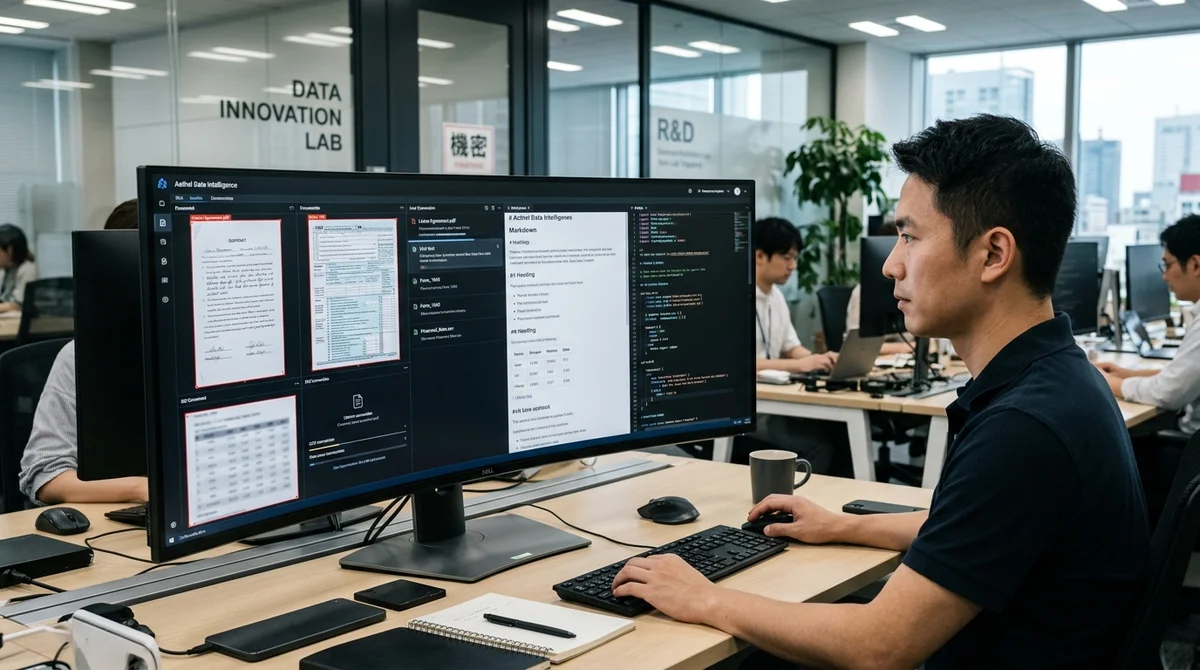
Baidu تطلق Qianfan-OCR: نموذج بحجم 4B للتعرف على المستندات وفهمها
كشفت Baidu عن Qianfan-OCR، وهو نموذج موحد بحجم 4B يحلل بنية المستند ويتعرف على النص، ويستخرج الجداول أو يجيب عن الأسئلة عند الطلب.
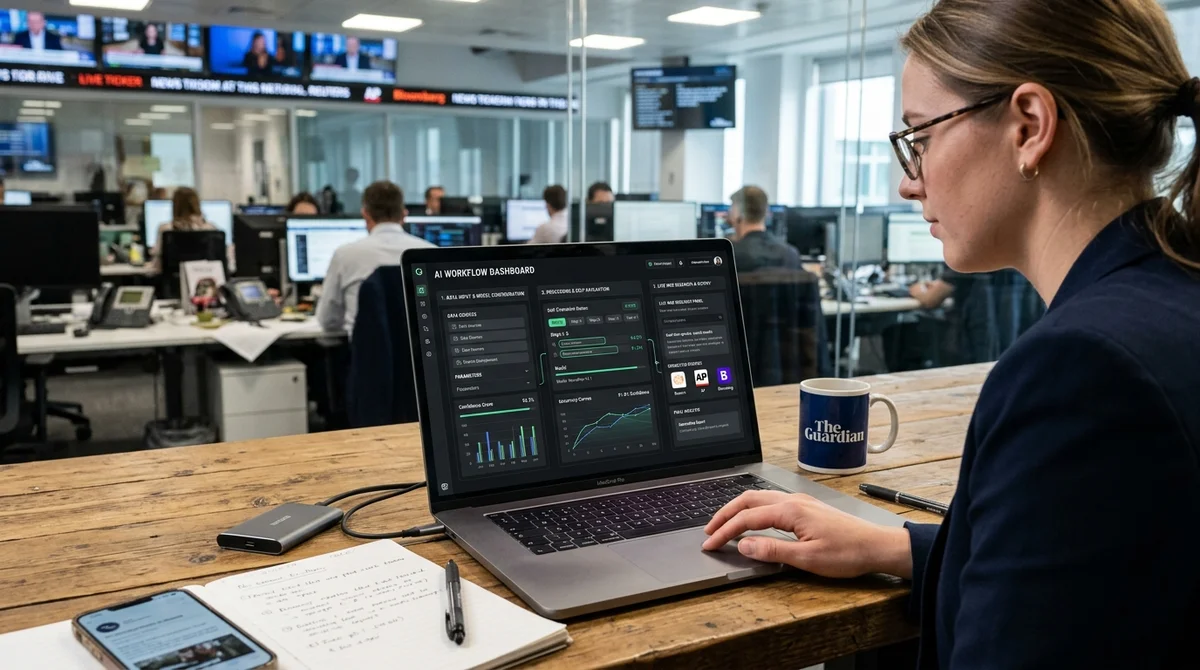
MarkTechPost يستعرض كيفية بناء نظام LLM يقيّم نفسه ويقدّر ثقته ويلجأ إلى البحث على الويب
يستعرض MarkTechPost مخططًا عمليًا لنظام LLM واعٍ بعدم اليقين: يجيب النموذج أولًا ويقدّر ثقته، ثم يراجع نفسه، وعند الشك يطلق بحثًا على الويب.
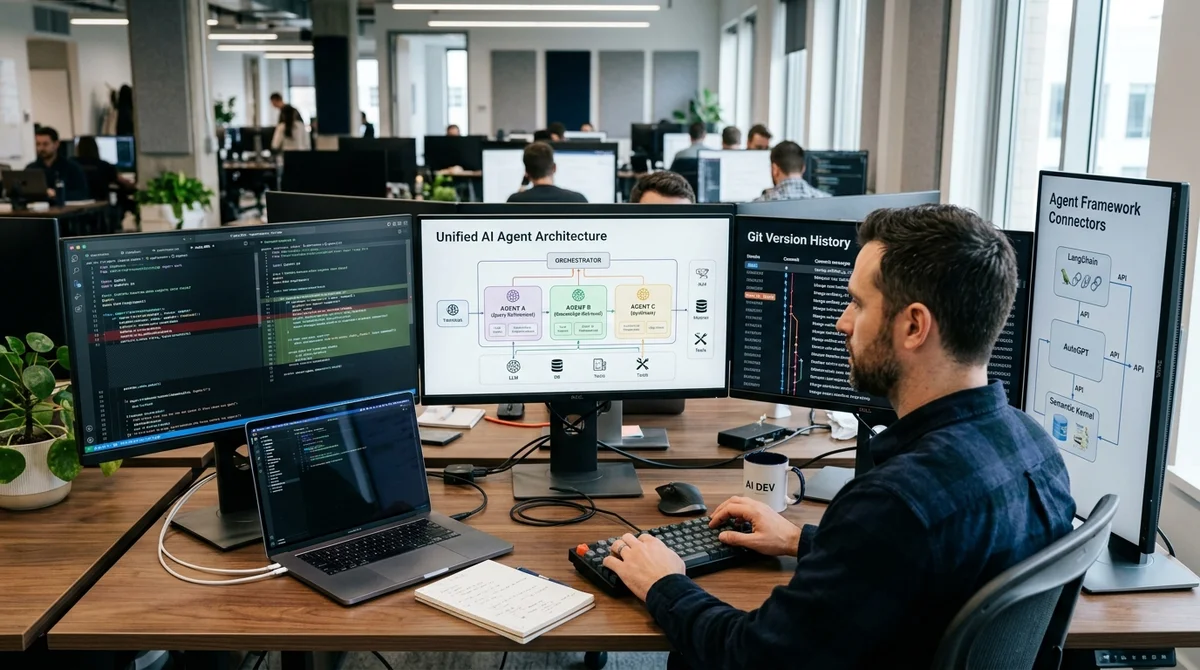
GitAgent يقترح صيغة موحّدة لوكلاء الذكاء الاصطناعي عبر LangChain وAutoGen وClaude Code
يقترح GitAgent تخزين منطق وكيل الذكاء الاصطناعي وذاكرته وقواعده في مستودع Git، ثم تصدير الوكيل نفسه إلى LangChain وAutoGen وClaude Code وبيئات أخرى.
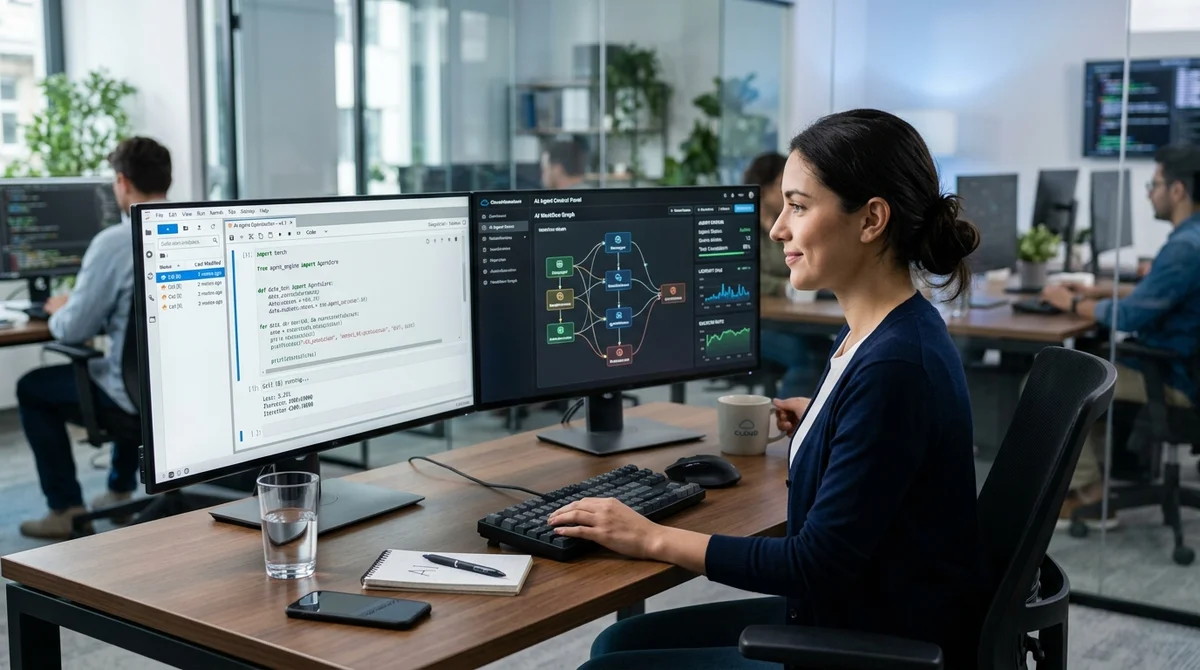
Google تطلق colab-mcp: كيف تؤتمت وكلاء الذكاء الاصطناعي دفاتر Colab في بيئات الإنتاج
كشفت Google عن colab-mcp، وهو خادم مفتوح المصدر للتحكم في دفاتر Colab عبر MCP: يستطيع الوكيل إضافة الخلايا وتشغيل الشيفرة وبناء مسارات عمل مستقرة دون روتين يدوي.
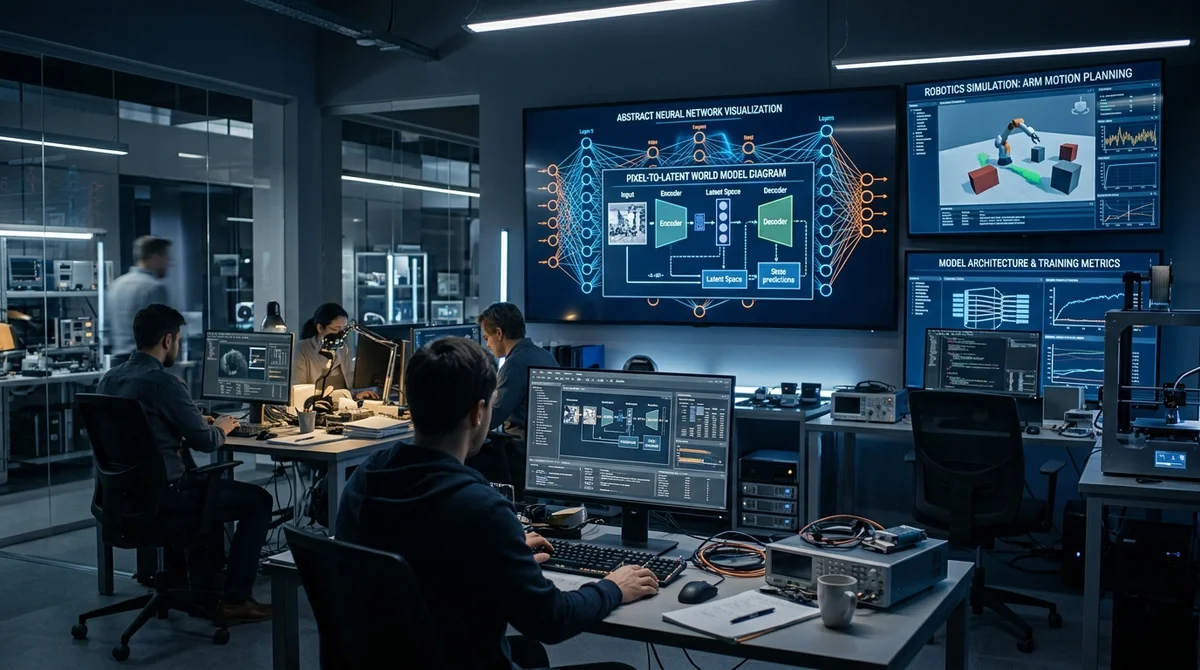
يان لوكون يقدّم LeWorldModel: نموذج JEPA يتعلم من البكسلات دون انهيار التمثيلات
قدّم فريق يان لوكون LeWorldModel، وهو نموذج عالم يتدرب مباشرة على البكسلات بدالتي خسارة فقط، ويتجنب انهيار التمثيلات، ويخطط أسرع حتى 48 مرة من البدائل.
HKUDS تستعرض OpenSpace بالتفصيل: محرك للتطور الذاتي لمهارات وكلاء الذكاء الاصطناعي
عرضت HKUDS كيف يحوّل OpenSpace وكلاء الذكاء الاصطناعي إلى أنظمة ذاتية التعلّم: يحفظ المحرك المهارات بعد كل مهمة ويعيد استخدامها، ويخفّض استهلاك الرموز بشكل ملحوظ.
Nvidia تكشف عن PivotRL: إطار عمل لوكلاء الذكاء الاصطناعي يوفّر 4 أضعاف خطوات rollout
كشفت Nvidia عن PivotRL، وهو نهج لإعادة تدريب وكلاء الذكاء الاصطناعي يحافظ على الجودة خارج مجال التدريب ويبلغ دقة مماثلة لـ E2E RL بعدد خطوات rollout أقل بأربع مرات.
Google تكشف عن TurboQuant: ضغط ذاكرة KV-cache في نماذج LLM بمقدار 6 أضعاف دون فقدان الدقة
كشف Google Research عن TurboQuant، وهي خوارزمية تضغط KV-cache في النماذج اللغوية الكبيرة بمقدار 6 أضعاف على الأقل وتسرّع حساب attention حتى 8 مرات دون تراجع في الجودة.
MolmoWeb-4B من Ai2: وكيل ويب يرى المواقع كما يراها الإنسان، دون تحليل HTML
أطلقت Ai2 نموذج MolmoWeb-4B، وهو وكيل ويب مفتوح متعدد الوسائط يتحكم في المتصفح عبر لقطات الشاشة فقط، دون الوصول إلى HTML أو شجرة DOM.
Tencent تفتح مصدر Covo-Audio: نموذج بـ7 مليارات معامل للحوارات الصوتية والاستدلال الصوتي
أتاحت Tencent AI Lab نموذج Covo-Audio مفتوح المصدر، وهو نموذج صوتي بـ7 مليارات معامل يستقبل الكلام المتواصل ويرد بالصوت، ويستهدف الحوارات والاستدلال في الوقت الفعلي.
Qwen3.5: تشغيل نماذج الاستدلال بصيغة gguf وبتنسيق 4 بت عبر Colab
دليل عملي على Colab لتشغيل نماذج الاستدلال Qwen3.5 المقطَّرة بأسلوب Claude: بإعداد واحد يمكن التبديل بين نسخة 27B بصيغة gguf ونسخة 2B الخفيفة بتنسيق 4 بت.
Google تطلق Gemini 3.1 Flash Live لوكلاء الذكاء الاصطناعي الصوتيين والحوار متعدد الوسائط
فتحت Google الوصول التجريبي إلى Gemini 3.1 Flash Live، وهو نموذج لوكلاء الذكاء الاصطناعي الصوتيين والمرئيين بزمن استجابة منخفض ودعم للأدوات وحوار أكثر طبيعية.
IWE وOpenAI: كيف تحوّل ملاحظات markdown إلى رسم بياني للمعرفة لوكلاء الذكاء الاصطناعي
عرض عملي على IWE يوضح كيفية بناء رسم بياني معرفي محلي من ملفات markdown، وربطه بـ OpenAI function calling، وإنشاء agentic RAG يتنقل بين الروابط الرابطة للملاحظات.
غوغل توضح الفرق بين Google-Agent وGooglebot في وصول الذكاء الاصطناعي إلى المواقع وفهرستها
أوضحت غوغل الفرق بين Google-Agent الجديد وGooglebot: الأول ينفّذ إجراءات على الموقع بطلب من المستخدم، والثاني يمسح الويب تلقائيًا لأغراض الفهرسة.
باحثون مرتبطون بأمازون يقدمون A-Evolve لتطوير وكلاء الذكاء الاصطناعي تلقائيًا
قدّم باحثون مرتبطون بأمازون نظام A-Evolve الذي يؤتمت تطوير وكلاء الذكاء الاصطناعي، ويستبدل بالضبط اليدوي تطوّر الحالة والتصحيح الذاتي.
Agent-Infra تطلق AIO Sandbox: بيئة موحدة لوكلاء الذكاء الاصطناعي تضم متصفحًا وشل
أطلقت Agent-Infra بيئة AIO Sandbox مفتوحة المصدر، وهي حاوية تجمع المتصفح وshell وطبقة ملفات مشتركة وMCP في بيئة تشغيل واحدة لوكلاء الذكاء الاصطناعي.
Cursor تطلق TypeScript SDK لوكلاء البرمجة مع بيئات سحابية معزولة وتسعير بحسب الرموز
أطلقت Cursor النسخة التجريبية العامة من TypeScript SDK: يستطيع المطورون الآن تشغيل وكلاء البرمجة محليًا وفي السحابة وعلى خوادمهم الخاصة، مع آلات افتراضية معزولة ووكلاء فرعيين وhooks وتسعير بحسب الرموز.
علي بابا تطلق Qwen3.5-Omni: نموذج أصلي متعدد الوسائط للنص والصوت والفيديو
قدّمت Alibaba نموذج Qwen3.5-Omni، وهو نموذج شامل متعدد الوسائط يفهم النص والصور والصوت والفيديو ضمن بنية واحدة، ويرد بالصوت في الوقت الفعلي.
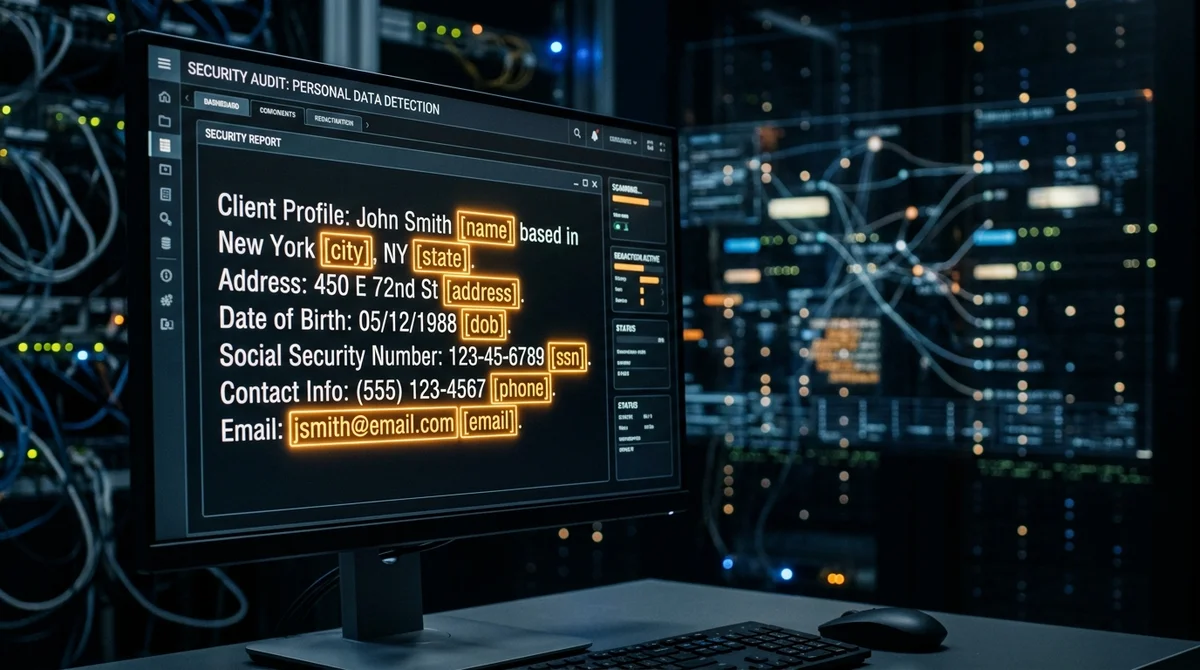
OpenAI تطلق Privacy Filter: نموذج مفتوح المصدر لإزالة البيانات الشخصية
نشرت OpenAI نموذج Privacy Filter مفتوح المصدر للكشف التلقائي عن البيانات الشخصية واستبدالها، ويعمل مباشرة في المتصفح دون بنية تحتية للخوادم.
OpenAI وPromptflow: كيف تبني خط أنابيب LLM مع التتبع وتقييم الجودة
يوضّح الدليل كيفية بناء خط أنابيب LLM في Google Colab باستخدام Promptflow وPrompty وOpenAI، مع إعداد آمن للمفاتيح وتتبع لكل تشغيل وتقييم مدمج للجودة.
Meta FAIR تطلق NeuralSet: حزمة Python لربط البيانات العصبية بنماذج الذكاء الاصطناعي
فتحت Meta FAIR مصدر NeuralSet، وهو إطار عمل بلغة Python يدمج بيانات fMRI وM/EEG والنبضات العصبية وتمثيلات Hugging Face في مسار PyTorch واحد لأبحاث Neuro-AI. *تعدّ روسيا شركة Meta منظمة متطرفة وتحظر أنشطتها فيها.
فريق Qwen يطلق FlashQLA: تسريع الانتباه الخطي حتى 3 أضعاف على معالجات NVIDIA Hopper
أطلقت QwenLM مكتبة FlashQLA لنوى CUDA الخاصة بشبكة Gated Delta Network، وهي تحقق تسريعًا يصل إلى 3 أضعاف على معالجات NVIDIA Hopper في التدريب المسبق والاستدلال الوكيلي.
OpenAI Privacy Filter: كيف تبني خط معالجة إنتاجيًا (production) لاكتشاف البيانات الشخصية PII وإخفائها
يستعرض دليل OpenAI Privacy Filter خط معالجة متكاملًا لاكتشاف البيانات الشخصية وإخفائها، بدءًا من تحميل النموذج وصولًا إلى التحرير التلقائي للنص.
DeepSeek وGoogle وMeta: 10 تقنيات لضغط KV-cache في نماذج LLM لخفض استهلاك الذاكرة أثناء الاستدلال
أصبح KV-cache أكبر مستهلك لذاكرة GPU في نماذج LLM الكبيرة. ويستعرض تقرير جديد 10 أساليب، من H2O وSnapKV إلى TurboQuant وMLA من DeepSeek، تقلّص استهلاك الذاكرة دون إعادة تصميم النموذج بالكامل.
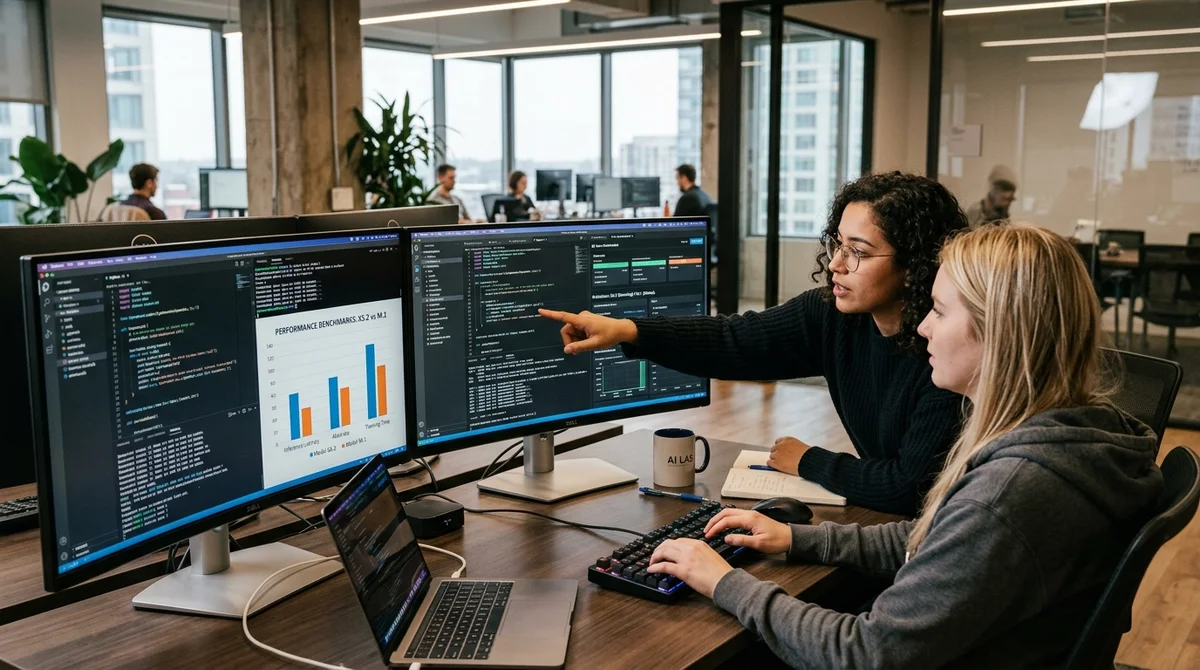
Poolside تطلق Laguna XS.2 وM.1: نموذجان مفتوحان للبرمجة الوكيلية
كشفت Poolside عن نموذجين من Laguna للبرمجة الوكيلية: XS.2 المفتوح يعمل محليًا، وM.1 الأقوى مخصص للمهام الطويلة التي تشمل تعديل الشيفرة والاختبارات والعمل في الطرفية.
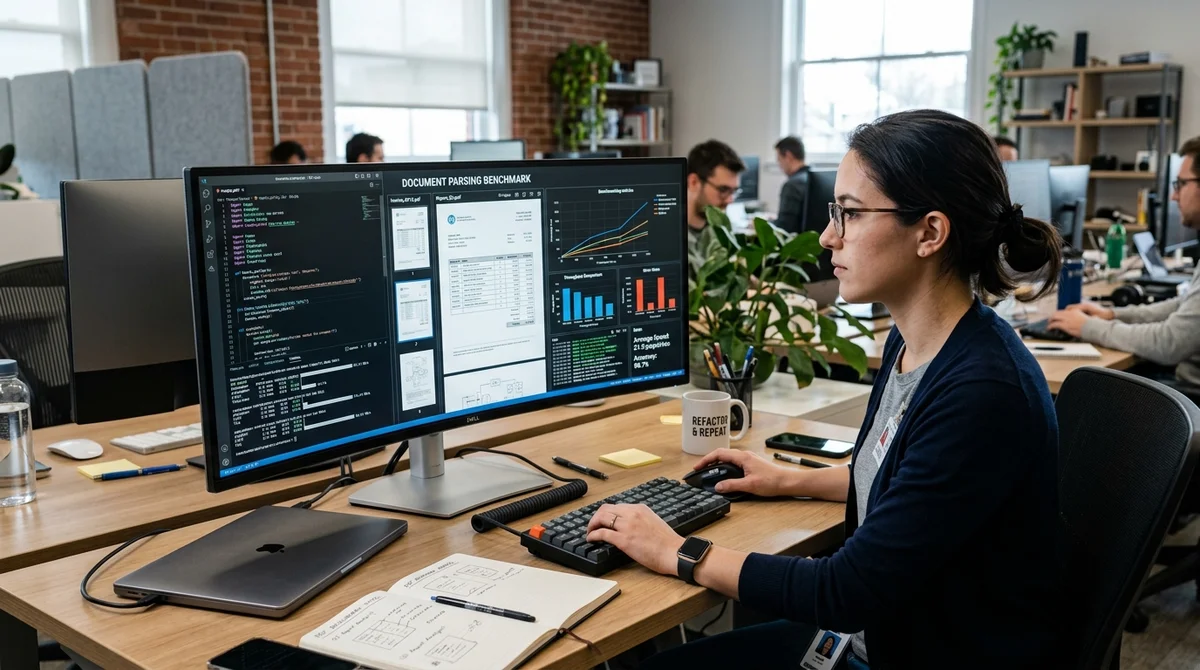
LlamaIndex ParseBench: كيف تختبر تحليل المستندات عبر Python وHugging Face
يشرح هذا الدليل العملي كيف تبني على مجموعة بيانات LlamaIndex ParseBench خط تقييم لمحلّلات المستندات: تحميل ملفات PDF من Hugging Face ومقارنة النص المستخرج وقياس الجودة.
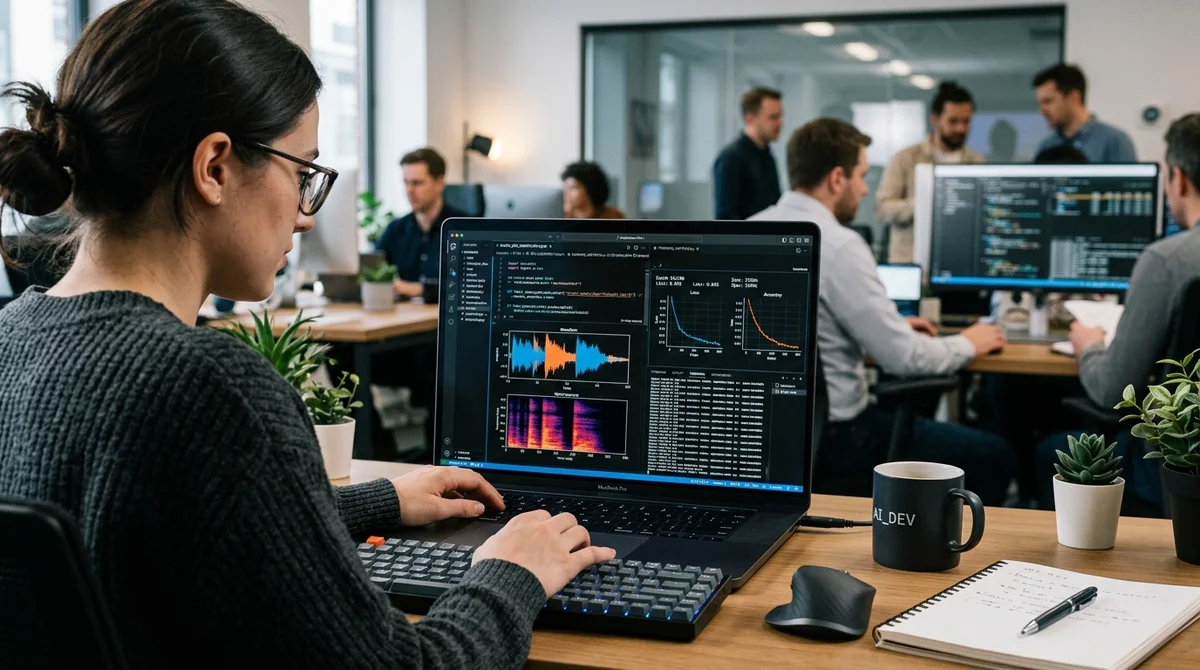
smol-audio من Deep-unlearning: مجموعة دفاتر Colab لإعادة تدريب نماذج الصوت
أطلقت Deep-unlearning مشروع smol-audio، وهو مجموعة دفاتر متوافقة مع Colab تتيح إعادة تدريب نماذج Whisper وParakeet وVoxtral وGranite Speech وغيرها من نماذج الصوت.
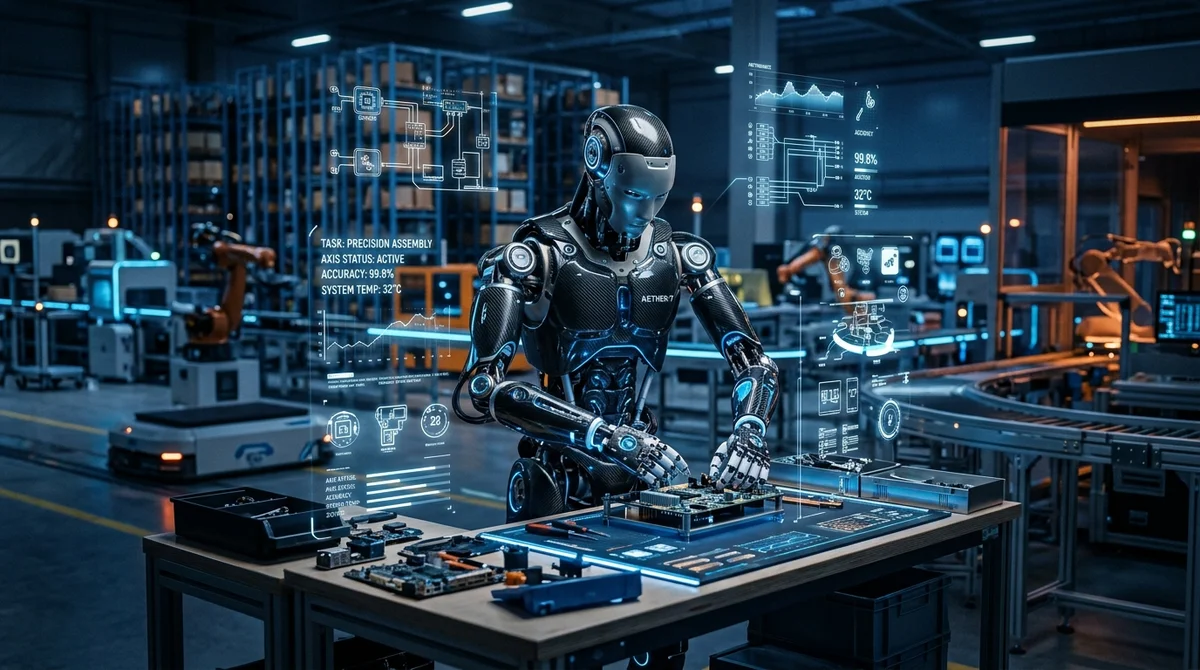
أبرز 10 نماذج ذكاء اصطناعي فيزيائي تتحكم في روبوتات حقيقية في 2026
خلال 18 شهرًا تقلّصت الفجوة بين نماذج اللغة الكبيرة والروبوتات الواقعية بشكل حاد، وباتت نماذج الذكاء الاصطناعي الفيزيائي تعمل في المصانع والمستودعات والمختبرات البحثية.
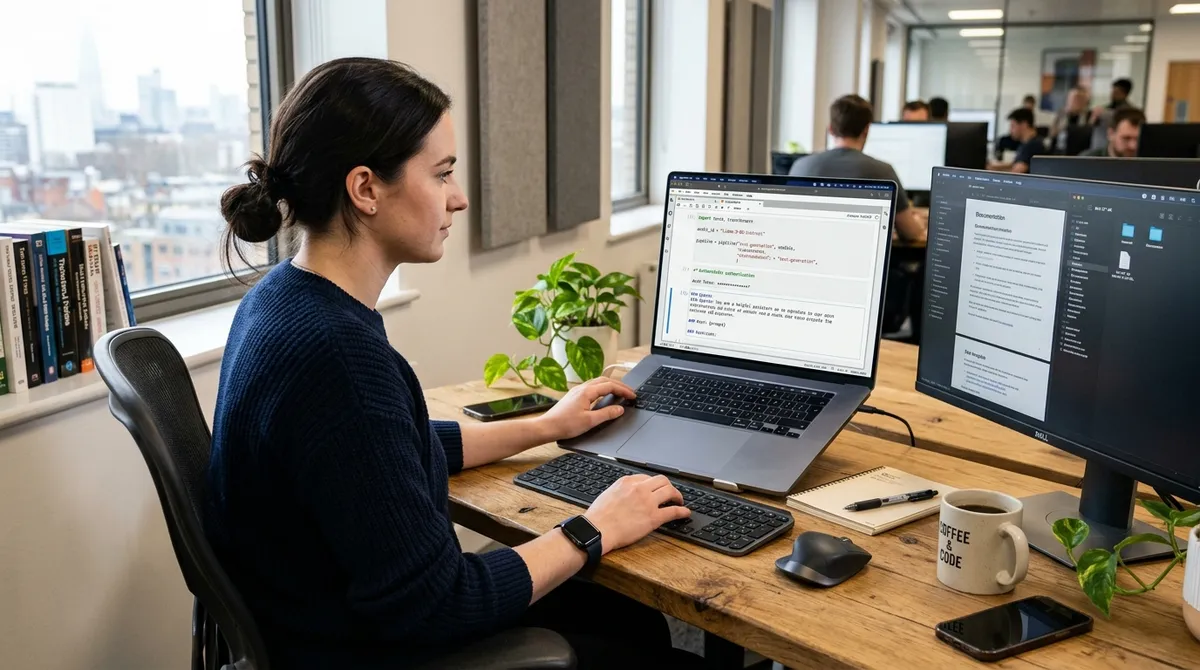
Hugging Face وGemma 3 1B: كيف تبني خط توليد جاهزًا للإنتاج في Colab
يشرح الدليل كيفية تشغيل Gemma 3 1B Instruct في Colab عبر Hugging Face Transformers، مع مصادقة آمنة وقوالب محادثة (chat templates) وخط استدلال (inference) قابل لإعادة الإنتاج.
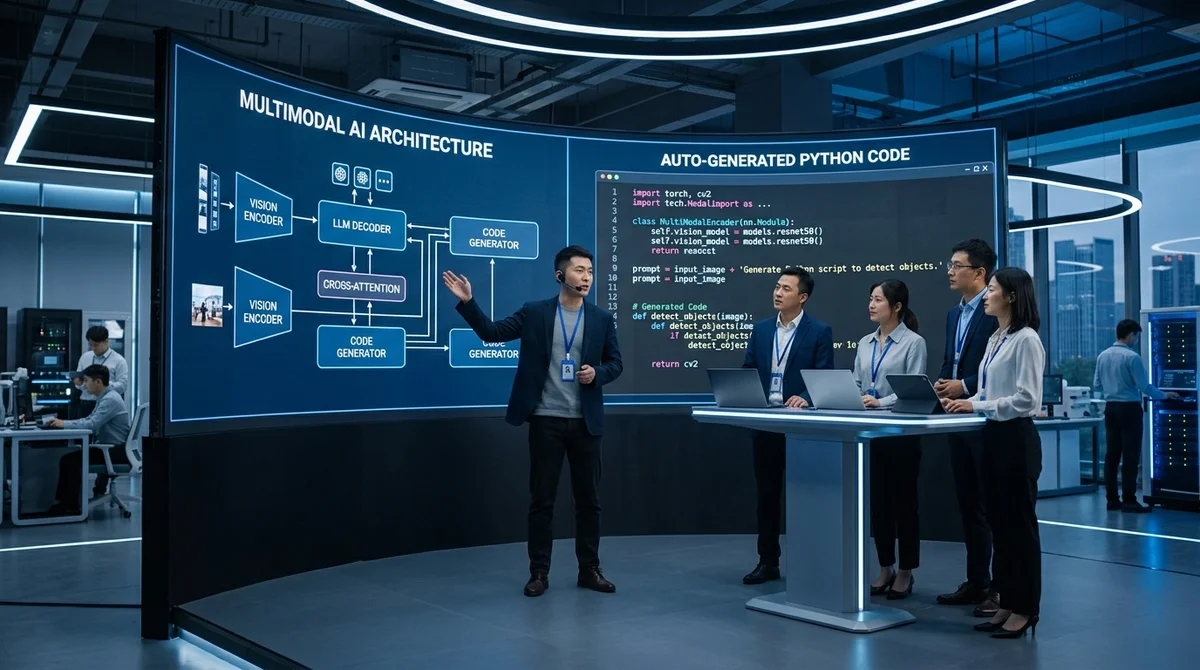
Z.ai تطلق GLM-5V-Turbo: نموذج متعدد الوسائط أصيل للبرمجة البصرية
أطلق مختبر Z.ai الصيني نموذج GLM-5V-Turbo، وهو نموذج يقرأ المخططات المعمارية ولقطات الشاشة ويولّد منها شيفرة عاملة مباشرة لأنظمة الهندسة الوكيلية.