OpenAI تطلق Privacy Filter: نموذج مفتوح المصدر لإزالة البيانات الشخصية
أطلقت OpenAI نموذج Privacy Filter، وهو نموذج مفتوح لإزالة البيانات الشخصية (PII) من النصوص تلقائيًا. ورغم أن عدد معاملاته 1.5 مليار، فإن 50 مليونًا منها فقط تُفعَّل فعليًا، ما يتيح تشغيله مباشرة في المتصفح عبر WebAssembly دون بنية تحتية للخوادم. يكتشف النموذج الأسماء والعناوين وأرقام الهواتف والوثائق، ويستبدلها بعناصر نائبة قياسية مثل [ИМЯ] أو [АДРЕС]. وهو مناسب لسيناريوهات الاستضافة الذاتية (self-hosted) ولمسارات CI/CD.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News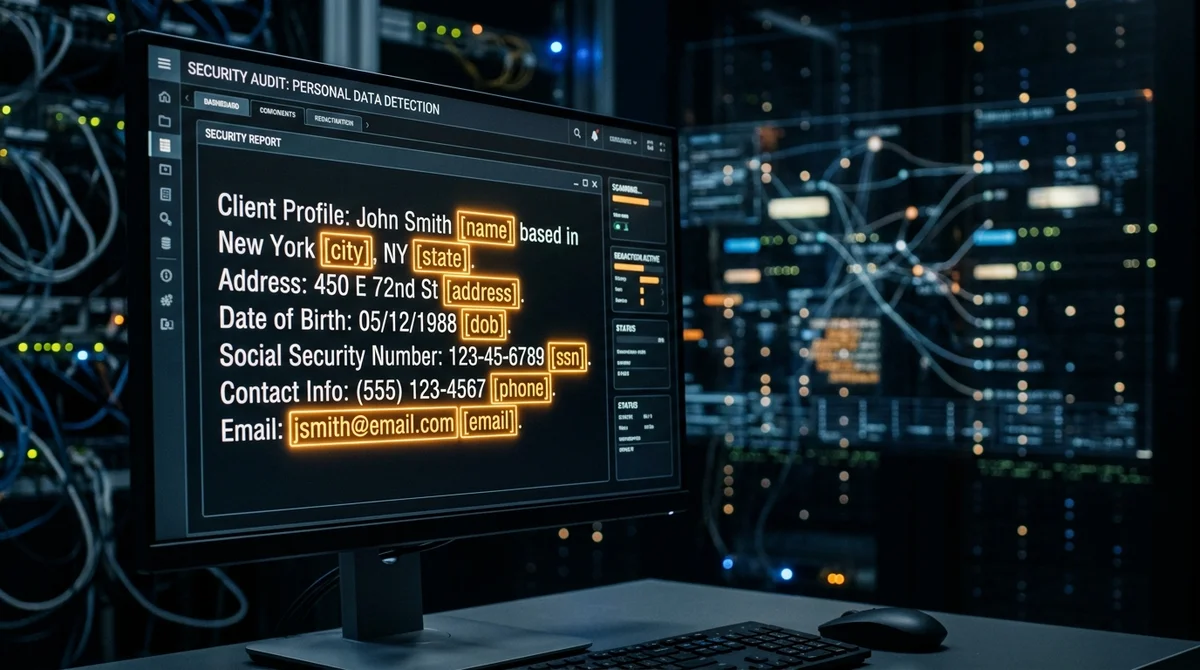
نشرت OpenAI نموذج Privacy Filter، وهو نموذج مفتوح قائم على مفكّك ترميز (decoder) مُقطَّر، يكتشف البيانات الشخصية (PII) في النصوص ويزيلها. ورغم أن الأوزان تضم 1.5 مليار معامل، فإن 50 مليونًا منها فقط تكون نشطة أثناء الاستدلال (inference). وهذا ما يتيح تشغيله مباشرة في المتصفح دون بنية تحتية للخوادم.
ما هو Privacy Filter
Privacy Filter نموذج لغوي متخصص مُكرَّس لمهمة واحدة محددة: الكشف التلقائي عن البيانات الشخصية (Personally Identifiable Information, PII) في النص وتنقيحها. وهو ليس مساعد دردشة عامًّا، بل أداة وظيفية تركّز حصرًا على العثور على المعلومات الحساسة واستبدالها بعناصر نائبة موحّدة.
ويتحوّل هذا التخصص إلى ميزة: فالنموذج المضبوط لمهمة ضيقة يؤديها أفضل من نماذج LLM العامة، التي كثيرًا ما تُفوّت بيانات شخصية صِيغت بطريقة غير نمطية، أو تخطئ في السياقات المعقدة.
يقوم النموذج على مفكّك ترميز مُقطَّر: إذ ينقل نموذج «معلّم» كبير معارفه إلى نموذج «تلميذ» مضغوط خلال عملية التقطير. والنتيجة دقة كشف عالية بمتطلبات حوسبة أقل بكثير.
نُشر النموذج في وصول مفتوح، ويمكن لأي شركة دمجه في مسارات عملها الخاصة دون إرسال البيانات إلى خوادم OpenAI.
البنية: 50 مليونًا من أصل 1.5 مليار
التفصيل التقني الأبرز هو الفجوة بين العدد الإجمالي للمعاملات (1.5 مليار) وتلك التي تُفعَّل فعليًا عند معالجة كل رمز (token)، وهي 50 مليونًا. ويميّز هذا النهج البنى ذات التفعيل المتناثر (sparse activation)، حيث تتخصص الكتل العصبية المختلفة في جوانب مختلفة من المهمة، وتُفعَّل انتقائيًا بحسب المدخلات.
وهذا يجعل Privacy Filter أداة عملية في السيناريوهات محدودة الموارد:
- المتصفح: متوافق مع WebAssembly وONNX، فلا تغادر البيانات جهاز المستخدم
- أجهزة الحافة (Edge): تتيح 50M معامل نشط العمل دون GPU على الحواسيب المحمولة والهواتف الذكية
- الاستضافة الذاتية (Self-hosted): يُستضاف النموذج بالكامل داخل بنية الشركة التحتية
- مسارات CI/CD: استدلال سريع دون اعتماد على السحابة ودون نفقات إضافية
ما الذي يستطيع اكتشافه
يتعرّف Privacy Filter على مجموعة واسعة من فئات البيانات الشخصية، تغطي المتطلبات الأساسية لقوانين GDPR وLGPD وCCPA:
- الأسماء والألقاب والأحرف الأولى (بما في ذلك التعرّف السياقي دون علامات صريحة)
- العناوين والرموز البريدية والإحداثيات الجغرافية
- أرقام الهواتف وعناوين البريد الإلكتروني
- وثائق الهوية — جوازات السفر وSSN وINN (الرقم الضريبي الروسي) ورخص القيادة
- البيانات المالية — أرقام البطاقات والحسابات المصرفية
- المعرّفات الطبية
ولا يكتفي النموذج بتمييز أجزاء PII، بل يستبدلها أيضًا بعناصر نائبة قياسية: [ИМЯ] و[АДРЕС] و[ТЕЛЕФОН]. ويكون النص الناتج جاهزًا فورًا للمعالجة اللاحقة دون معالجة يدوية بعدية.
السياق التنظيمي
يتزايد الضغط التنظيمي المتعلق بالبيانات الشخصية في أنحاء العالم. فقوانين GDPR في أوروبا وLGPD في البرازيل وCCPA في كاليفورنيا تُلزم الشركات جميعها بالتعامل بحذر مع المعلومات الحساسة. وكانت معظم الحلول التجارية للتعتيم التلقائي للهوية إما أدنى جودة، وإما تتطلب نقل البيانات إلى السحابة، وهو ما يتناقض أصلًا مع منطق الخصوصية.
ويسدّ Privacy Filter هذه الفجوة: نموذج مفتوح متوافق مع المتصفح، يستطيع فريق صغير دمجه في منتج خلال يوم واحد دون التضحية بخصوصية المستخدمين.
ماذا يعني ذلك
تستثمر OpenAI باستمرار في البنية التحتية المفتوحة إلى جانب منتجاتها التجارية الرائدة. ويُظهر Privacy Filter أن الشركة ترى السوق لا في الوصول عبر API إلى GPT فحسب، بل في الأدوات الوظيفية التي تلبّي احتياجات تشغيلية محددة. وهي إشارة إلى السوق بأن الأدوات مفتوحة المصدر بمستوى المؤسسات في مجال أمن بيانات الذكاء الاصطناعي أصبحت أمرًا معتادًا.
أما بالنسبة للشركات، فهو حل جاهز لمهمة إخفاء هوية البيانات، دون تطوير من الصفر ودون الاعتماد على السحابة.
- 29 أكتوبر 2026TokenRouter يسرّع التوجيه على مستوى الرمز بين النماذج حتى 64 ضعفًا
- 29 أكتوبر 2026Google تفتح Android Studio أمام وكلاء ذكاء اصطناعي من جهات أخرى: Claude وCodex وأكثر من 40 وكيلًا آخر
- 29 أكتوبر 2026Claude Code يمنتج الفيديو انطلاقًا من التفريغ النصي: كيف يعمل video-use الحاصل على 30 000 نجمة
- 29 أكتوبر 2026Anthropic تقدّم للشركات تقارير عن التوكنات: إنفاق العملاء ارتفع 9 أضعاف خلال عام
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول ما هو Privacy Filter؟
Privacy Filter نموذج لغوي متخصص مُكرَّس لمهمة واحدة محددة: الكشف التلقائي عن البيانات الشخصية (Personally Identifiable Information, PII) في النص وتنقيحها. وهو ليس مساعد دردشة عامًّا، بل أداة وظيفية تركّز حصرًا على العثور على المعلومات الحساسة واستبدالها بعناصر نائبة موحّدة. ويتحوّل هذا التخصص إلى ميزة: فالنموذج المضبوط لمهمة ضيقة يؤديها أفضل من نماذج LLM العامة، التي كثيرًا ما تُفوّت بيانات شخصية صِيغت بطريقة غير نمطية، أو تخطئ في السياقات المعقدة. يقوم النموذج على مفكّك ترميز مُقطَّر: إذ ينقل نموذج «معلّم» كبير معارفه إلى نموذج «تلميذ» مضغوط خلال عملية التقطير. والنتيجة دق
ما أبرز التفاصيل حول البنية: 50 مليونًا من أصل 1.5 مليار؟
التفصيل التقني الأبرز هو الفجوة بين العدد الإجمالي للمعاملات (1.5 مليار) وتلك التي تُفعَّل فعليًا عند معالجة كل رمز (token)، وهي 50 مليونًا. ويميّز هذا النهج البنى ذات التفعيل المتناثر (sparse activation)، حيث تتخصص الكتل العصبية المختلفة في جوانب مختلفة من المهمة، وتُفعَّل انتقائيًا بحسب المدخلات. وهذا يجعل Privacy Filter أداة عملية في السيناريوهات محدودة الموارد: المتصفح: متوافق مع WebAssembly وONNX، فلا تغادر البيانات جهاز المستخدم أجهزة الحافة (Edge): تتيح 50M معامل نشط العمل دون GPU على الحواسيب المحمولة والهواتف الذكية الاستضافة الذاتية (Self-hosted): يُستضاف النموذج
ما أبرز التفاصيل حول ما الذي يستطيع اكتشافه؟
يتعرّف Privacy Filter على مجموعة واسعة من فئات البيانات الشخصية، تغطي المتطلبات الأساسية لقوانين GDPR وLGPD وCCPA: الأسماء والألقاب والأحرف الأولى (بما في ذلك التعرّف السياقي دون علامات صريحة) العناوين والرموز البريدية والإحداثيات الجغرافية أرقام الهواتف وعناوين البريد الإلكتروني وثائق الهوية — جوازات السفر وSSN وINN (الرقم الضريبي الروسي) ورخص القيادة البيانات المالية — أرقام البطاقات والحسابات المصرفية المعرّفات الطبية ولا يكتفي النموذج بتمييز أجزاء PII، بل يستبدلها أيضًا بعناصر نائبة قياسية: [ИМЯ] و[АДРЕС] و[ТЕЛЕФОН]. ويكون النص الناتج جاهزًا فورًا للمعالجة اللاحقة دون م
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.