غوغل توضح الفرق بين Google-Agent وGooglebot في وصول الذكاء الاصطناعي إلى المواقع وفهرستها
أطلقت غوغل وكيل مستخدم (user-agent) مستقلًا لسيناريوهات الذكاء الاصطناعي القائمة على الوكلاء، وهو Google-Agent. وعلى خلاف Googlebot، لا يفهرس هذا الوكيل الويب لأغراض البحث، بل يزور الصفحات بطلب مباشر من المستخدم، كأن تحتاج خدمة ذكاء اصطناعي إلى فتح موقع وتنفيذ إجراء عليه. بالنسبة للمطورين، تحمل هذه الخطوة إشارة واضحة: لم يعد كافيًا التعامل مع سجلات الخوادم وملف robots.txt وقواعد التحقق من الزيارات بالطريقة القديمة، بل صار لا بد من تفسيرها بدقة أكبر.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News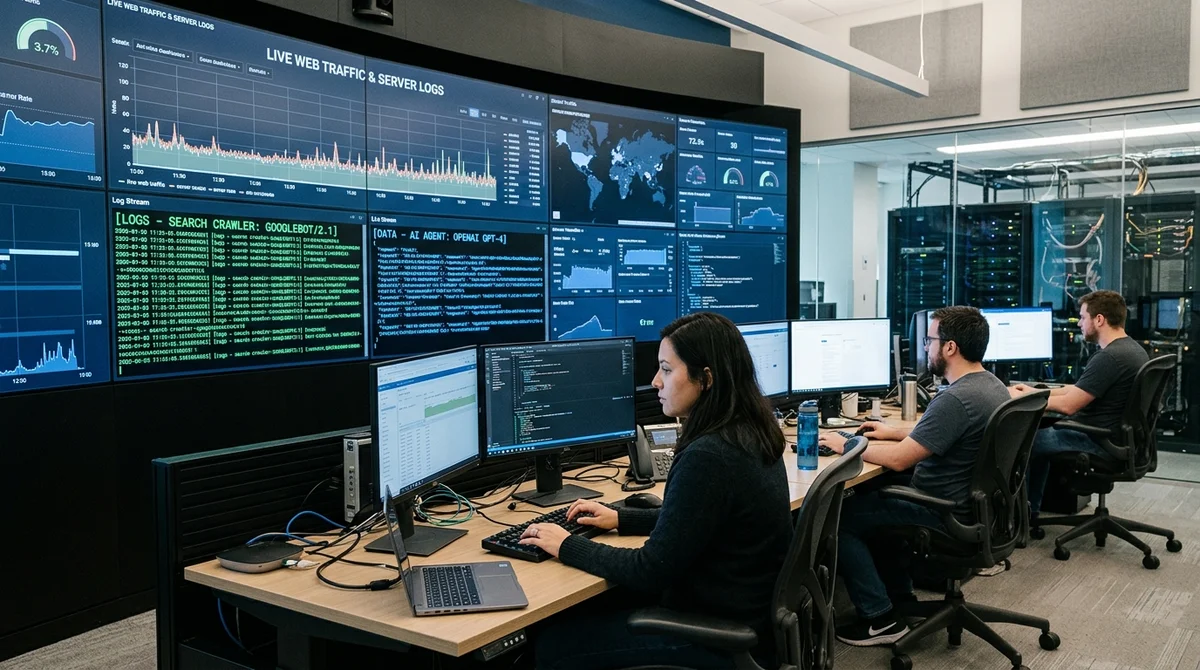
فصلت غوغل رسميًا بين نوعين من الوصول إلى المواقع: Googlebot المعتاد للفهرسة، وGoogle-Agent الجديد للإجراءات التي يطلقها المستخدم نفسه عبر خدمات الذكاء الاصطناعي التابعة للشركة. وهذا فارق مهم للمطورين وأصحاب المواقع، إذ قد تعني الزيارات المتشابهة في ظاهرها القادمة من بنية غوغل التحتية الآن سيناريوهات مختلفة تمامًا.
أين يقع الحد الفاصل
يبقى Googlebot زاحف البحث الكلاسيكي. تتمثل مهمته في التجول التلقائي بين الصفحات، وجمع البيانات لفهرس البحث، وتحديث تصور غوغل لمحتوى الموقع، ومراعاة القواعد المحددة في ملف robots.txt. ولذلك ترتبط طلبات Googlebot عادةً بتحسين محركات البحث (SEO) والظهور في نتائج البحث وواجهات الأخبار والصور والفيديو وغيرها من المنتجات التي تعتمد على المسح الدوري للويب دون تدخل مستخدم بعينه.
أما Google-Agent فينتمي إلى فئة مختلفة، هي user-triggered fetchers، أي الأنظمة التي ترسل الطلب لا بمبادرة ذاتية منها، بل بأمر من المستخدم داخل أحد منتجات غوغل. وتنص الشركة في وثائقها صراحةً على أن هذا الوكيل يُستخدم للتنقل في الويب وتنفيذ الإجراءات بطلب من المستخدم، وتذكر Project Mariner مثالًا على ذلك. والتفصيل الجوهري أنه ليس مفهرسًا للبحث: فهو يصل إلى الموقع في اللحظة التي يحتاج فيها الشخص فعليًا إلى النتيجة، لا حين تحدّث غوغل فهرسها وفق جدول مخطط.
كيف نميّز بينهما في السجلات
يصبح هذا الفرق عمليًا في سجلات الخوادم. ففي سطر user-agent يظهر لدى Googlebot التوقيع المعتاد Googlebot/2.1، أما لدى العميل الجديد فيظهر Google-Agent داخل قالب متصفح للجوال أو لسطح المكتب. لكن غوغل تحذّر بشكل منفصل من أن سطر user-agent وحده لا يكفي، لأنه قابل للتزوير. ولذلك ينبغي التحقق من هذه الطلبات عبر عناوين IP وعبر البحث العكسي في DNS (reverse DNS) وعبر قوائم النطاقات المنشورة بصيغة JSON، وإلا سيسهل الخلط بين زيارات غوغل الحقيقية والروبوتات التي تنتحل صفتها.
- يستخدم Googlebot نطاقات مستقلة في ملف common-crawlers.json ومضيفات من نوع googlebot.com
- يستخدم Google-Agent النطاقات الواردة في ملف user-triggered-agents.json
- قد تُحلّ عناوين user-triggered fetchers إلى google.com أو gae.googleusercontent.com
- تختبر غوغل بالفعل web-bot-auth والمعرّف agent.bot.goog لمثل هذه الوكلاء
ما الذي يتغير بالنسبة للمواقع
يعني ذلك لأصحاب المواقع أنه لم يعد ممكنًا وضع كل الزيارات «القادمة من غوغل» في سلة واحدة. فالمسح التلقائي لأغراض البحث، والطلبات المنفردة الصادرة من أدوات مثل NotebookLM، والإجراءات القائمة على الوكلاء داخل المتصفح، باتت تعمل الآن بأنماط تقنية مختلفة. وبعد أن كان المنطق السابق بسيطًا، أي أن Googlebot يفهرس وكل ما عداه ثانوي، تبرز الآن للموقع أسئلة منفصلة تتعلق بالتحليلات وتحديد معدل الطلبات (rate limiting) والحماية من الأتمتة وقواعد الوصول لسيناريوهات الذكاء الاصطناعي التي تعمل نيابةً عن المستخدم.
وهناك طبقة أدق من التمييز. فعلى سبيل المثال، يخدم Google-CloudVertexBot الزحف الذي يسمح به الموقع نفسه لبناء Vertex AI Agents، ولا يؤثر في نتائج البحث. أما Google-Extended فليس زاحفًا مستقلًا أصلًا، بل رمز تحكم (token) يحدد ما إذا كان يجوز استخدام المحتوى في تدريب الأجيال القادمة من Gemini وفي grounding ضمن بعض المنتجات. وفي ضوء ذلك يبدو Google-Agent فئة وصول مستقلة بذاتها: فهو ليس بحثًا ولا تدريبًا للنماذج ولا استيرادًا مؤسسيًا للبيانات، بل تنفيذ حيّ لمهمة المستخدم على الويب.
ما معنى ذلك
تهيئ غوغل الويب عمليًا لعصر الطلبات القائمة على الوكلاء، حيث لا يكتفي الذكاء الاصطناعي بقراءة الصفحات بل يتصرف داخلها. وهذه إشارة للمطورين إلى ضرورة الفصل بين الفهرسة وتدريب النماذج وإجراءات الذكاء الاصطناعي التي يطلقها المستخدمون، وذلك على مستوى السجلات وسياسات الوصول والمراقبة. أما بالنسبة لفرق SEO ومطوري الواجهات الخلفية (backend) ومهندسي الأمن، فلم يعد الأمر مجرد مصطلح في الوثائق، بل كيانًا جديدًا يجب أخذه في الحسبان عند تصفية الزيارات وإعداد التنبيهات والتقارير.
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.