Baidu تطلق Qianfan-OCR: نموذج بحجم 4B للتعرف على المستندات وفهمها
عرضت Baidu نموذج Qianfan-OCR بحجم 4B، وهو يجمع التعرف الضوئي على الحروف (OCR) وتحليل التخطيط وفهم المستندات في بنية واحدة. وبدلاً من خط معالجة متعدد المراحل، يحوّل النظام الصورة مباشرة إلى Markdown، ويدعم مهام تُحدَّد عبر الموجّه (prompt)، مثل استخراج الجداول والإجابة عن الأسئلة حول المستند وأتمتة العمليات الداخلية. وهي خطوة جديدة نحو خدمات ذكاء اصطناعي ذكية للمستندات موجهة إلى الأعمال.
معالج بواسطة الذكاء الاصطناعي من MarkTechPost؛ بتحرير Hamidun News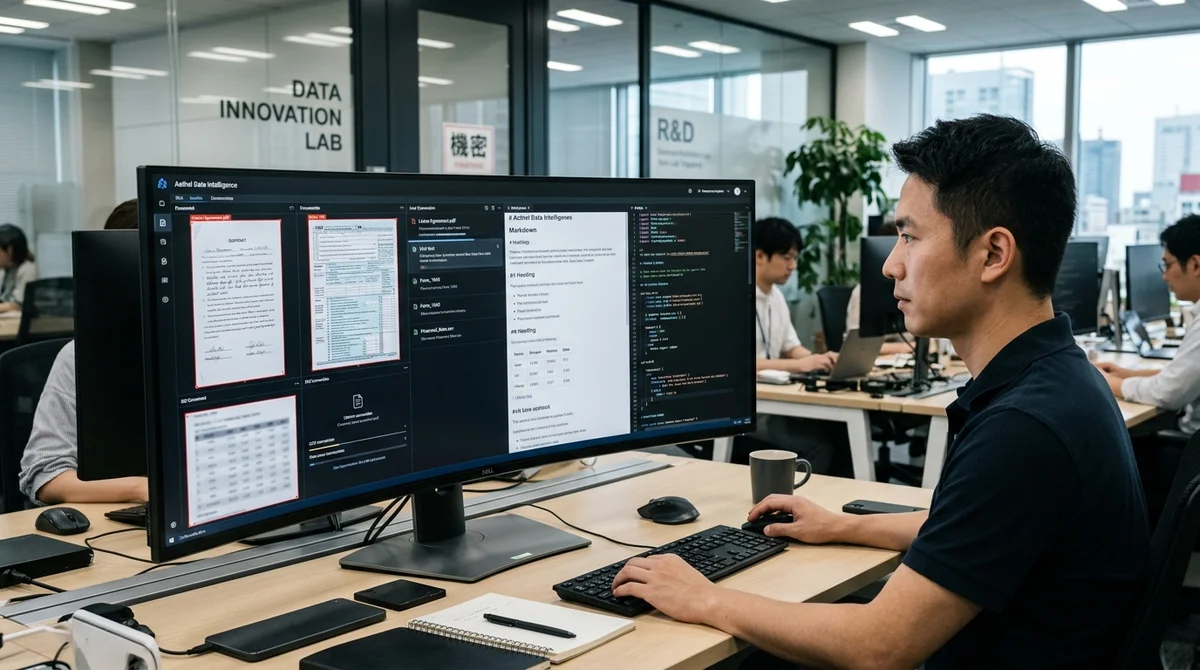
قدمت Baidu نموذج Qianfan-OCR، وهو نموذج موحد بحجم 4B للعمل مع المستندات، يجمع بين التعرف على النص وتحليل البنية وفهم المحتوى. وبدلاً من خط OCR التقليدي الذي يمر بعدة مراحل، يحوّل النظام صورة المستند مباشرة إلى Markdown منظّم، ويستطيع تنفيذ المهام التي يطلبها المستخدم.
لماذا يبتعد السوق عن خطوط OCR المتسلسلة
تتكوّن أنظمة OCR التقليدية عادةً من عدة وحدات مستقلة: إحداها تحدد المناطق في الصفحة، وأخرى تتعرف على النص، وثالثة تحاول فهم الجداول والعناوين وترتيب القراءة. ينجح هذا النهج ما دام المستند بسيطاً، لكنه يبدأ بالتعثر عند التخطيطات المعقدة، والمسوح الضوئية، والنماذج والاستمارات، والمحتوى المختلط، والتصاميم غير القياسية، والملفات متعددة الصفحات. وكلما زاد عدد الخطوات في السلسلة، ارتفع خطر أن يفسد خطأ في مرحلة مبكرة النتيجة كلها.
في هذا السياق، تراهن Baidu Qianfan على نهج موحد يجمع الرؤية واللغة (vision-language). ولا يُفترض بـ Qianfan-OCR أن تكتفي بقراءة الرموز، بل أن تتعامل مع المستند بوصفه كياناً متكاملاً: بكتله وبنيته ومنطقه ومعناه. وهذا تحول مهم للشركات، لأن ما يحتاجه العمل عادةً ليس النص بحد ذاته، بل بيانات جاهزة يمكن استخدامها لاحقاً في البحث والتحليلات والأتمتة وسيناريوهات الذكاء الاصطناعي الداخلية، بما فيها عمليات الإنتاج (production).
ما الذي يستطيع Qianfan-OCR فعله
بحسب وصف الفريق، هذا نموذج end-to-end بـ 4 مليارات معامل، يجمع تحليل المستند وتحليل التخطيط (layout analysis) وفهم المستند (document understanding) في بنية واحدة. والفارق الرئيسي عن OCR المألوف أن النموذج لا يعتمد على سلسلة طويلة من الوحدات المتصلة تتابعياً. بل يتلقى الصورة مدخلاً ويُخرج مباشرةً نتيجة منظّمة، تشمل التحويل من صورة إلى Markdown (image-to-Markdown). وهذا يقلل عدد التحويلات الوسيطة بشكل كبير.
ويبرز بشكل خاص المنطق القائم على الموجّه (prompt-driven). أي أن النموذج لا يقتصر استخدامه على التعرف الأساسي، بل يصلح أيضاً للمهام التطبيقية، حين يصوغ المستخدم ما الذي يريد استخراجه من المستند. وتذكر المادة صراحةً سيناريوهات استخراج الجداول والإجابة عن الأسئلة حول المستند. وهذا يقرّب OCR من أن يكون واجهة للتعامل مع الملفات المؤسسية داخل خطوط عمل الشركات، لا أداة أرشفة للمسوح الضوئية فحسب.
وصيغة Markdown مهمة هنا أيضاً. فالفرق التي تبني قواعد المعرفة أو البحث بالذكاء الاصطناعي أو خطوط المعالجة الموجهة لنماذج LLM لا يكفيها الحصول على نص بلا بنية. إنها تحتاج إلى عناوين وقوائم وجداول وترتيب منطقي للكتل. وإذا سلّم النموذج المستند مباشرةً بصيغة ملائمة للمعالجة الآلية، فإن ذلك يقلل حجم المعالجة اللاحقة، ويجعل النتيجة أنسب للفهرسة التلقائية والتلخيص وطبقة الأسئلة والأجوبة اللاحقة. وهذه ميزة ملحوظة من ناحية التكامل.
- تحويل صورة المستند مباشرةً إلى Markdown
- تحليل بنية الصفحة دون خط معالجة منفصل من عدة وحدات
- استخراج الجداول بناءً على طلب المستخدم
- الإجابة عن الأسئلة حول محتوى المستند
- نموذج واحد بدلاً من مجموعة مكونات متفرقة
أين يمكن الاستفادة منه
تكمن الفائدة العملية لمثل هذه النماذج في أنها تقلل العمليات الوسيطة بين المستند والإجراء المفيد. فإذا كان النظام يفهم التخطيط والنص والمعنى فهماً مستقراً في تمريرة واحدة، فإن ذلك يبسّط معالجة العقود والتعليمات والتقارير والاستبيانات والعروض التقديمية وقواعد المعرفة الداخلية. ويكتسب ذلك أهمية خاصة للفرق التي تريد تحويل ملفات PDF والمسوح الضوئية تلقائياً إلى صيغة مناسبة لـ RAG أو البحث في المعرفة أو التحليل اللاحق بواسطة LLM.
وثمة نقطة أخرى تهم المطورين وفرق المنتجات: التوحيد يخفض التعقيد الهندسي. فبدلاً من صيانة عدة خدمات OCR ومعالجة لاحقة (post-processing)، يمكن بناء حزمة أقصر. وهذا لا يضمن جودة مثالية على كل نوع من المستندات، لكن الاتجاه واضح: السوق يتحرك من مجموعة كواشف متخصصة إلى نماذج كبيرة تتعامل مع المستند بوصفه كياناً متعدد الوسائط، وتجهّزه فوراً للمهام اللاحقة (downstream)، كما تتيح إطلاق سيناريوهات جديدة بوتيرة أسرع.
ماذا يعني ذلك
يُظهر Qianfan-OCR أن OCR يتحول سريعاً من تقنية ضيقة للتعرف على الرموز إلى طبقة من ذكاء المستندات. وإذا أكدت هذه النماذج جودتها في السيناريوهات الواقعية، فسيصبح أسهل على الشركات أتمتة العمل مع المستندات دون خطوط معالجة معقدة متعددة المراحل ودون تجميع يدوي للمكونات المنفصلة. وسيكون المستفيد الأول هو الفرق التي تحتاج إلى انتقال سريع من ملفات PDF والمسوح الضوئية إلى بيانات جاهزة للبحث والتحليلات ومساعدي الذكاء الاصطناعي.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا يبتعد السوق عن خطوط OCR المتسلسلة؟
تتكوّن أنظمة OCR التقليدية عادةً من عدة وحدات مستقلة: إحداها تحدد المناطق في الصفحة، وأخرى تتعرف على النص، وثالثة تحاول فهم الجداول والعناوين وترتيب القراءة. ينجح هذا النهج ما دام المستند بسيطاً، لكنه يبدأ بالتعثر عند التخطيطات المعقدة، والمسوح الضوئية، والنماذج والاستمارات، والمحتوى المختلط، والتصاميم غير القياسية، والملفات متعددة الصفحات. وكلما زاد عدد الخطوات في السلسلة، ارتفع خطر أن يفسد خطأ في مرحلة مبكرة النتيجة كلها. في هذا السياق، تراهن Baidu Qianfan على نهج موحد يجمع الرؤية واللغة (vision-language). ولا يُفترض بـ Qianfan-OCR أن تكتفي بقراءة الرموز، بل أن تتعامل مع
ما أبرز التفاصيل حول ما الذي يستطيع Qianfan-OCR فعله؟
بحسب وصف الفريق، هذا نموذج end-to-end بـ 4 مليارات معامل، يجمع تحليل المستند وتحليل التخطيط (layout analysis) وفهم المستند (document understanding) في بنية واحدة. والفارق الرئيسي عن OCR المألوف أن النموذج لا يعتمد على سلسلة طويلة من الوحدات المتصلة تتابعياً. بل يتلقى الصورة مدخلاً ويُخرج مباشرةً نتيجة منظّمة، تشمل التحويل من صورة إلى Markdown (image-to-Markdown). وهذا يقلل عدد التحويلات الوسيطة بشكل كبير. ويبرز بشكل خاص المنطق القائم على الموجّه (prompt-driven). أي أن النموذج لا يقتصر استخدامه على التعرف الأساسي، بل يصلح أيضاً للمهام التطبيقية، حين يصوغ المستخدم ما الذي يري
ما أبرز التفاصيل حول أين يمكن الاستفادة منه؟
تكمن الفائدة العملية لمثل هذه النماذج في أنها تقلل العمليات الوسيطة بين المستند والإجراء المفيد. فإذا كان النظام يفهم التخطيط والنص والمعنى فهماً مستقراً في تمريرة واحدة، فإن ذلك يبسّط معالجة العقود والتعليمات والتقارير والاستبيانات والعروض التقديمية وقواعد المعرفة الداخلية. ويكتسب ذلك أهمية خاصة للفرق التي تريد تحويل ملفات PDF والمسوح الضوئية تلقائياً إلى صيغة مناسبة لـ RAG أو البحث في المعرفة أو التحليل اللاحق بواسطة LLM. وثمة نقطة أخرى تهم المطورين وفرق المنتجات: التوحيد يخفض التعقيد الهندسي. فبدلاً من صيانة عدة خدمات OCR ومعالجة لاحقة (post-processing)، يمكن بناء حزمة أ
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.