لماذا يخطئ GPT في عدّ الحروف: سرّ الترميز إلى رموز (Tokenization)
تعالج نماذج LLM النص بوصفه سلسلة من الرموز الرقمية (tokens) لا كحروف منفصلة. وهذا يفسّر مفارقة غريبة: قد يرتبك GPT بسهولة عند عدّ الحروف في كلمات بسيطة مثل strawberry. فهم آلية الترميز إلى رموز هو مفتاح كتابة prompts أكثر كفاءة، والتنبؤ بدقة بالسلوك الغريب للنماذج، وتحسين استخدام نافذة السياق، والتعامل مع النصوص متعددة اللغات.
معالج بواسطة الذكاء الاصطناعي من Habr AI؛ بتحرير Hamidun News
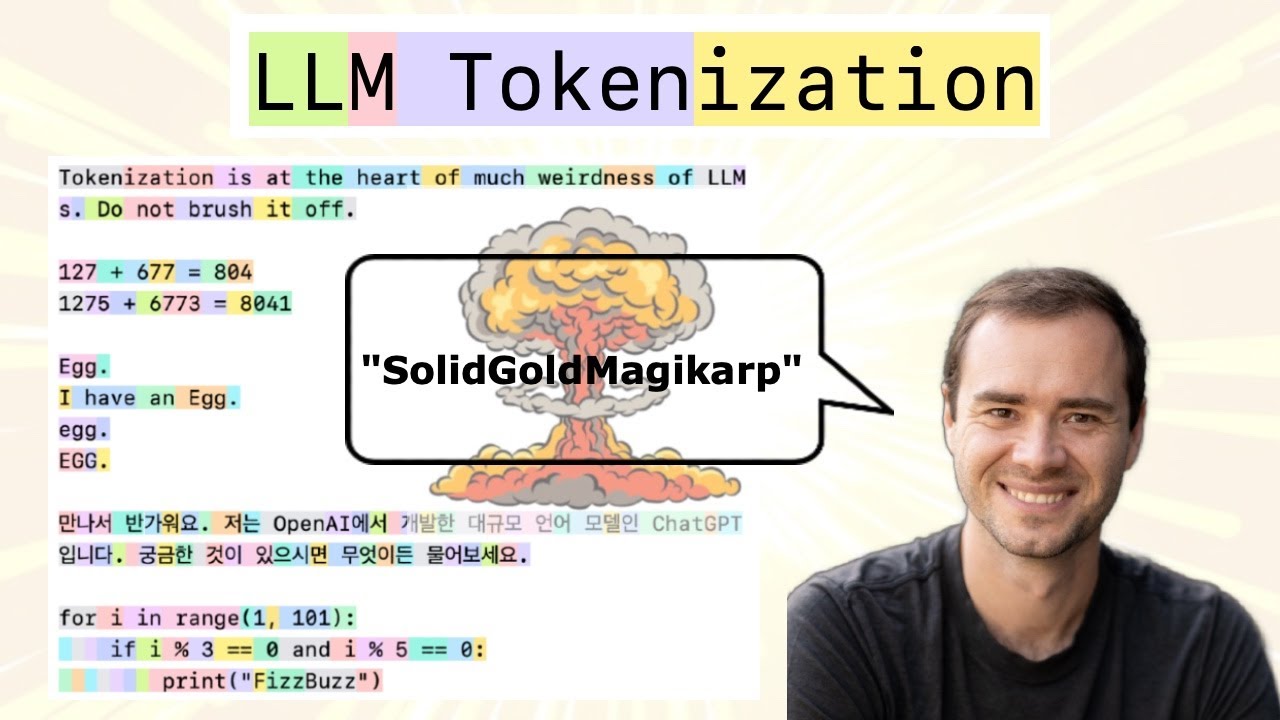
عندما تكتب prompt في ChatGPT، ترى نصًا عاديًا مؤلفًا من حروف. أما النموذج فيرى شيئًا مختلفًا تمامًا: سلسلة من الأرقام تُسمّى رموزًا (tokens). ويُنتج هذا التباين تأثيرات غريبة: فقد يعجز GPT عن معرفة عدد الحروف في كلمة strawberry، أو يرتبك في عملية عدّ بسيطة.
كيف ترى نماذج LLM النص
النص بالنسبة إلى الشبكات العصبية ليس مجموعة حروف، بل سلسلة من الرموز الرقمية. لكل رمز (token) رقم يقابله، والنموذج لا يتعامل إلا مع الأرقام ولا يرى الحرف نفسه أبدًا. الأمر أشبه بقراءة كتاب عبر نظام يحوّل الكلمات أولًا إلى أكواد، فتعالجونها، ثم تُحوَّل الأكواد مجددًا إلى نص.
قد تكون الكلمة الشائعة رمزًا واحدًا، بينما تُقسَّم الكلمة النادرة إلى عدة أجزاء. فمثلًا تُرمَّز «hello» برقم واحد، أما «strawberry» فقد تُرمَّز بثلاثة أو أربعة أرقام. وفي اللغة الروسية يزداد الوضع تعقيدًا، إذ تُقسَّم الكلمات بكفاءة أقل بسبب غنى الصرف فيها.
لماذا يسبّب هذا مشكلات
يؤدي الفارق بين طريقة رؤية البشر للنص وطريقة رؤية النموذج له إلى سلسلة من المشكلات:
- أخطاء في العدّ: لا يستطيع GPT عدّ الحروف ببساطة، لأنه يعمل بالأرقام لا بالرموز الحرفية
- صعوبة قراءة الكلمات النادرة: تُقسَّم تركيبات الحروف النادرة إلى عدة رموز، فيراها النموذج أجزاءً منفصلة
- اللاتناظر اللغوي: تُقسَّم الإنجليزية إلى رموز بكفاءة أعلى من الروسية أو الصينية أو العربية
- استهلاك السياق: إذا قُسّمت الكلمة إلى 3 رموز بدلًا من رمز واحد، يشغل الـ prompt مساحة أكبر في نافذة السياق
- سلوك غير متوقع: قد يتصرف النموذج بغرابة مع الأرقام والأكواد والأسماء النادرة، لأنها مقسّمة إلى أجزاء صغيرة
الخوارزمية خلف الكواليس
تقف خلف الترميز إلى رموز خوارزمية Byte Pair Encoding (BPE). وهذه آلية عملها: يُقسَّم النص أولًا بحيث يكون كل حرف رمزًا مستقلًا. ثم تبحث الخوارزمية عن أزواج الحروف الأكثر تكرارًا وتدمجها في رمز جديد. بعد ذلك تبحث عن الأزواج المتكررة من الرموز الناتجة وتدمجها من جديد. وتتكرر هذه العملية آلاف المرات.
وفي النتيجة يضم قاموس GPT نحو 50 ألف رمز. فالكلمات الشائعة وأجزاء الكلمات رموز مستقلة، أما تركيبات الحروف النادرة فتبقى مجزّأة. وهذا ليس مثاليًا، لكنه أكثر كفاءة من ترميز كل حرف على حدة.
ماذا يعني هذا
يغيّر فهم الترميز إلى رموز طريقة التعامل مع نماذج LLM. فإذا عرفت أن النموذج سيرتبك في عدّ الحروف، يمكنك أن تطلب منه العمل بطريقة مختلفة، كأن يطبع الحروف منفصلة أولًا ثم يعدّها. وهذا ليس حلًا سحريًا، لكنه يساعد على كتابة prompts أكثر موثوقية.
كما أن معرفة آلية الترميز مفيدة عند تحسين الـ prompts الطويلة، إذ يمكنك التنبؤ بالمواضع التي «سيهدر» فيها النموذج الرموز بلا طائل. وهذا مهم لكل من يعمل مع نماذج LLM على مستوى متعمّق، من مهندسي الـ prompts إلى مطوّري التطبيقات المبنية على الشبكات العصبية.
- 31 أكتوبر 2026مؤلف يعرض سيناريو على محكمة محلّفين من الذكاء الاصطناعي: الحكم كلّف 850 ألف توكن
- 31 أكتوبر 2026Anthropic: دمج الوكلاء الفرعيين في حلقة واحدة سرّع المهام لدى أحد العملاء إلى الضعف
- 30 أكتوبر 2026Claude Enterprise يحصل على تقارير ذكية: من يستخدم الذكاء الاصطناعي وكيف وبكم
- 29 أكتوبر 2026TokenRouter يسرّع التوجيه على مستوى الرمز بين النماذج حتى 64 ضعفًا
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف ترى نماذج LLM النص؟
النص بالنسبة إلى الشبكات العصبية ليس مجموعة حروف، بل سلسلة من الرموز الرقمية. لكل رمز (token) رقم يقابله، والنموذج لا يتعامل إلا مع الأرقام ولا يرى الحرف نفسه أبدًا. الأمر أشبه بقراءة كتاب عبر نظام يحوّل الكلمات أولًا إلى أكواد، فتعالجونها، ثم تُحوَّل الأكواد مجددًا إلى نص. قد تكون الكلمة الشائعة رمزًا واحدًا، بينما تُقسَّم الكلمة النادرة إلى عدة أجزاء. فمثلًا تُرمَّز «hello» برقم واحد، أما «strawberry» فقد تُرمَّز بثلاثة أو أربعة أرقام. وفي اللغة الروسية يزداد الوضع تعقيدًا، إذ تُقسَّم الكلمات بكفاءة أقل بسبب غنى الصرف فيها.
ما أبرز التفاصيل حول لماذا يسبّب هذا مشكلات؟
يؤدي الفارق بين طريقة رؤية البشر للنص وطريقة رؤية النموذج له إلى سلسلة من المشكلات: أخطاء في العدّ: لا يستطيع GPT عدّ الحروف ببساطة، لأنه يعمل بالأرقام لا بالرموز الحرفية صعوبة قراءة الكلمات النادرة: تُقسَّم تركيبات الحروف النادرة إلى عدة رموز، فيراها النموذج أجزاءً منفصلة اللاتناظر اللغوي: تُقسَّم الإنجليزية إلى رموز بكفاءة أعلى من الروسية أو الصينية أو العربية استهلاك السياق: إذا قُسّمت الكلمة إلى 3 رموز بدلًا من رمز واحد، يشغل الـ prompt مساحة أكبر في نافذة السياق سلوك غير متوقع: قد يتصرف النموذج بغرابة مع الأرقام والأكواد والأسماء النادرة، لأنها مقسّمة إلى أجزاء صغيرة
ما أبرز التفاصيل حول الخوارزمية خلف الكواليس؟
تقف خلف الترميز إلى رموز خوارزمية Byte Pair Encoding (BPE). وهذه آلية عملها: يُقسَّم النص أولًا بحيث يكون كل حرف رمزًا مستقلًا. ثم تبحث الخوارزمية عن أزواج الحروف الأكثر تكرارًا وتدمجها في رمز جديد. بعد ذلك تبحث عن الأزواج المتكررة من الرموز الناتجة وتدمجها من جديد. وتتكرر هذه العملية آلاف المرات. وفي النتيجة يضم قاموس GPT نحو 50 ألف رمز. فالكلمات الشائعة وأجزاء الكلمات رموز مستقلة، أما تركيبات الحروف النادرة فتبقى مجزّأة. وهذا ليس مثاليًا، لكنه أكثر كفاءة من ترميز كل حرف على حدة.
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.