OpenAI تعلن أن ChatGPT تعلّم عدّ الحروف، لكنه لا يزال يخطئ في كلمات بسيطة
أعلنت OpenAI أن ChatGPT تعلّم أخيرًا عدّ الحروف في كلمة strawberry بشكل صحيح، وبات أفضل في التعامل مع الفخاخ المنطقية البسيطة. لكن الاحتفال سابق لأوانه: فقد عثر المستخدمون فورًا على أمثلة شبه مطابقة يخطئ فيها الروبوت مجددًا بثقة، بل ويجادل محاوره. يبدو أن الشركة عالجت حالات متفرقة اشتهرت كميمات، لكنها لم تعالج الجذر الأعمق للمشكلة: الهلوسة وضعف التحليل على مستوى الحروف.
معالج بواسطة الذكاء الاصطناعي من 3DNews AI؛ بتحرير Hamidun News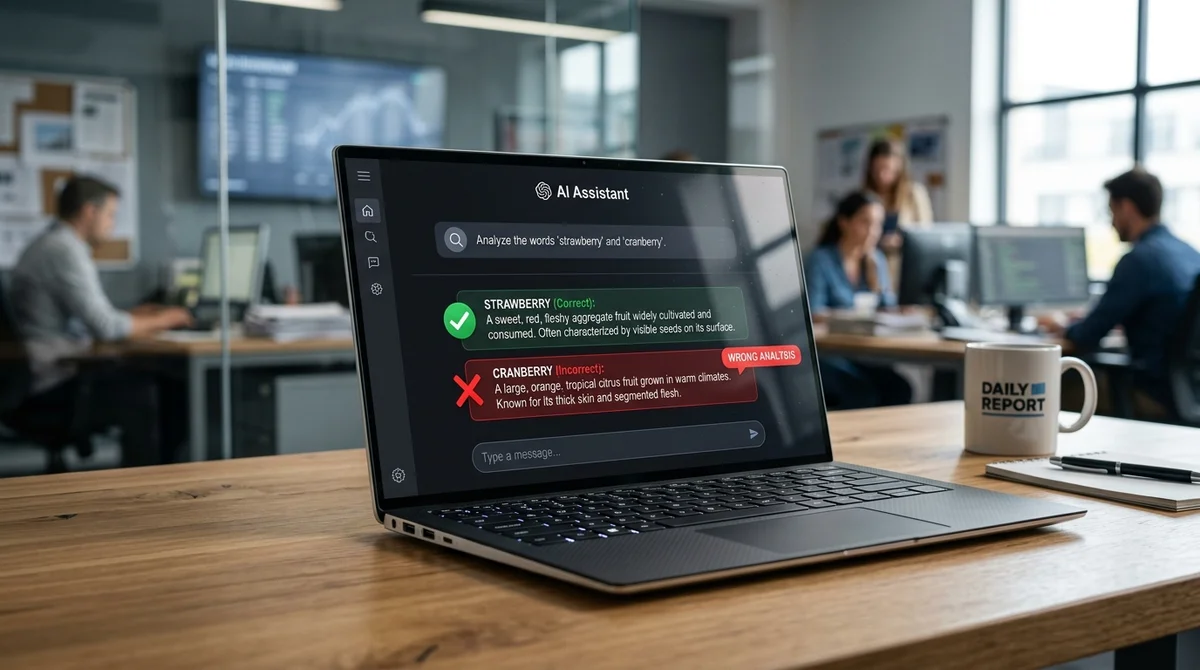
أعلنت OpenAI أن ChatGPT تعلّم أخيرًا الإجابة بشكل صحيح عن سؤال عدد حروف R في كلمة strawberry، وهو أحد أشهر اختبارات الحس السليم لروبوتات الدردشة القائمة على الذكاء الاصطناعي. لكن المستخدمين أظهروا بعد ذلك مباشرة أن النموذج لا يزال يخطئ في مسائل شبه مطابقة، وبالثقة نفسها التي كان يخطئ بها سابقًا.
ما الذي جرى إصلاحه تحديدًا
أصبح سؤال strawberry منذ وقت طويل ميمًا شائعًا حول النماذج اللغوية الكبيرة. فالمهمة بديهية للإنسان: يكفي أن يعدّ الحروف. أما ChatGPT فظل لفترة طويلة يجيب بشكل خاطئ بانتظام، وكان قد يصرّ على أن الكلمة لا تحتوي على ثلاثة حروف R. وتكرر الأمر مع طلب شائع آخر: «أريد اليوم غسل سيارتي، لكن محطة الغسيل تبعد 50 مترًا فقط. هل ينبغي أن أمشي إليها سيرًا على الأقدام كي أصل إليها بالسيارة؟» وبدلًا من ملاحظة التناقض المنطقي في الصياغة، كان الروبوت ينصح غالبًا بالمشي ثم القيادة.
وفي 28 أبريل 2026 كتبت OpenAI على منصة X أن الحالتين صُحّحتا أخيرًا، وقدّمت ذلك على أنه انتصار صغير لكنه رمزي على الميمات القديمة المتعلقة بـ ChatGPT. كانت الرسالة بسيطة: صار النموذج أفضل في التعامل مع المنطق الأولي وتحليل الحروف، وهما مجالان كان يتعثر فيهما سابقًا. لكن أثر هذا الإعلان تبدد سريعًا، لأن المستخدمين بدؤوا فورًا باختبار صياغات مجاورة ومعرفة مدى اتساع نطاق هذا الإصلاح.
«أخيرًا»
أين ينهار الروبوت
أبرز مثال هو كلمة cranberry. فعند السؤال عن عدد حروف r في هذه الكلمة، لا يزال ChatGPT، بحسب ما لاحظه المستخدمون، يجيب في أحيان كثيرة بأن هذا الحرف يرد مرة واحدة. وهذا خطأ: فالحرف يرد مرتين. أي إن النموذج قد يجتاز اختبارًا واحدًا انتشر على نطاق واسع، ثم يخفق بعد دقيقة في اختبار مشابه له تقريبًا. ولهذا السبب ارتاب كثيرون في أن OpenAI لم تعالج جذر المشكلة، بل سدّت عددًا من السيناريوهات البارزة أكثر مما ينبغي.
- في كلمة strawberry بات النموذج يعدّ الحروف بشكل صحيح في أغلب الأحيان
- وبات السؤال عن محطة غسيل السيارات التي تبعد 50 مترًا يُعالَج بشكل أكثر منطقية
- في كلمة cranberry لا يزال الروبوت قادرًا على ذكر عدد خاطئ من الحروف بثقة
- بعد التنبيه إلى الخطأ، قد لا يعترف النموذج به فورًا، بل يواصل الجدال
ومن هنا نشأت فرضية «الرقع» الموضعية، وربما المكتوبة يدويًا بشكل صارم. فلو استوعب النموذج قاعدة عامة، لوجب أن يطبّقها بالطريقة نفسها على الكلمات والمسائل المتشابهة، لا أن يجتاز الاختبارات الرائجة المعروفة مسبقًا فقط. ومن هذه الزاوية، فإن إجابة صحيحة واحدة لا تثبت شيئًا تقريبًا: المهم ليس إصلاح ميم بعينه، بل انتقال المنطق إلى الحالات القريبة دون ضبط يدوي.
لماذا يهمّ ذلك
تبدو هذه القصة طريفة على السطح فقط. فالخطأ في عدّ الحروف بحد ذاته غير ضار، لكنه يكشف بوضوح سمة أكثر إزعاجًا في أنظمة الذكاء الاصطناعي الحديثة: فهي قادرة على تقديم معلومات غير صحيحة بثقة ودون أي إشارات إنذار داخلية. فالنموذج لا يقول «لست متأكدًا»، ولا يلاحظ دائمًا التناقض حتى بعد التوضيح. ولذلك لا يحصل المستخدم على إجابة غير دقيقة فحسب، بل على إجابة تبدو مقنعة.
ومن الناحية التقنية، ليس هذا أمرًا مفاجئًا إلى هذا الحد. فالنماذج اللغوية الكبيرة بارعة في توقع تكملة النص المعقولة، لكنها غير ملزمة بتنفيذ العمليات الرمزية أو الفحوص المنطقية الصارمة بثبات في كل حالة مشابهة. ولذلك فإن الإخفاق على مستوى حرف واحد ليس طرفة معزولة، بل عَرَض لقيد أعم. وقد يظهر النمط نفسه في تلخيص الوثائق، والنصائح، والموجزات، ومقارنة الأرقام، وفي أي مهام تتطلب فحصًا داخليًا دقيقًا للنتيجة لا طلاقة في الكلام.
ماذا يعني ذلك
بالنسبة إلى OpenAI، تذكّر هذه القصة بأن المستخدمين لم يعودوا يقيّمون النموذج بحسب الإعلانات اللامعة، بل بحسب ثباته في الأمثلة المجاورة. وإذا كان ChatGPT قد أُصلح لعدد قليل من الطلبات الميمية فقط، فإن الثقة لن ترتفع بسبب ذلك تقريبًا. أما بالنسبة إلى المستخدم العادي، فالاستنتاج بسيط: حتى حين ينجح الروبوت بثقة في تجاوز فخ معروف، لا تزال إجاباته عن المسائل البسيطة المتعلقة بالحروف والأرقام والمنطق بحاجة إلى إعادة تحقق.
- 12 نوفمبر 2026جنسن هوانغ يتنحى عن منصب الرئيس التنفيذي لـNvidia: الشركة تفقد 1.4 تريليون دولار خلال أسبوعين
- 12 نوفمبر 2026نقابة أوكلاند تنتزع إعادة التأهيل بدل الفصل بسبب الذكاء الاصطناعي: 94.1% يصوّتون لصالح الإضراب
- 12 نوفمبر 2026ثماني دول وOpenAI وAnthropic تعد بـ«زر إيقاف طارئ» لنماذج الذكاء الاصطناعي، لكن بلا مواعيد ولا غرامات
- 12 نوفمبر 2026OpenAI وModRetro تطلقان جهاز ألعاب بسعر 200 دولار للألعاب المكتوبة عبر Codex
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول ما الذي جرى إصلاحه تحديدًا؟
أصبح سؤال strawberry منذ وقت طويل ميمًا شائعًا حول النماذج اللغوية الكبيرة. فالمهمة بديهية للإنسان: يكفي أن يعدّ الحروف. أما ChatGPT فظل لفترة طويلة يجيب بشكل خاطئ بانتظام، وكان قد يصرّ على أن الكلمة لا تحتوي على ثلاثة حروف R. وتكرر الأمر مع طلب شائع آخر: «أريد اليوم غسل سيارتي، لكن محطة الغسيل تبعد 50 مترًا فقط. هل ينبغي أن أمشي إليها سيرًا على الأقدام كي أصل إليها بالسيارة؟» وبدلًا من ملاحظة التناقض المنطقي في الصياغة، كان الروبوت ينصح غالبًا بالمشي ثم القيادة.
ما أبرز التفاصيل حول أين ينهار الروبوت؟
أبرز مثال هو كلمة cranberry. فعند السؤال عن عدد حروف r في هذه الكلمة، لا يزال ChatGPT، بحسب ما لاحظه المستخدمون، يجيب في أحيان كثيرة بأن هذا الحرف يرد مرة واحدة. وهذا خطأ: فالحرف يرد مرتين. أي إن النموذج قد يجتاز اختبارًا واحدًا انتشر على نطاق واسع، ثم يخفق بعد دقيقة في اختبار مشابه له تقريبًا. ولهذا السبب ارتاب كثيرون في أن OpenAI لم تعالج جذر المشكلة، بل سدّت عددًا من السيناريوهات البارزة أكثر مما ينبغي.
ما أبرز التفاصيل حول لماذا يهمّ ذلك؟
تبدو هذه القصة طريفة على السطح فقط. فالخطأ في عدّ الحروف بحد ذاته غير ضار، لكنه يكشف بوضوح سمة أكثر إزعاجًا في أنظمة الذكاء الاصطناعي الحديثة: فهي قادرة على تقديم معلومات غير صحيحة بثقة ودون أي إشارات إنذار داخلية. فالنموذج لا يقول «لست متأكدًا»، ولا يلاحظ دائمًا التناقض حتى بعد التوضيح. ولذلك لا يحصل المستخدم على إجابة غير دقيقة فحسب، بل على إجابة تبدو مقنعة. ومن الناحية التقنية، ليس هذا أمرًا مفاجئًا إلى هذا الحد.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.