Локальные LLM
Локальные LLM — это языковые модели, которые работают прямо на вашем железе: ноутбуке, ПК с видеокартой или домашнем сервере — без облака, подписок и передачи данных наружу. Ollama, llama.cpp и LM Studio плюс квантованные GGUF-версии Llama, Qwen и Gemma делают это доступным даже на видеокарте десятилетней давности. Здесь — все наши материалы о локальном запуске ИИ: гайды, тесты железа, квантизация и приватность.
Как ИИ помогает писать unit-тесты: кейс Wildberries
Тимлид мобильной команды Wildberries рассказал, как после двух месяцев настройки OpenCode, RAG и сабагентов локальная модель начала генерировать рабочие unit-тесты…
Habr AI назвал шесть локальных нейросетей 2026 года для автономной работы без интернета
Habr AI выпустил обзор шести локальных нейросетей, которые после установки могут работать офлайн и дают пользователю запасной AI-инструмент на случай сбоев связи…
Мультимодальные нейросети для видео: тренды WACV 2026
Репортаж с WACV 2026 в Тусоне зафиксировал главные сдвиги в Computer Vision: мультимодальные модели, синтетические данные, более экономные вычисления и сильные…
Tesla получила первое в Европе разрешение на FSD Supervised — старт из Нидерландов
Google Gemma 4 заставила компании пересматривать контроль AI на локальных устройствах
OpenGrall показал режим «Инженера»: робот сам пишет драйверы и настраивает модули
Google случайно показала в Play Маркете ИИ-помощника COSMO и быстро скрыла приложение
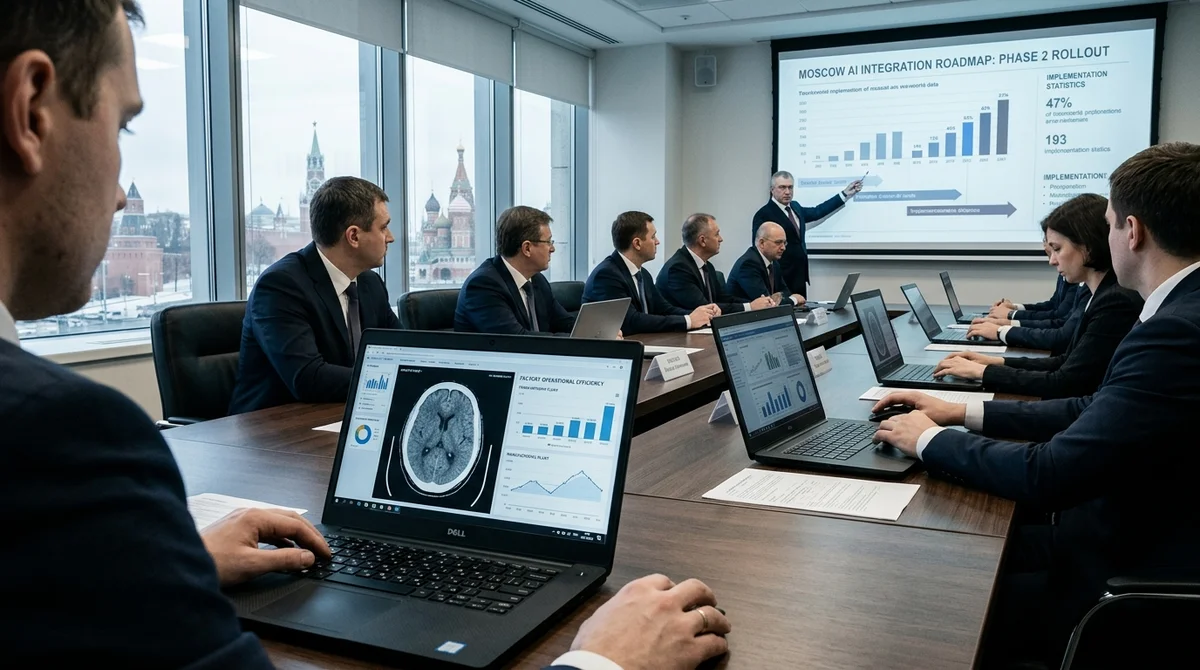
Путин поручил госплан по ИИ, а российский бизнес закрывает 90% пилотов
Россия одновременно ужесточает курс на ИИ: власти готовят национальный план и правила для нейросетей, регионы масштабируют медсервисы, а 90% корпоративных пилотов…
OpenCode, Ollama и Qwen3-Coder: как запустить локального ИИ-кодера без облака и лимитов
Связка OpenCode, Ollama и Qwen3-Coder позволяет развернуть локального ИИ-помощника для программирования прямо на своём компьютере — бесплатно, офлайн и без лимитов…
KDnuggets опубликовал гайд по локальному анализу звонков с Whisper, BERTopic и Streamlit
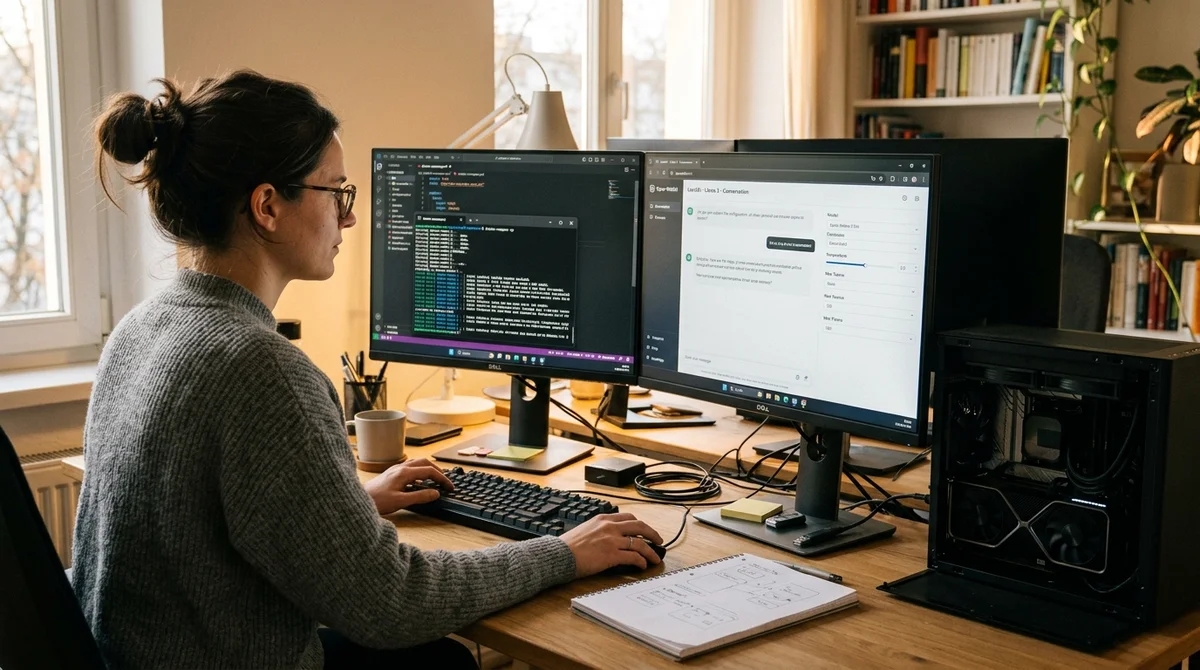
Open WebUI и llama.cpp: как настроить локальный веб-поиск с Qwen и Docker на Windows
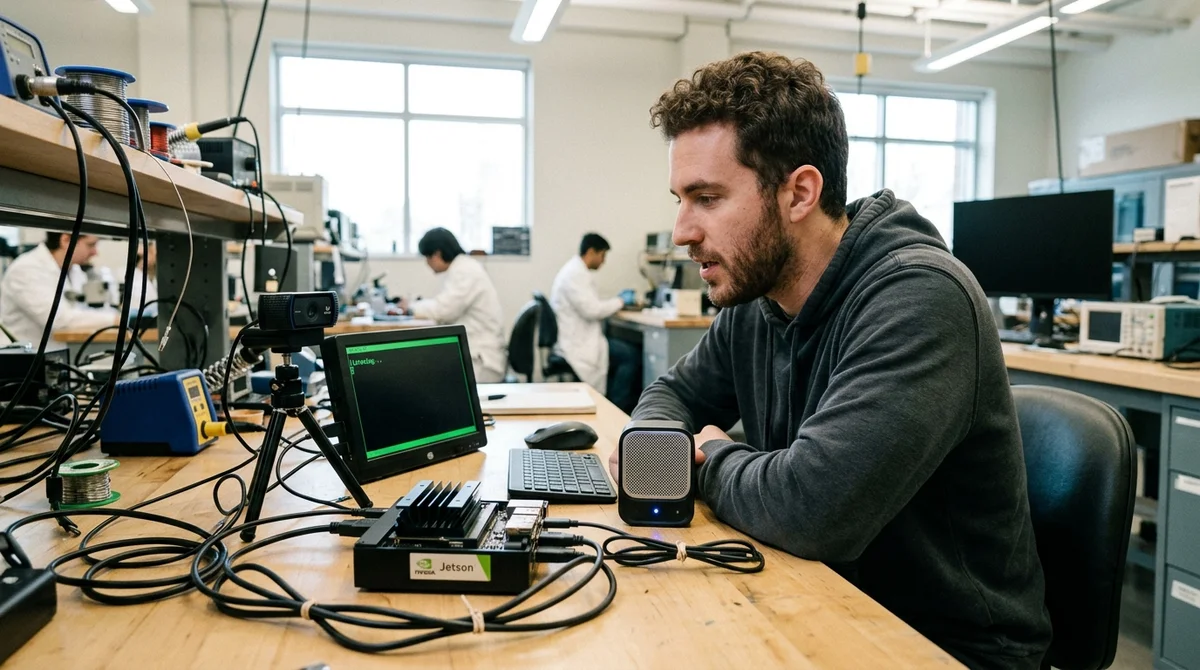
NVIDIA показала, как Gemma 4 с голосом и веб-камерой работает на Jetson Orin Nano Super
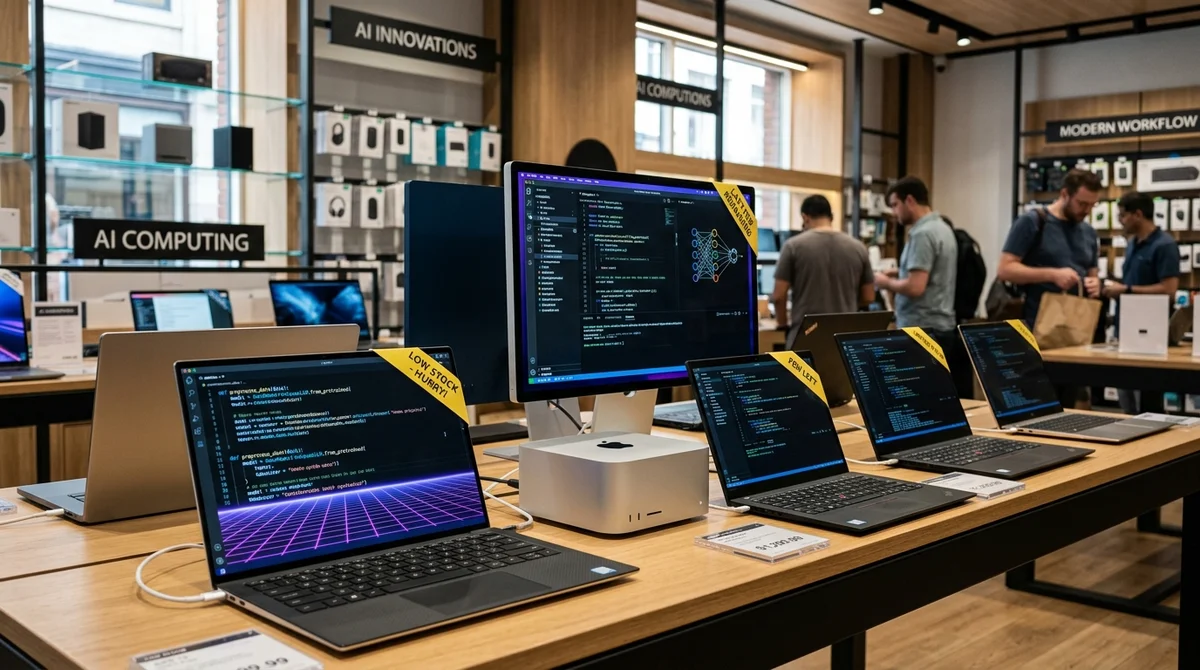
Apple недооценила спрос на Mac для ИИ: Mac mini, Studio и Neo уходят в дефицит
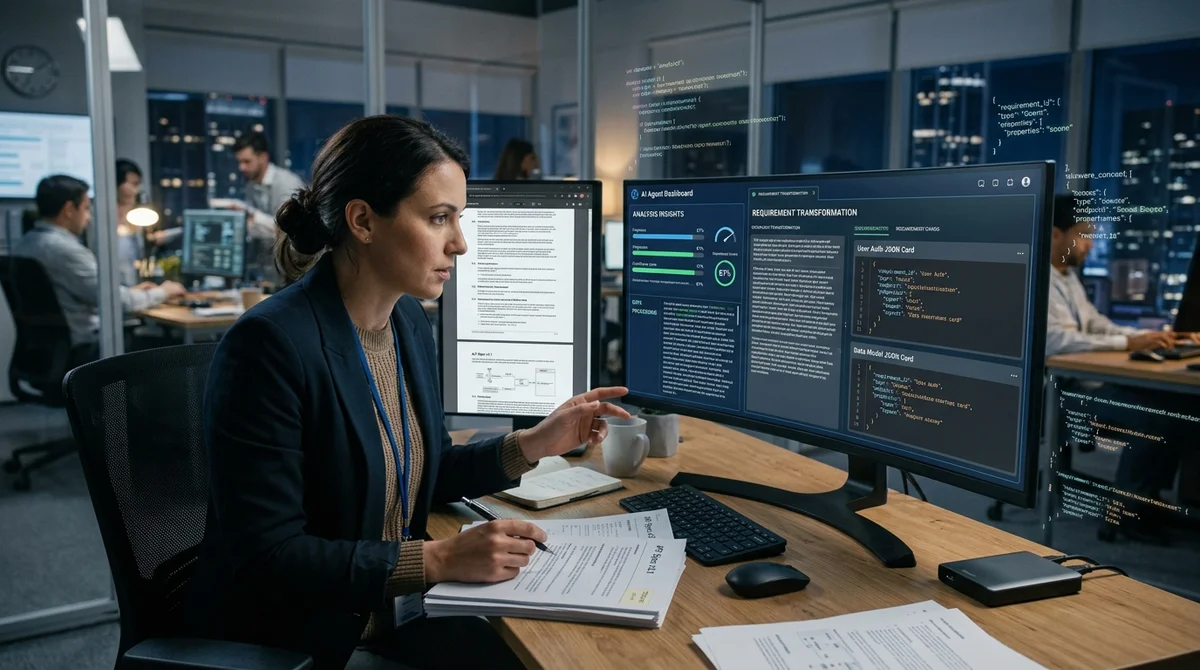
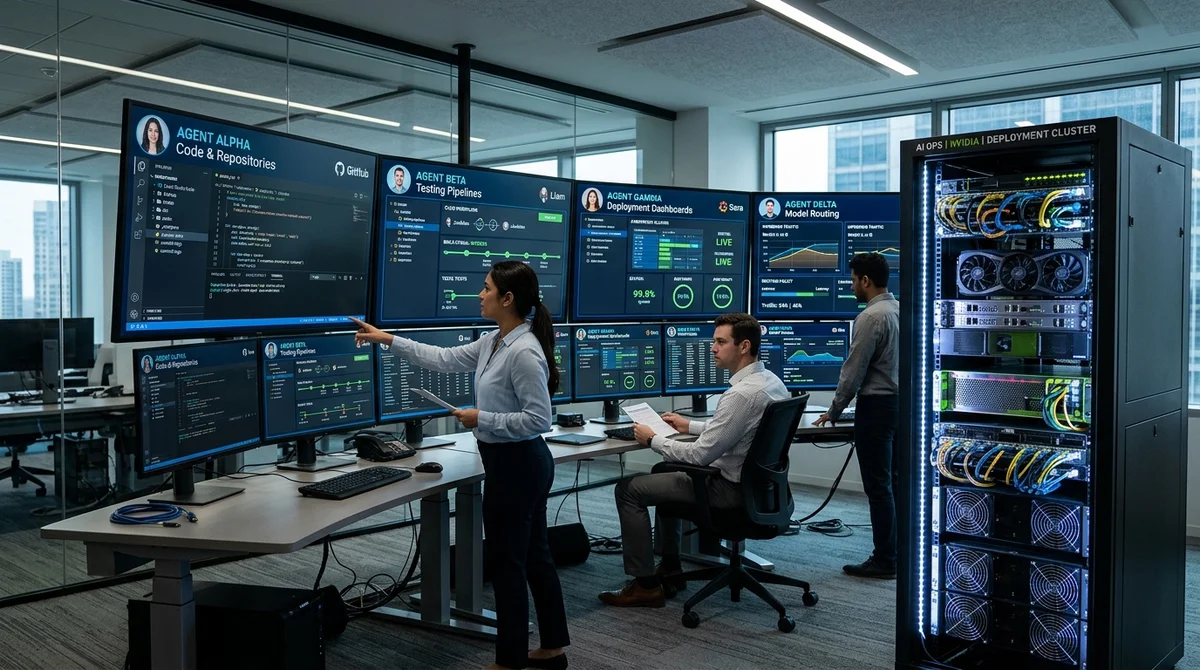
Open-source-стек из 6 моделей и 9 агентов показал, как собрать ИИ-команду на одном сервере
Шесть open-source-моделей и девять агентов на одном GPU-сервере образуют автономную AI-команду, которая сама проектирует, пишет, тестирует и деплоит новых агентов.
GLiNER 2 показал, как компактные энкодеры догоняют LLM в NER и классификации
Новая волна zero-shot энкодеров во главе с GLiNER 2 показывает, что задачи NER и классификации можно решать без тяжёлых LLM — быстрее, дешевле и с понятным…