NVIDIA показала, как Gemma 4 с голосом и веб-камерой работает на Jetson Orin Nano Super
NVIDIA собрала локальное демо Gemma 4 для Jetson Orin Nano Super: модель слушает голос, при необходимости сама обращается к веб-камере и отвечает через TTS. В связке используются Parakeet для распознавания речи, Kokoro для синтеза и llama.cpp с vision projector. Главный эффект — мультимодальный агент работает на компактной плате с 8 ГБ памяти без обязательного облака.
AI-обработка оригинала Hugging Face Blog; редакция Hamidun News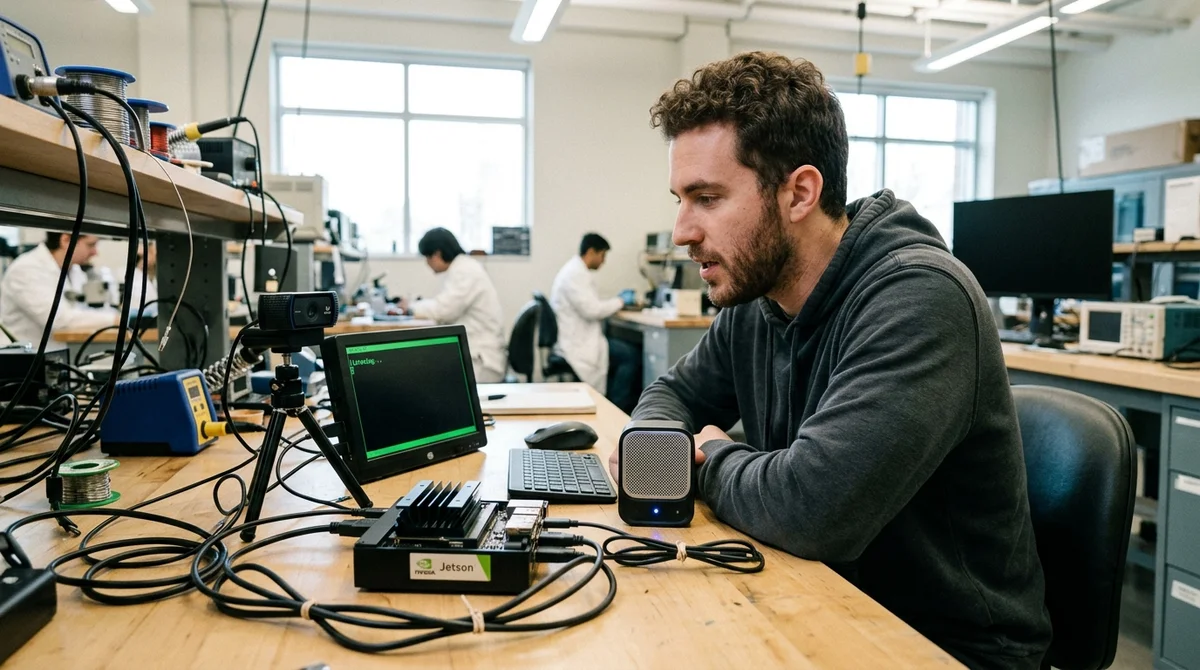
NVIDIA показала практичное edge-демо: Gemma 4 умеет слушать вопрос, при необходимости сама обращается к веб-камере и отвечает голосом — всё это локально на Jetson Orin Nano Super с 8 ГБ памяти. Публикация от 22 апреля 2026 года интересна не только самим туториалом, но и тем, что мультимодальный агент запускается на компактной плате, а не в облаке.
Как работает связка Сценарий собран как простой голосовой агент с одним визуальным инструментом.
Пользователь нажимает пробел, задаёт вопрос голосом, после чего Parakeet локально переводит речь в текст. Затем Gemma 4 получает запрос и сама решает, нужен ли ей взгляд через веб-камеру. Если да, скрипт делает кадр, передаёт его модели, а ответ затем озвучивается через Kokoro TTS. В статье отдельно подчёркивается, что модель не описывает картинку вообще, а использует увиденное только для ответа на конкретный вопрос.
«Честно говоря, впечатляет уже то, что это работает на Jetson Orin Nano».
Ключевой момент в том, что здесь нет жёстких триггеров и ручной логики вида «если в вопросе есть слово camera». Скрипт открывает для Gemma 4 ровно один tool — look_and_answer, который делает снимок и анализирует сцену. Вызывать его или нет, модель решает сама. Для этого NVIDIA использует llama-server из llama.cpp с флагом --jinja, который включает нативную поддержку tool calling. По сути, это компактный VLA-сценарий, где vision подключается только тогда, когда действительно нужен.
Что нужно для запуска Само демо не выглядит магией из коробки: это скорее хорошо собранная
инструкция для энтузиастов и разработчиков, которые хотят повторить локальный мультимодальный пайплайн у себя. NVIDIA описывает не только запуск Python-скрипта, но и весь стек — от системных пакетов и сборки llama.cpp до настройки аудио, камеры и загрузки vision projector для Gemma 4.
- Jetson Orin Nano Super с 8 ГБ памяти, веб-камера, USB-микрофон или камера со встроенным микрофоном, USB-колонки и клавиатура Python-окружение с
opencv-python-headless,onnx_asr,kokoro-onnx,soundfile,huggingface-hubиnumpyЛокально собранныйllama.cppс CUDA, модельgemma-4-E2B-itв GGUF и отдельный файлmmproj, без которого Gemma 4 не сможет видеть НастройкаMIC_DEVICE,SPK_DEVICE,WEBCAMиVOICE, после чего демо запускается одной командойpython3 Gemma4_vla.pyОтдельный текстовый режим через Docker, если хочется быстро проверить LLM-часть без полной визуальной конфигурации Отдельный акцент сделан на памяти. Плата с 8 ГБ справляется, но автор прямо советует освободить RAM, отключить лишние процессы и даже добавить swap, чтобы не поймать OOM при загрузке модели. Базовым вариантом назван квантованныйQ4_K_M, а при совсем жёстких ограничениях можно опуститься доQ3. Это важная деталь: речь не о полированном потребительском продукте, а о рабочем рецепте, где каждый гигабайт реально влияет на результат.
Почему это интересно Новость здесь не в том, что
Gemma 4 можно запустить на Jetson — это само по себе ожидаемо для облегчённых сборок. Важнее другое: NVIDIA показывает практический шаблон локального мультимодального агента, который объединяет STT, LLM, tool calling, vision и TTS без обязательного обращения к облаку. Для edge-устройств это сильный сигнал.
Раньше подобные сценарии чаще ассоциировались либо с сервером, либо с сильно урезанными демо, где модель просто отвечает на текст. При этом инструкция честно показывает ограничения. Первый запуск медленный, потому что подтягиваются модели и генерируются голосовые файлы.
Полноценный VLA-режим требует нативной сборки и vision projector, а Docker-вариант годится только для текста. Если серверу не хватает памяти, приходится вручную чистить систему. NVIDIA также не приводит в статье бенчмарки по скорости и не показывает видео с реальной задержкой, так что до готового ассистента для всех здесь ещё далеко.
Но как демонстрация направления это очень сильный кейс.
Что это значит Локальные AI-агенты становятся ближе к практическому использованию на недорогом железе.
Для разработчиков это означает возможность собирать приватные голосовые интерфейсы и мультимодальные прототипы без обязательной облачной инфраструктуры. Для рынка edge AI это ещё один шаг от красивых презентаций к системам, которые можно реально поднять на столе, проверить и встроить в продукт.
- 2 нояб. 2026 г.NVIDIA выпустила Nemotron 3.5 Bolt E4B на 4 ГБ и 133 токена в секунду на RTX 5070
- 2 нояб. 2026 г.Cosmos сгенерировал обучающее видео для дронов: mAP@50–95 детектора выросла на 10,3%
- 2 нояб. 2026 г.Anthropic должна растить выручку на 32% в год, чтобы покрыть контракты на $850 млрд
- 2 нояб. 2026 г.TensorFold 1.2.0 поднял пропускную способность Qwen3.8-27B на M3 Ultra на 44,2% при 16 потоках
Протестируйте новые LLM и мультимодальные модели в одном окне
Платформа Nomad AI (nomadnet.ai) даёт прямой доступ к Claude Opus 5.5, GPT-6, Gemini 3.1, DeepSeek и автономным агентам без VPN, зарубежных карт и зоопарка подписок.
Главное из мира ИИ — раз в неделю
7 ключевых событий недели, отобранных вручную. Без шума, репостов и пресс-релизов.
Готово! Проверьте почту — мы отправили подтверждение.