Локальные LLM
Локальные LLM — это языковые модели, которые работают прямо на вашем железе: ноутбуке, ПК с видеокартой или домашнем сервере — без облака, подписок и передачи данных наружу. Ollama, llama.cpp и LM Studio плюс квантованные GGUF-версии Llama, Qwen и Gemma делают это доступным даже на видеокарте десятилетней давности. Здесь — все наши материалы о локальном запуске ИИ: гайды, тесты железа, квантизация и приватность.
Ollama и Open WebUI на VPS без GPU: честный разбор ограничений
Запуск локального LLM на простом сервере — работает, но скорость страдает и нужно выбирать модели под железо.
Дефицит памяти для AI расслаивает рынок чипов на лидеров и аутсайдеров
Глобальная нехватка памяти-чипов из-за AI-бума расширяет пропасть между корпорациями: одни растут, другие теряют позиции.
Deepseek-agent: как написать свой Claude Code за 2000 строк кода
Разработчик создал полнофункциональный аналог Claude Code для DeepSeek с поддержкой tool use, permissions и memory. Всего 2000 строк Node.js кода и 4 зависимости…
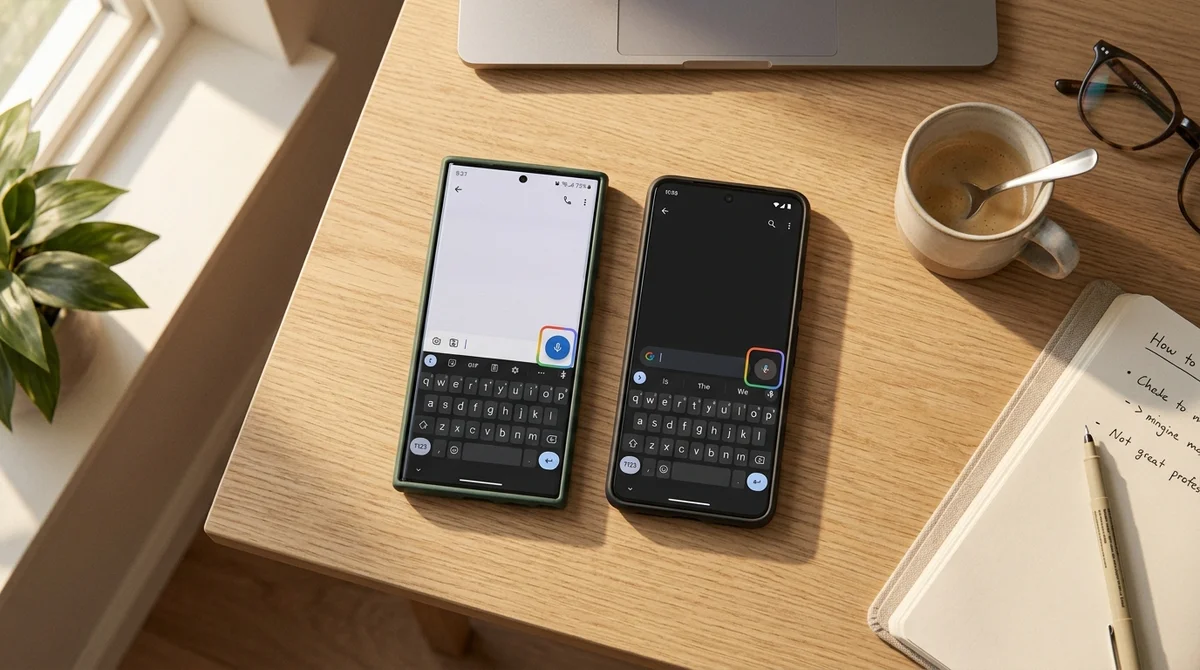
Google встроила Gemini-диктовку в Gboard и создаёт угрозу стартапам
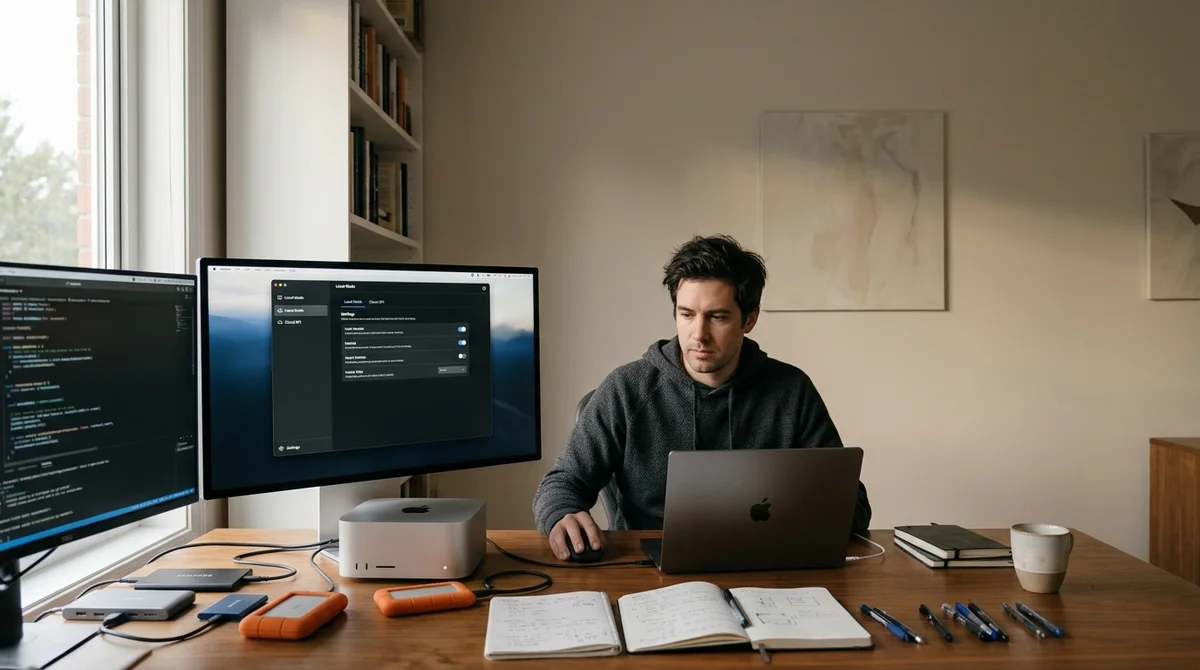
Osaurus выпустила Mac-приложение, где локальные и облачные AI-модели работают вместе
Правительство России предложило обучать ИИ на авторских материалах без согласия
Нейросеть для распознавания объектов на планшете: F1-score 94% за 20 мс
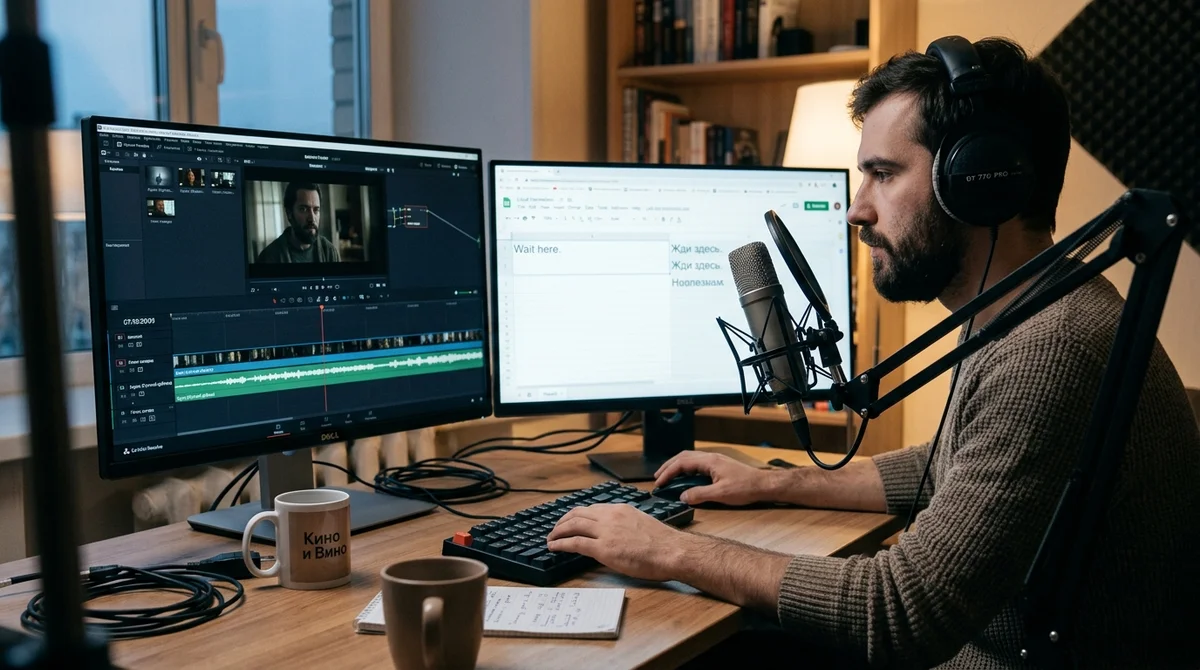
Нейросеть для видео: как Ollama автоматизирует перевод и переозвучку
Разработчик решил автоматизировать перевод и переозвучку YouTube-видео с локальными моделями Ollama, собрав для этого связку из CLI, desktop-интерфейса и…
Внедрение ИИ: как дать нейросети долгую память с онтологиями
Habr AI объясняет, почему следующим шагом после RAG должна стать онтологическая память: она помогает LLM удерживать контекст, усиливает локальные модели и делает…
Нейросеть для текста deepvk vs OpenAI: бенчмарк на судебных актах
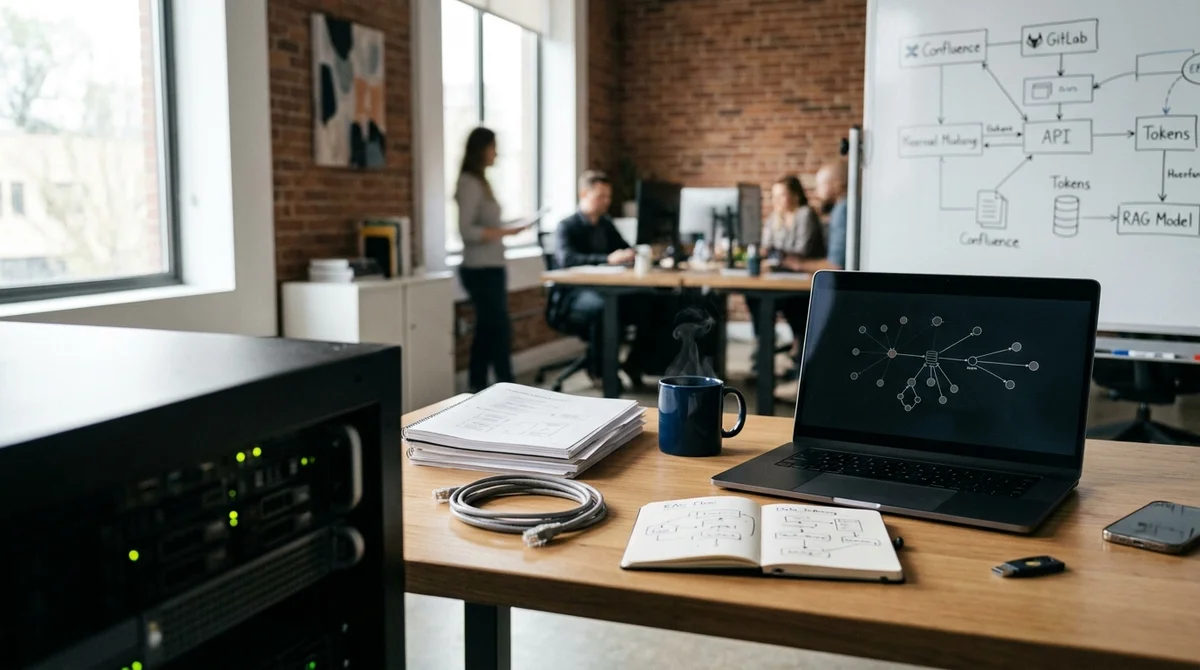
Как внедрить ИИ для поиска документов: опыт Рунити
Почему ChatGPT и другие чат-боты не место для секретов: 5 рисков и что делать после утечки
Армянские банки дадут Firebird AI рекордный синдицированный кредит на $300 млн
Как собрать RAG-ретривер для точного поиска имён в LangChain
Habr AI выпустил практический разбор о том, как собрать кастомный RAG-ретривер на TF-IDF и LangChain для кейсов, где векторный поиск хуже работает с именами…
Ollama ускорила локальное ИИ на Mac с Apple M5: запускай нейросеть без облака
В Ollama 0.19 появился MLX-бэкенд для Apple M5, M5 Pro и M5 Max: локальные модели и кодовые агенты отвечают быстрее, но для ускорения нужен Mac с 32 Гбайт…